幻尔机器鸭WonderDuck:强化学习驱动双足机器人自主行走的技术路径
声明:文档由AI根据原文生成。
强化学习让机器鸭自主学会行走
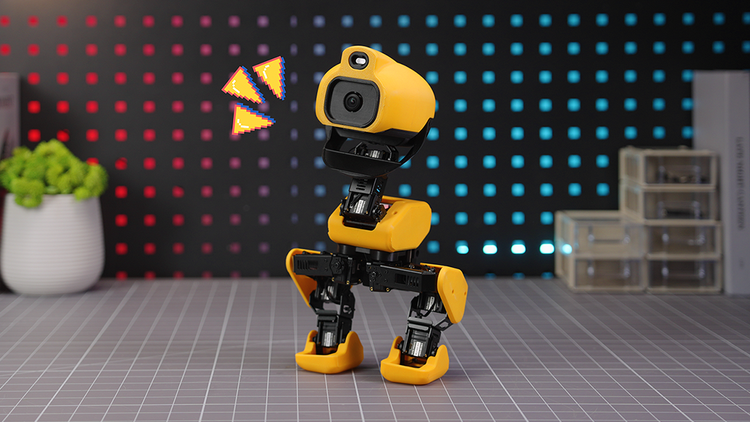
一只鸭子学会走路是寻常事,但机器鸭没有天生的运动能力,抬腿、迈步、保持平衡均需多关节协同,还需实时调整动作以应对不同状态。深圳幻尔科技旗下开源双足机器人WonderDuck采用强化学习技术,通过仿真建模、目标设定、奖惩引导和反复试错,让机器鸭逐步学习运动策略,最终将训练成果应用于真实硬件。
孪生建模:在虚拟世界复制机器鸭
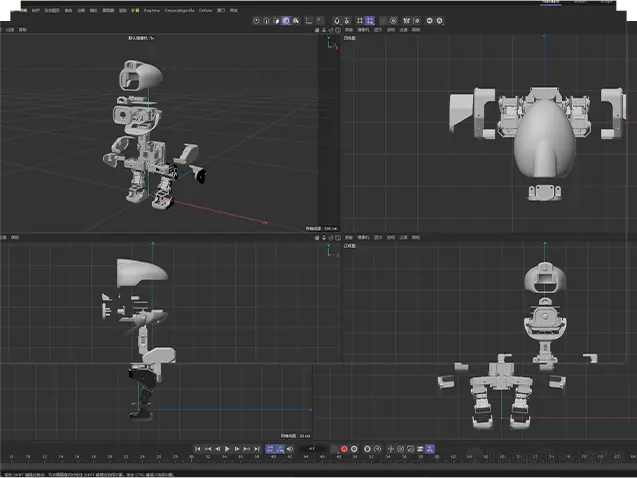
AI需先知晓所控机器人的物理属性。开发者依据真实机器鸭的机械结构、关节参数、质量分布等信息,在计算机中构建1:1数字孪生仿真模型。WonderDuck的仿真模型对应真实机器鸭的15自由度机械结构及各关节运动参数、整体质量分布。建模完成后,AI即可在虚拟环境中控制机器鸭尝试不同动作,避免真实设备承担初期大量试错。
搭建环境:创造虚拟训练场
WonderDuck采用MuJoCo物理仿真引擎搭建训练环境,模拟重力、摩擦、碰撞等物理效应,使虚拟机器鸭执行动作后反馈相应运动状态。同时需定义机器人的观测空间与动作空间:观测空间决定AI可获取的信息,如当前姿态和关节状态;动作空间决定AI可控的关节及调整方式。两者共同构成机器人与仿真环境交互的基础。
设定目标:明确训练任务
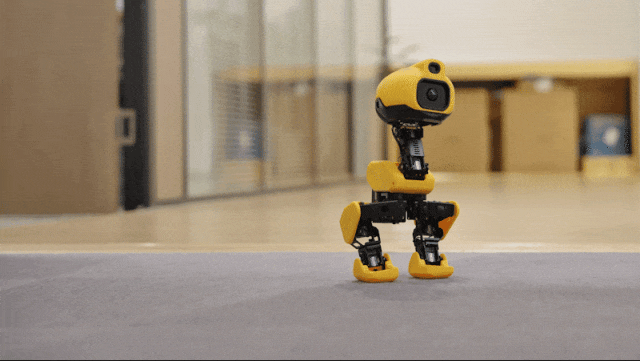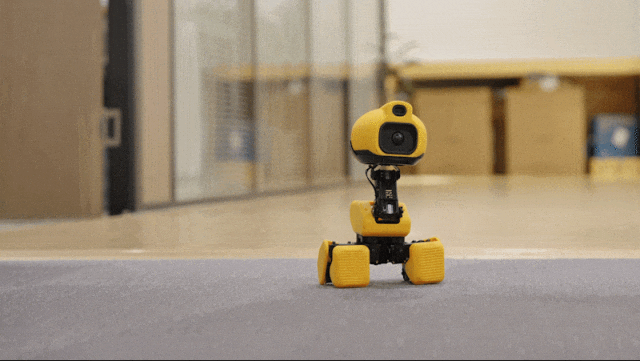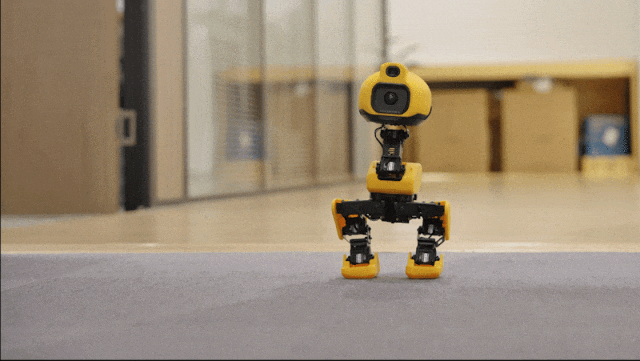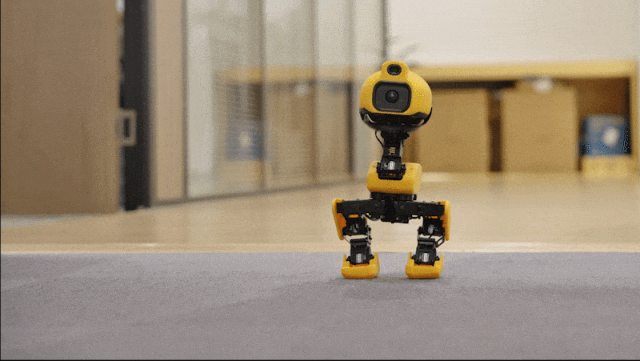
训练需有明确方向。WonderDuck的核心目标包括稳定前行、保持身体平衡和协调动作,训练任务覆盖行走、自主站起等多种运动能力。行走任务中,系统引导机器人向目标方向移动,兼顾身体姿态和运动表现;自主站起任务则要求机器人学习从倒地状态恢复站立。不同任务对应不同训练目标,决定后续奖励函数的设计方向。
奖惩引导:建立行为评价规则
强化学习的奖励函数是一套行为评价规则:机器人执行动作后,系统根据结果给予奖励或惩罚,AI据此调整策略。WonderDuck行走训练中,向前位移、保持良好身体姿态等行为获得正向奖励;摔倒、关节超限、异常抖动等则受到负向惩罚。AI初始并不知晓如何行走,通过不断执行动作、接收反馈,逐渐学习哪些动作组合更有利于完成目标。奖励函数的设计直接影响AI最终习得的运动策略。
海量试错:并行训练与域随机化
WonderDuck基于PPO(近端策略优化)算法开展强化学习训练。AI根据当前策略执行动作,仿真环境反馈运动结果,算法再根据奖励信息更新策略,此过程循环往复。初期机器鸭难以保持平衡,常迈出几步即摔倒,动作亦不协调;但每次尝试均产生新反馈,帮助AI调整下一轮策略。
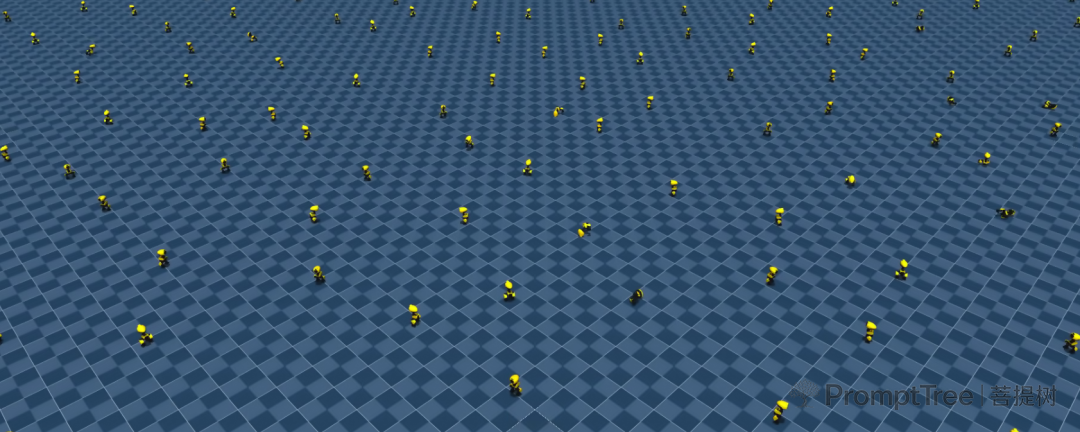
为提高训练效率,WonderDuck采用百路并行训练,并引入域随机化技术,在仿真过程中随机调整部分环境参数,使AI接触更多不同训练条件,增强策略对环境变化的适应能力。训练单日可完成数百万次跌倒试错,通过大量重复,AI逐渐摸索出更符合目标要求的运动方式。
策略收敛:导出可部署模型
训练表现趋于稳定后,即可导出策略进行部署准备。WonderDuck支持将训练好的策略模型导出为ONNX格式,并进行轻量化优化以适配端侧运行。但模型训练完成不代表机器人已能在真实世界行走,仍需部署至真实机器鸭上验证。
真机部署:仿真到现实的迁移
真实机器鸭由主控系统执行策略推理,通过底层控制系统驱动舵机完成动作。WonderDuck采用自研RK3566与AT32异构双脑架构:RK3566负责强化学习策略推理等上层任务,AT32负责IMU数据采集、舵机总线控制等底层实时任务,支持50Hz控制环路。
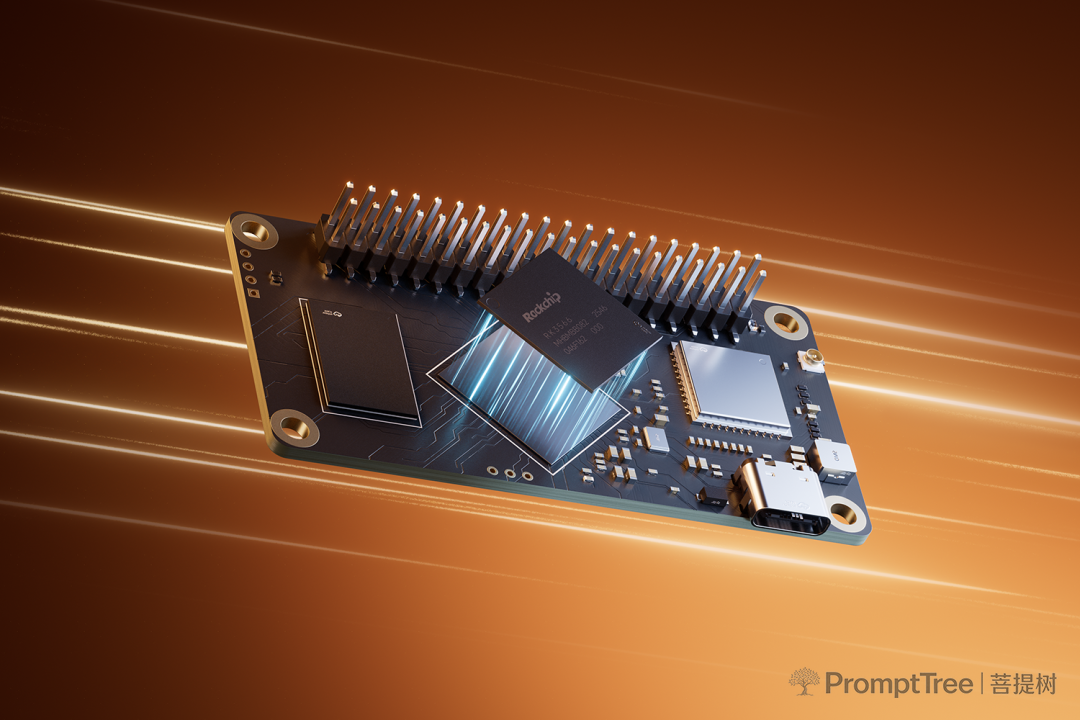
至此完成从仿真训练到真实硬件执行的Sim-to-Real(仿真到现实)迁移。但仿真环境与真实世界存在差异,真实地面的摩擦、关节响应和外部干扰均可能影响策略表现,故模型部署后需经测试与调整。
持续优化:真机反馈驱动迭代
真机部署并非训练终点。真实机器人运行数据可帮助发现仿真与实际运动的差异,通过采集真机运动数据、反向校准仿真参数、迭代模型和控制策略,进一步改善运动表现。此过程形成持续循环:仿真训练→策略导出→真机部署→数据采集→参数校准→新一轮训练。真实环境遇到的问题成为下一轮训练参考,运动策略得以不断优化。
开源平台与开发工具
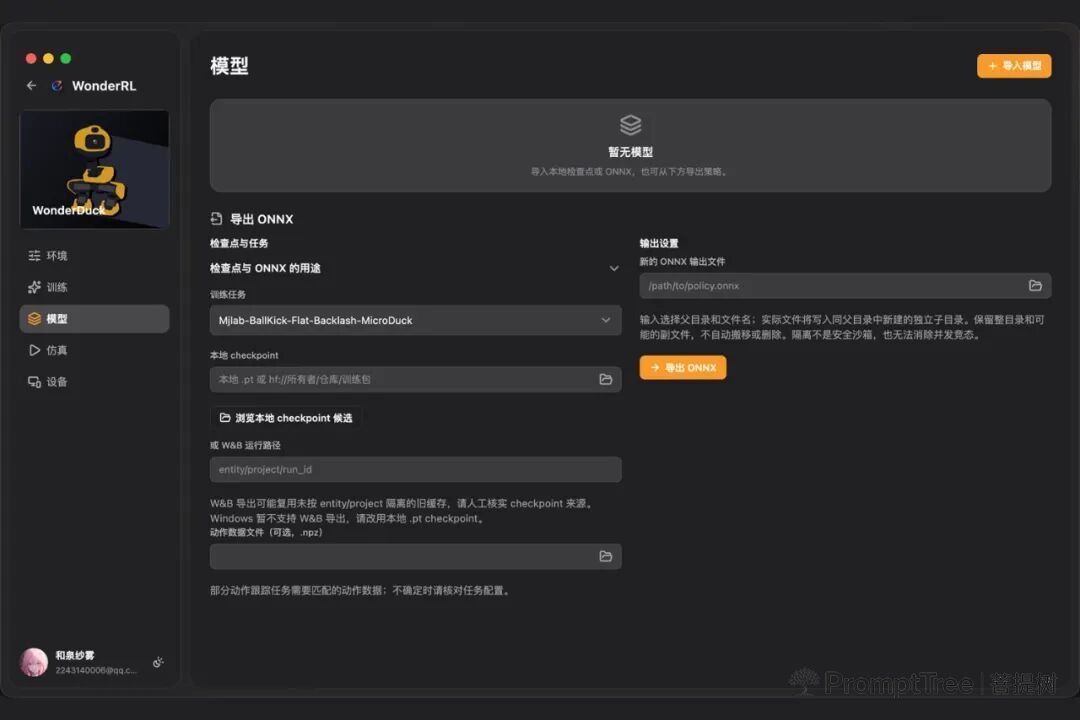
WonderDuck将上述环节整合至一台开源双足机器人,并配套WonderRL强化学习训练工具,提供仿真环境、PPO训练、训练可视化、奖励函数自定义、模型导出及真机部署等能力。开发者可体验预置的行走、站起、坐下、啄取等动作,亦可基于开放训练工程自定义任务,探索专属运动策略。
从跌跌撞撞到自主行走,WonderDuck的背后并非简单录入固定动作,而是让AI在一次次尝试与反馈中逐渐找到自身的运动方式。