MiniMax发布M2.5模型:强化学习驱动,编程与Agent能力达行业前沿
声明:文档由AI根据原文生成。
模型核心升级:性能与成本双突破
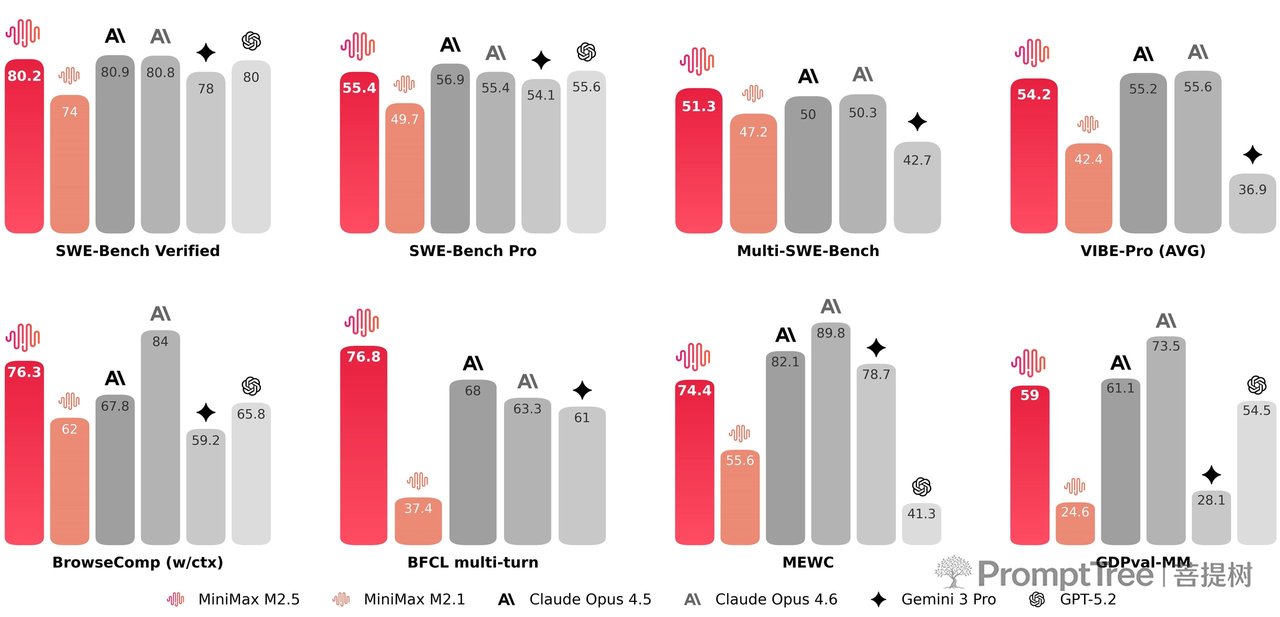
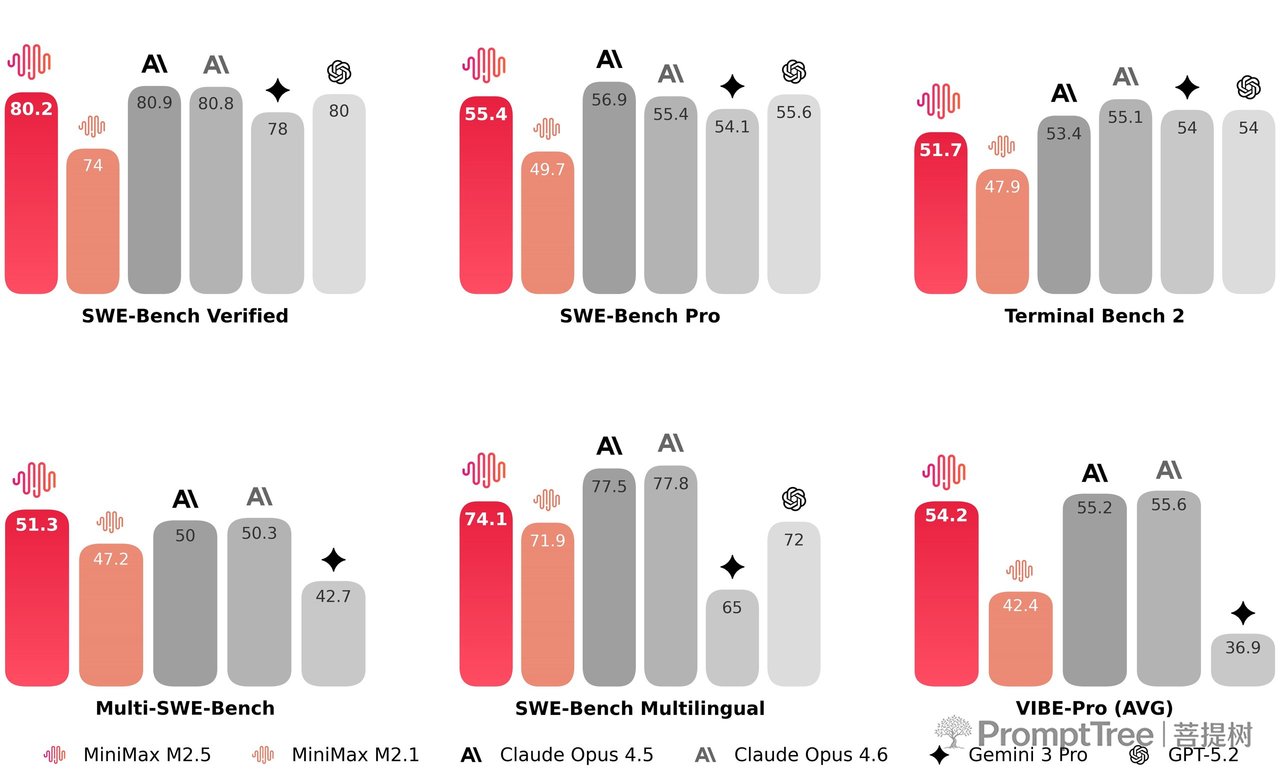
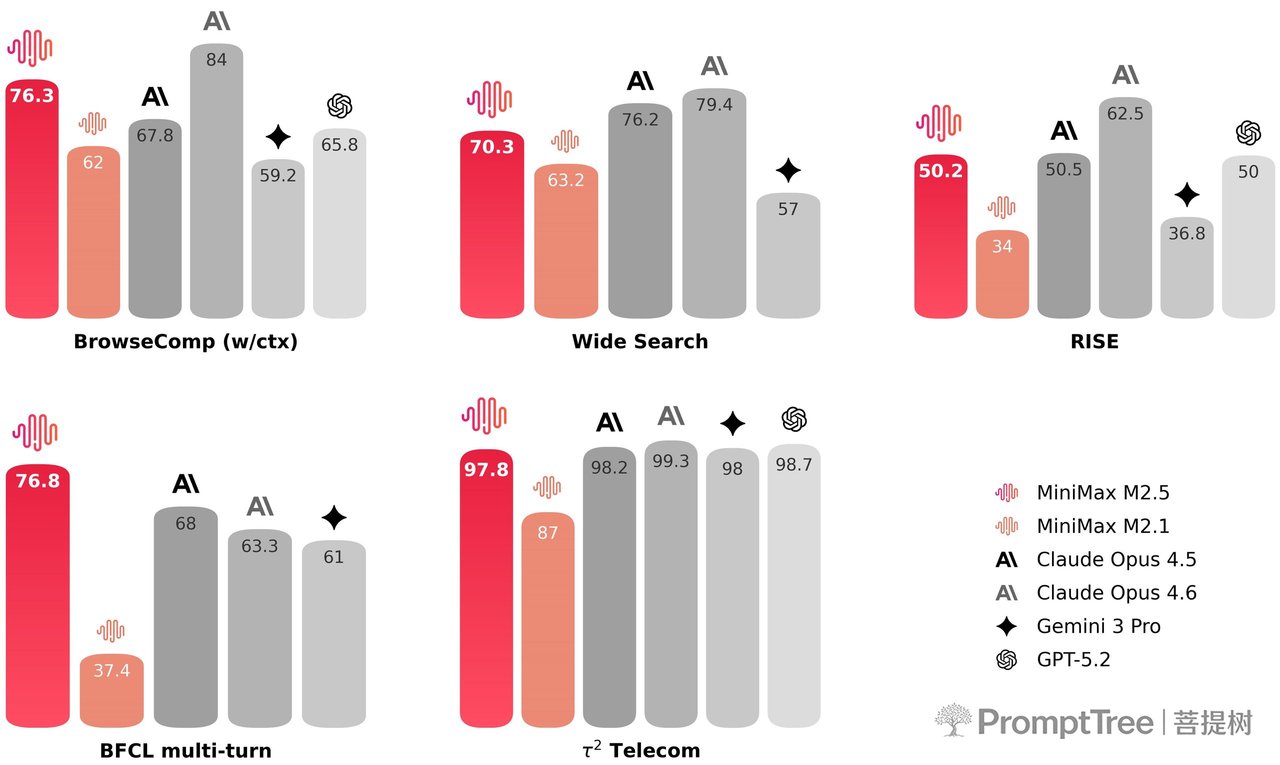
2026年2月12日,MiniMax发布新一代大语言模型MiniMax-M2.5。该模型经过数十万个真实复杂环境中的大规模强化学习训练,在编程、工具调用与搜索、办公等生产力场景达到或刷新行业最优水平(SOTA),关键基准测试成绩包括:SWE-Bench Verified 80.2%、Multi-SWE-Bench 51.3%、BrowseComp 76.3%。
M2.5针对复杂任务的拆解能力与token消耗进行了优化,Agent任务执行效率显著提升。在SWE-Bench Verified测试中,其端到端耗时较上一代M2.1缩短37%,从平均31.3分钟降至22.8分钟,与Claude Opus 4.6的22.9分钟基本持平。
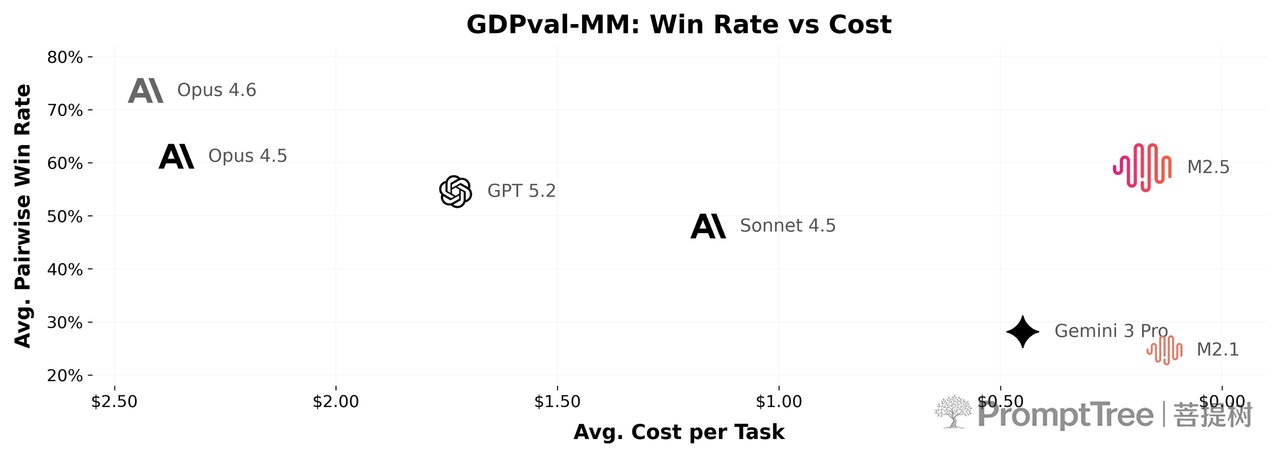
该模型同时突破了前沿模型的使用成本瓶颈。在每秒输出100 token的速率下连续工作一小时仅需1美元;50 TPS版本仅需0.3美元。MiniMax称,按输出价格计算,50 TPS版本价格为Opus、Gemini 3 Pro及GPT5等模型的1/10至1/20。
编程能力:架构师级全流程开发
M2.5在编程核心测试中达到与Claude Opus系列相近水平,并在Multi-SWE-Bench多语言任务中位列第一。模型演化出原生Spec行为:在编码前以架构师视角主动拆解功能、结构与UI设计,完成前期规划。
训练覆盖Go、C、C++、TypeScript、Rust、Kotlin、Python、Java、JavaScript、PHP、Lua、Dart、Ruby等十余种语言,涉及数十万个真实环境。能力范围涵盖从0到1的系统设计、环境构建,从1到10的系统开发,从10到90的功能迭代,以及从90到100的代码审查与系统测试,支持Web、Android、iOS、Windows、Mac等多平台全栈项目,包括服务端API、功能逻辑与数据库等。
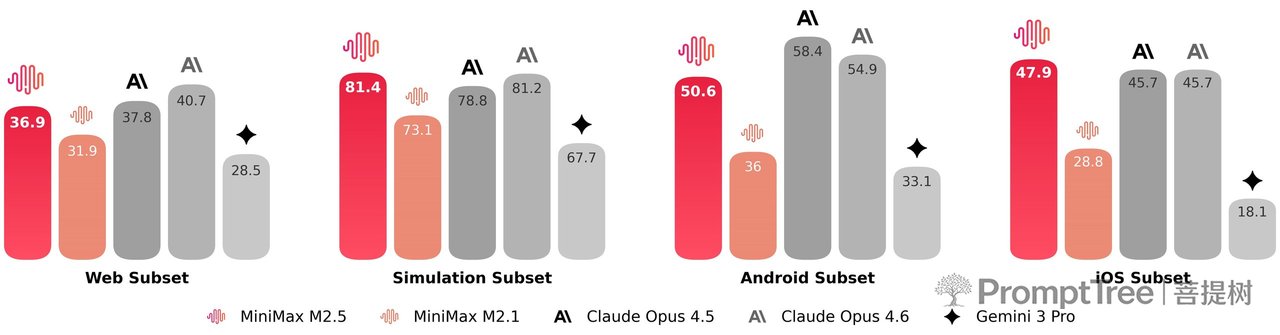
为衡量相关能力,MiniMax将VIBE基准升级为复杂度、领域覆盖度与评估准确度显著提升的Pro版本。综合评测显示,M2.5与Opus 4.5表现相当。
在不同编程脚手架的泛化性测试中,M2.5在Droid上通过率为79.7%,超过M2.1的71.3%与Opus 4.6的78.9%;在OpenCode上通过率为76.1%,超过M2.1的72.0%与Opus 4.6的75.9%。
搜索与工具调用:专家级深度探索
搜索和工具调用是模型自动处理复杂任务的基础。M2.5在BrowseComp、Wide Search等榜单达到行业顶尖水平,面对陌生脚手架环境时表现更为稳定。
针对真实场景中搜索引擎仅占小部分、专业网页深度探索为主的特征,MiniMax构建了RISE(Realistic Interactive Search Evaluation)基准,衡量模型在真实专家级搜索任务中的能力,M2.5表现卓越。
相比前代模型,M2.5展现出更高的决策成熟度:在BrowseComp、Wide Search及RISE等多项任务中,以更低轮次消耗取得更优效果,较M2.1节省约20%的轮次消耗。
办公场景:行业知识驱动的可交付产出
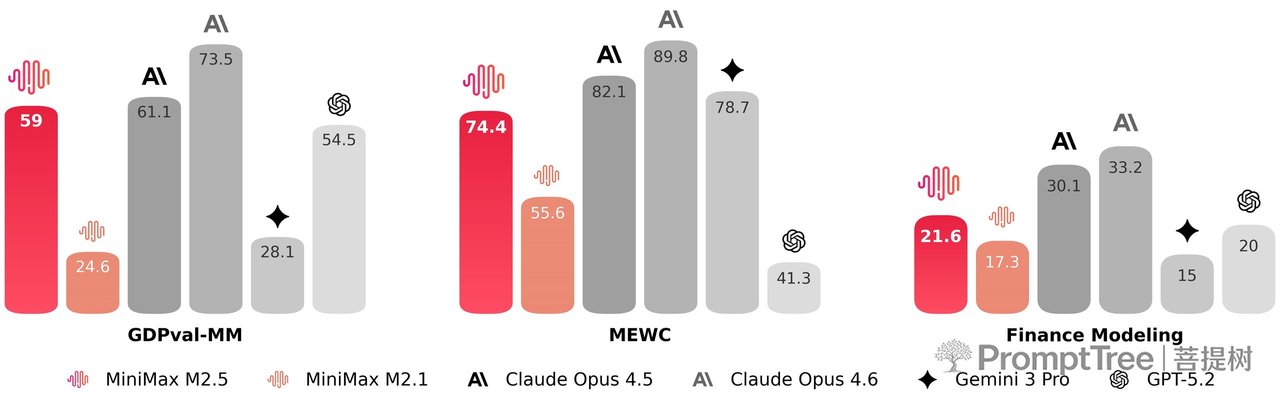
M2.5与金融、法律、社会科学等领域资深从业者深度合作,将行业隐性知识融入训练流程,在Word、PPT、Excel金融建模等高阶办公场景中能力显著提升。
评测采用内部构建的Cowork Agent框架(GDPval-MM),以两两对比方式评估交付质量、轨迹专业性,并监控全流程token费用。与主流模型对比中,M2.5取得59.0%的平均胜率。
效率优化:三环节协同提速
M2.5的推理速度达100 TPS,约为当前主流模型的两倍。通过强化学习优化复杂任务拆解能力与思考过程token消耗,结合并行工具调用等能力提升,三环节协同实现效率突破。
SWE-Bench Verified测试中,M2.5平均每任务消耗3.52M token,较M2.1的3.72M token有所下降。
成本结构:双版本覆盖不同需求
M2.5提供效果一致但速度与价格不同的两个版本:100 TPS快速版输入0.3美元/百万token、输出2.4美元/百万token;50 TPS版本输出价格再降一半。MiniMax称1万美元可支持4个Agent连续工作一年,为大规模Agent构建与运营提供经济可行性。
迭代速度:108天三代更新
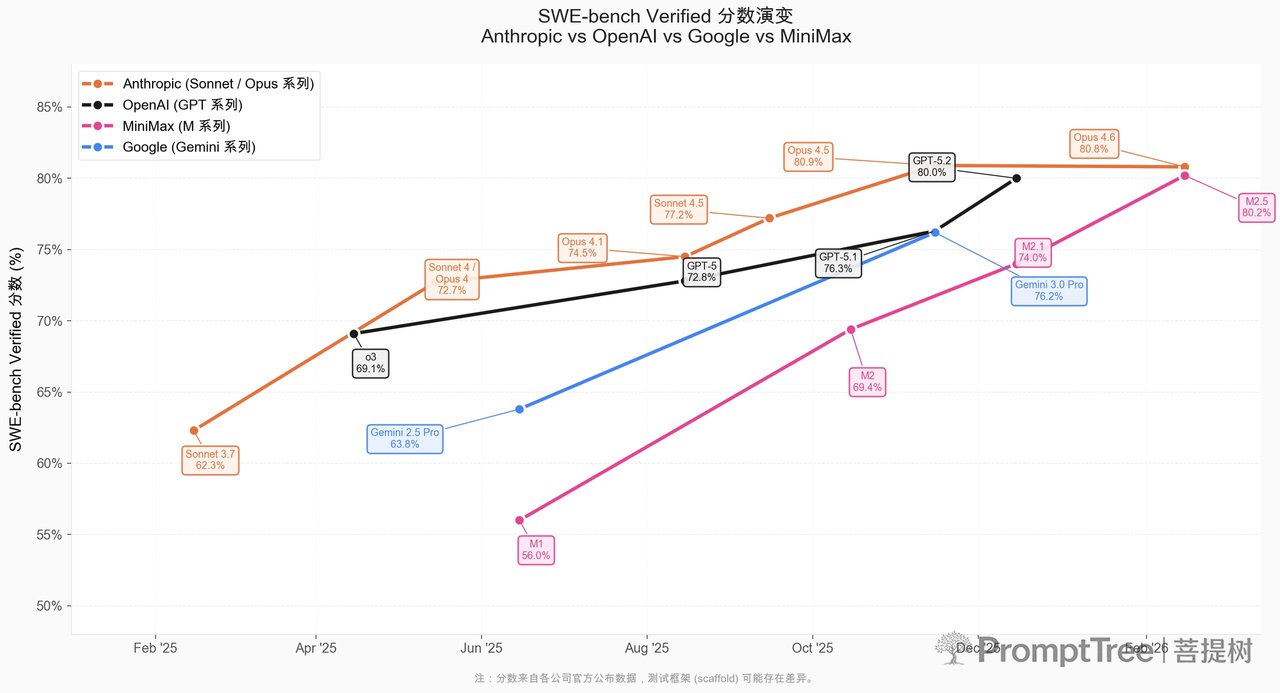
过去108天内,MiniMax陆续发布M2、M2.1与M2.5。在SWE-Bench Verified等编程领域代表性基准上,M2系列进步速度超过Claude、GPT及Gemini等模型系列。
技术底座:大规模强化学习扩展
MiniMax将进展归因于大规模强化学习对模型能力及脚手架、环境泛化性的显著提升。通过Agent RL框架、算法与Reward设计、工程优化的协同设计,支持对任意Agent脚手架与环境的高效优化,在数十万个Agent脚手架与环境中验证了近线性的scaling提升。
Forge原生Agent RL框架
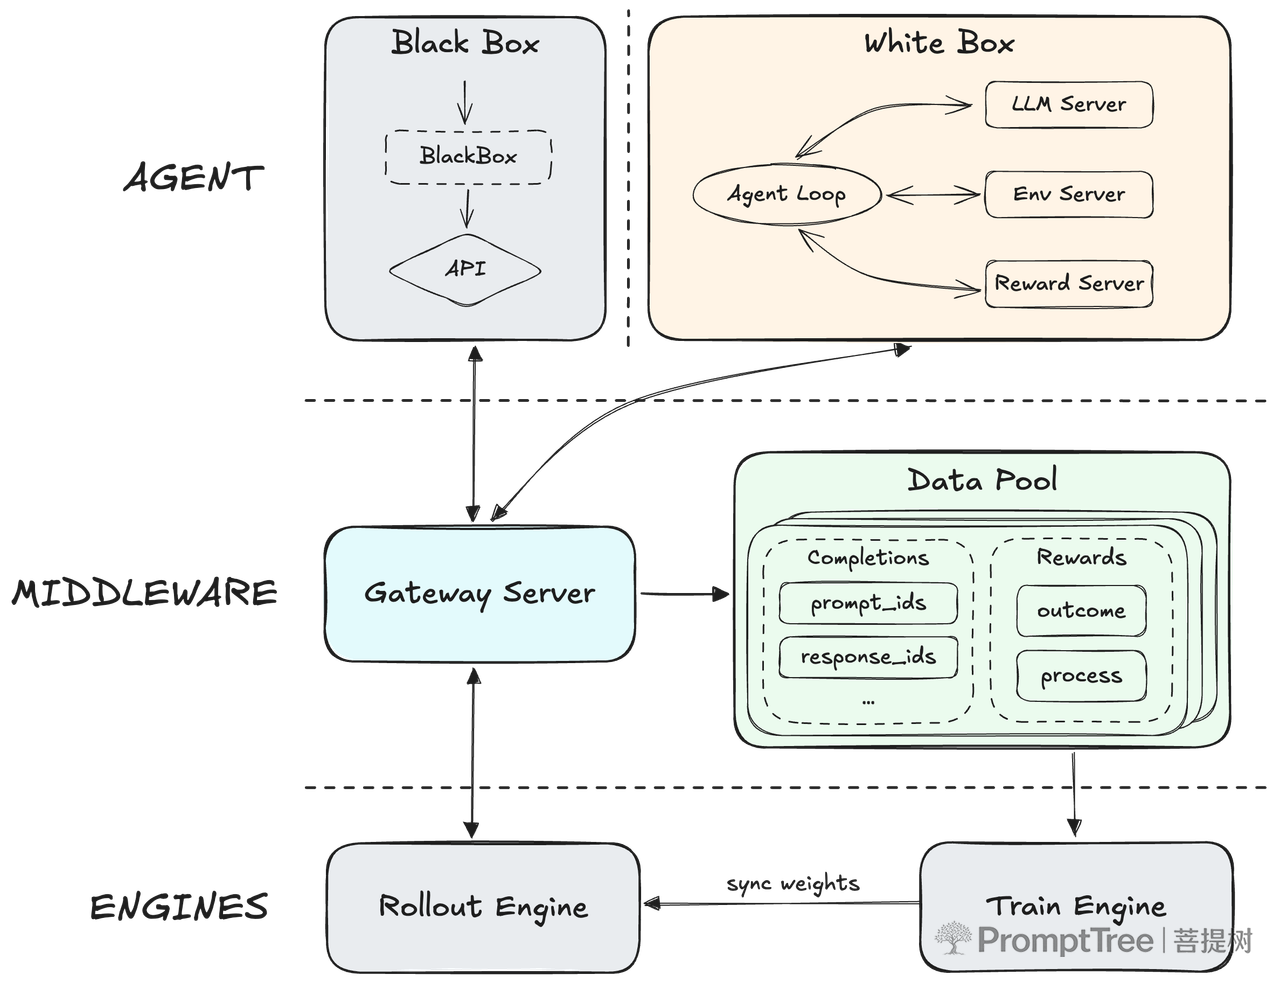
Forge通过引入中间层解耦底层训推引擎与Agent,支持任意Agent接入以优化泛化性。异步调度策略平衡系统吞吐与样本off-policyness,树状合并训练样本策略实现约40倍训练加速。
算法与Reward设计
算法层面沿用年初提出的CISPO算法保障MoE模型大规模训练稳定性。针对Agent场景长上下文的信用分配难题,引入过程奖励机制(Process Reward)实现全链路监控。为对齐用户体验,直接估计真实环境耗时作为Reward,平衡模型效果与响应速度。
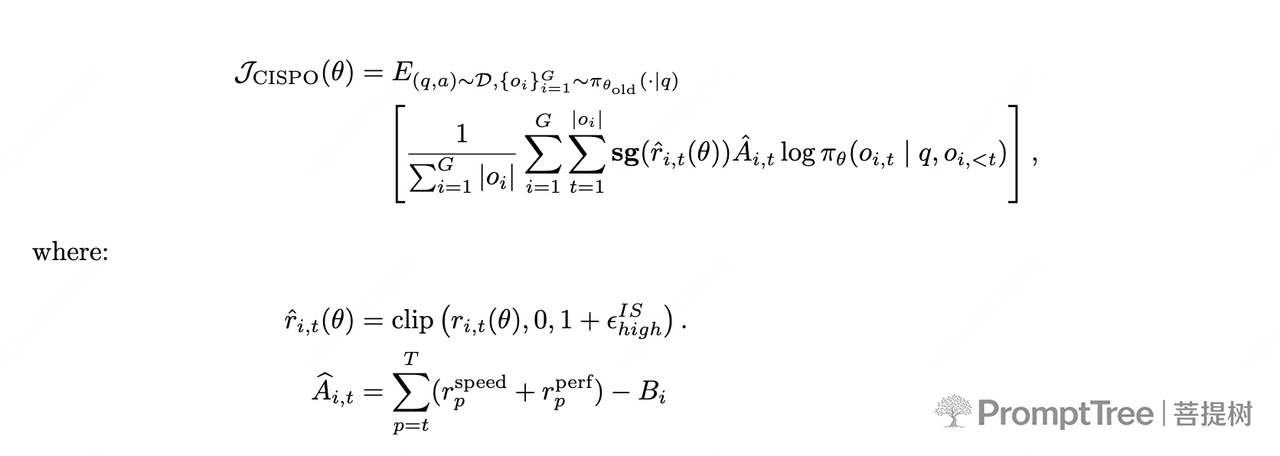
产品落地:MiniMax Agent全面集成
M2.5已在MiniMax Agent全面上线。核心信息处理能力被提炼为标准Office Skills,全能(MAX)模式下自动根据文件类型加载对应技能。用户可将Office Skills与领域经验结合,创建面向特定场景的复用型专家(Expert)。
行业研究场景中,成熟研究框架SOP与Word Skills融合后,Agent可按既定框架自动抓取数据、组织分析逻辑并输出规范研报。金融建模场景中,机构专属建模规范与Excel Skills结合,Agent可遵循特定风控逻辑与测算标准自动生成并校验复杂财务模型。
截至目前,用户已在MiniMax Agent构建1万余个专家,数量持续增长。MiniMax针对办公、金融、编程等高频场景构建了多组深度优化、开箱即用的专家套组。
MiniMax内部已率先应用M2.5。真实业务场景中,整体任务的30%由M2.5自主完成,覆盖研发、产品、销售、HR、财务等职能,渗透率持续上升。编程场景尤为突出,M2.5生成代码已占新提交代码的80%。
评测方法说明
| 基准测试 | 方法概要 |
|---|---|
| SWE-bench系列 | 内部设施使用Claude Code作为脚手架,覆盖默认system prompt,测试4次取平均;SWE-bench Verified另在Droid与OpenCode脚手架上以默认prompt评估 |
| Terminal Bench 2 | 使用Claude Code 2.0.64,修改部分Dockerfile,统一8核CPU/16GB内存/7200秒超时,配备基础工具集,response为空时重试,4次平均 |
| VIBE-Pro | 内部基准,Claude Code自动验证交互逻辑与视觉效果,统一链路计算,3次平均 |
| BrowseComp | 采用WebExplorer(Liu et al. 2025)框架,超32k token时总结历史上下文,上限1M token |
| Wide Search | 采用WebExplorer(Liu et al. 2025)框架 |
| RISE | 内部基准,含人类专家真实提问,基于WebExplorer框架加入PlayWright浏览器工具集 |
| GDPval-MM | 内部基准,基于开源GDPval,自建Agentic框架,LLM-as-judge做pairwise判定,按官方API定价(无cache)计算平均token花费 |
| MEWC | 内部基准,基于2021-2026年Microsoft Excel World Championship共179题,比较输出与答案单元格数值计分 |
| Finance Modeling | 内部基准,行业专家构建题目,Excel工具端到端研究分析,专家rubric打分,3次平均 |