MiniMax 开源 Forge 框架:突破 Agent 强化学习“不可能三角
声明:文档由AI根据原文生成。
核心突破:打破 Agent RL 的三角约束
将强化学习推向真实世界的 Agent 应用,长期面临系统吞吐、训练稳定性与 Agent 灵活性三者相互制约的困境。2026年2月12日,MiniMax 发布内部 RL 框架 Forge,通过灵活的系统架构、面向长时程 Agent 的算法设计、尊重训练分布的异步调度及极致的工程加速,实现了这一"不可能三角"的突破。
在 MiniMax M2.5 模型的训练过程中,Forge 接入了超过十万种真实 Agent 脚手架与环境。系统在最长 200k 上下文、日处理数百万样本量级的负载下,保持了稳定的奖励收敛与模型底座能力的持续提升。结合 CISPO 算法与复合奖励设计,M2.5 将高效、可靠的真实生产力推向新边界。
问题定义:Agent RL 的三类结构性挑战
Agent RL 系统的核心目标是最大化 Effective Agent Training Yield,即系统吞吐与样本效率的乘积,同时满足稳定性与收敛性约束。这一目标面前横着三类挑战:
Agent 扩展性与框架灵活性受限。 主流框架将 Agent 视为白盒函数,与 Trainer 共享状态,难以表达动态上下文管理、多 Agent 协作等复杂认知架构;token-in/token-out 架构则将 Agent 与底层 token 逻辑深度耦合,引入复杂上下文管理时代价高昂。
系统效率与计算冗余。 Agent rollout 完成时间极度发散,从秒级到小时级不等,造成调度死锁:严格同步调度引发队头阻塞,贪婪异步则导致严重的训练分布偏移。此外,大量请求共享相同前缀,传统训练方法反复计算,浪费海量算力。
算法层面的 Credit 分配与优化稳定性。 长时程、延迟反馈的 Agent 任务使得稀疏奖励下的 Credit 分配数学上非常脆弱,高方差梯度易导致训练失稳;传统 RL 目标仅关注正确性而忽略 wall-clock 成本,可能训练出"答对但很慢"的 Agent。
系统架构:Middleware 解耦三大模块
Forge 采用通用化 Middleware 设计,将 Agent 推理逻辑与底层训练基础设施解耦,由三大模块组成:
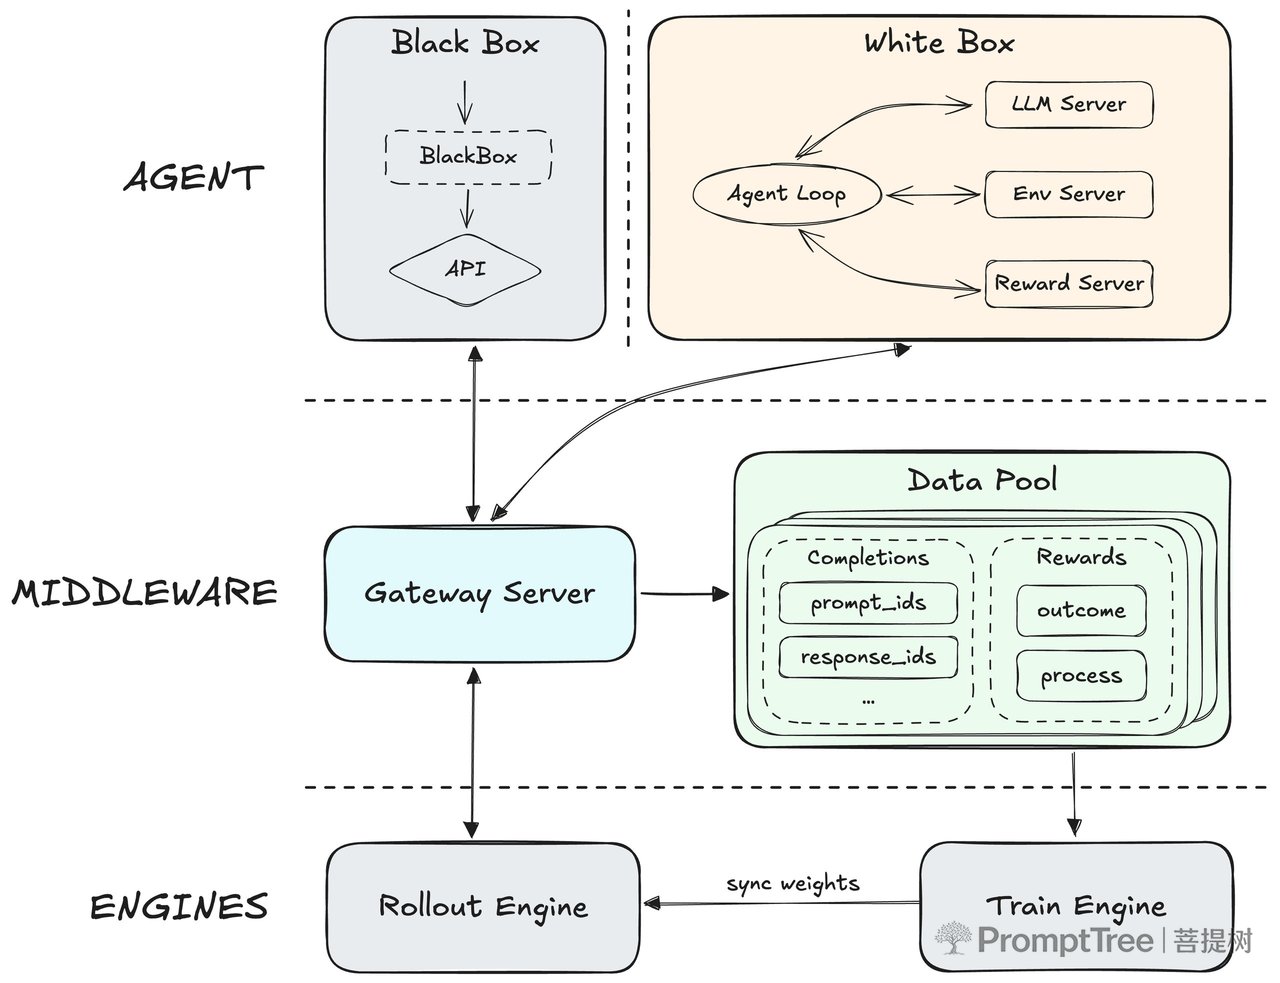
Forge RL three-module system architecture
Agent Side 抽象 General Agent,覆盖白盒与黑盒脚手架及其运行环境,负责递归式环境交互,使 Agent 成为纯粹的轨迹生产者。
Middleware 抽象层 物理隔离 Agent 与训练/推理侧,包含 Gateway Server(标准化通信网关,剥离底层模型复杂性)与 Data Pool(分布式数据存储,异步收集轨迹并作为生成与训练间的缓冲层)。
Training and Inference Side 承担重计算,Rollout Engine 专注高吞吐 token 生成,Train Engine 消费 Data Pool 处理后的序列更新策略,两者保持同步以确保 Agent 在最新策略分布下探索。
该模块化框架支持在不修改 Agent 内部的前提下,用大量不同脚手架进行训练,实现模型在脚手架之间的泛化。引擎与 Agent 完全解耦,新 Agent 接入为机械化操作,已支持上百种脚手架类型、上千种工具调用格式。
白盒与黑盒 Agent 的差异化训练策略
白盒 Agent:上下文管理嵌入 RL 循环
针对需要主动上下文管理的长时程任务(如 DeepSearch),Forge 将 CM 机制直接嵌入 RL 交互循环,把上下文管理作为驱动状态转移的功能性动作。这使得上下文切换自然嵌在环境动力学中,模型在优化策略过程中内化分布偏移,涌现出优先关注"状态关键" token 的稳健推理模式,主动保留任务关键信息、剪掉无关噪声。
黑盒 Agent:跨异构脚手架的鲁棒泛化
对于专有或复杂的黑盒 Agent 架构,Forge 完全不关心其内部实现,Agent 只需将请求路由至 RL 服务 Gateway。这种非侵入式接入支持任意上下文操作(记忆压缩、历史改写)及任意复杂的内部 Agent Loop(Deep Think、多 Agent 架构)。实验显示,即便面对完全不透明的系统,性能提升依然稳定一致,覆盖范围从重度依赖 Sandbox 与 MCP 环境的代码型 Agent,到采用激进上下文压缩策略的 Agent。
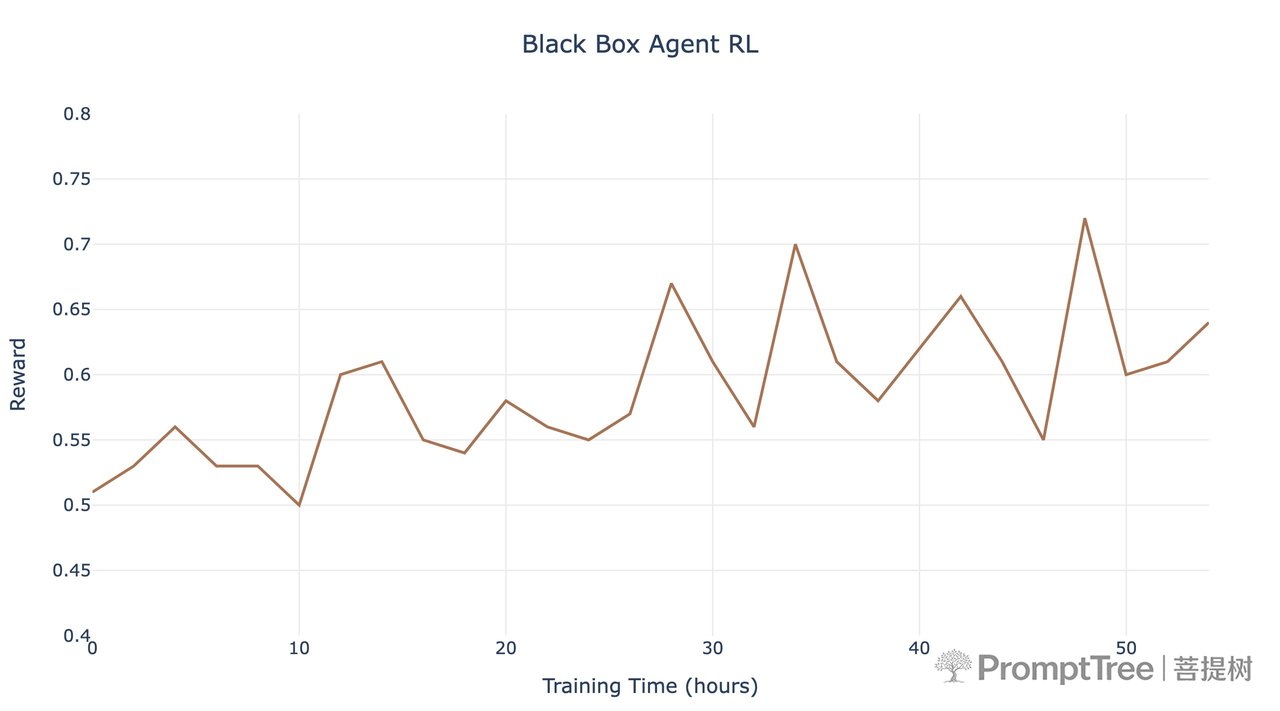
Black-box agent training results
工程优化:调度、训练与推理的三重加速
Windowed FIFO:平衡吞吐与分布一致性
为缓解"效率 vs off-policy"的取舍,Forge 设计了滑动窗口约束的混合调度策略。调度器仅从全局生成队列的头部窗口内拉取已完成轨迹,窗口内允许贪婪乱序以避免队头阻塞,窗口边界严格阻塞以防止分布向"又快又容易"的样本漂移。窗口仅在头部任务被消耗后前移,迫使调度器等待 stragglers,维持训练分布稳定。
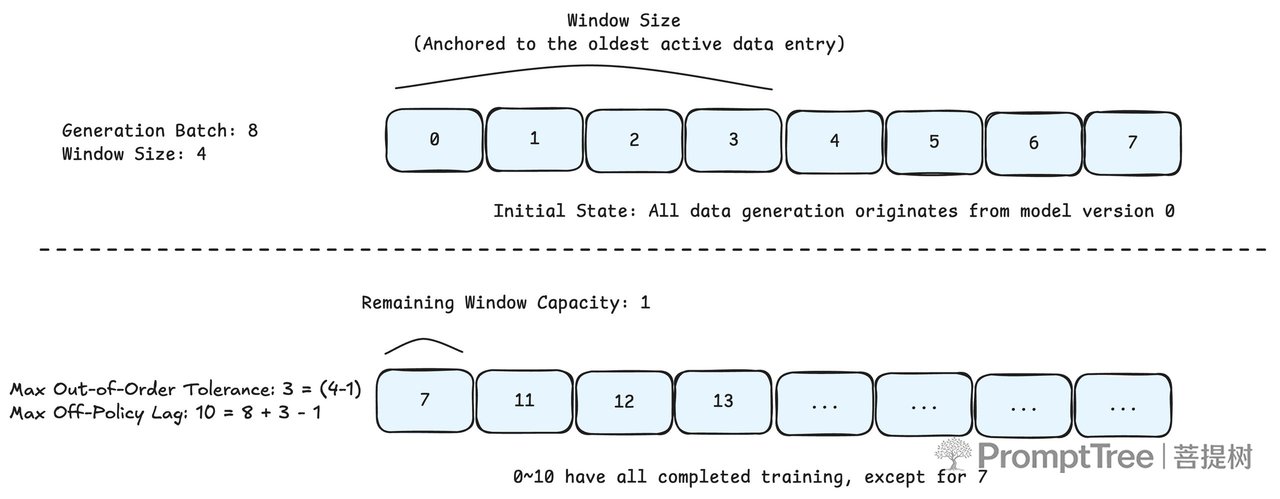
Windowed FIFO scheduler
Prefix Tree Merging:40 倍训练加速
针对 Agent 训练数据集中大量共享前缀的冗余问题,Forge 将训练从"线性处理"改造为"树状结构"。多个 completion 只要共享底层前缀,即便后续响应不同或来自不同采样分支,均可合并为单棵前缀树。借助 Magi Attention 等注意力原语,逻辑执行与标准前向传播完全一致,对下游逻辑零侵入。该方案实现 40 倍训练加速,显著降低内存压力,与标准方法在数学上严格等价。
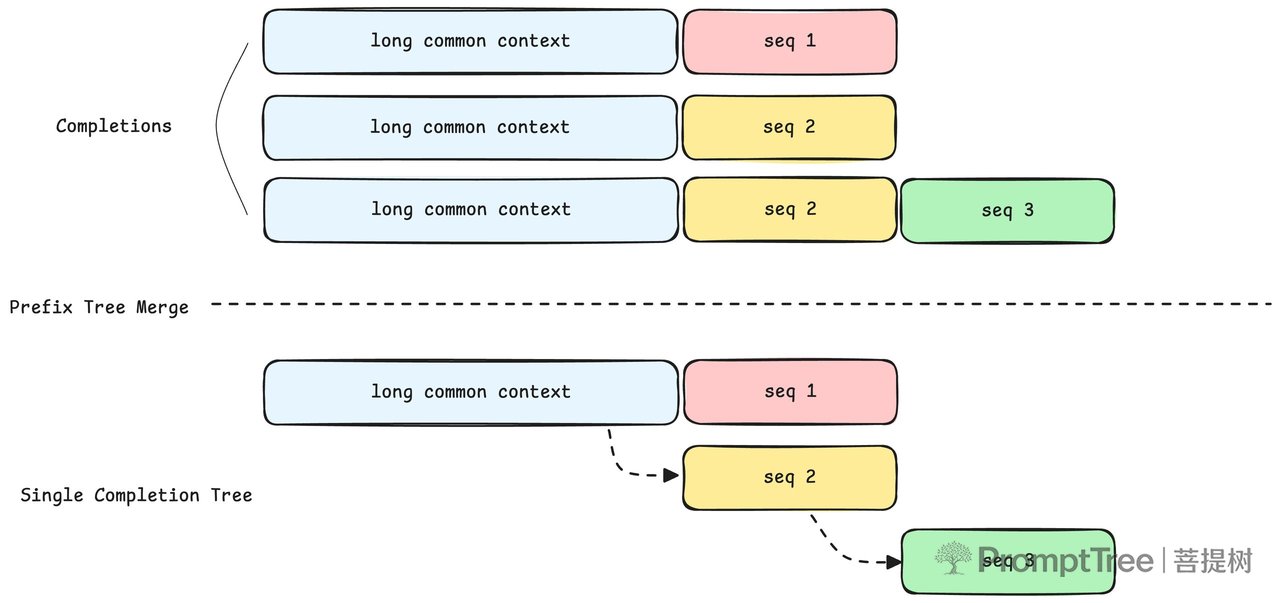
Prefix tree merging illustration
推理加速的三项架构创新
基于 MTP(Multi-Token Prediction)的投机解码,通过 Top-K KL loss 持续微调草稿模型,使其与不断演进的 RL 策略保持对齐;异构 PD 解耦将 Prefill 与 Decode 分离,消除混合 MoE 调度下的互相干扰,允许两侧独立采用最优并行策略;全局 L3 KV Cache Pool 基于 DFS 管理,配合 cost-aware 调度器在排队延迟与缓存迁移成本间动态权衡,将前缀缓存命中率推至极致。
算法设计:CISPO 与复合奖励框架
Forge 以 CISPO 为核心算法,采取 Reasoning、General QA、Agent 三类任务混合的联合训练,消除串行训练常见的负迁移与性能退化。为应对超长上下文下的 Credit 分配难题,设计了复合奖励框架:Process Reward 针对中间行为提供稠密反馈;Task Completion Time Reward 将相对完成时间纳入奖励信号,激励并行与加速执行;Reward-to-go 形式归一化回报以降低梯度方差,稳定优化过程。
结论与开源
Forge 通过灵活架构与 CISPO 算法的结合,成功化解了 Agent RL 扩展的"不可能三角",支撑了 MiniMax M2.5 背后的大规模训练。该框架已开源,原文链接见 Hugging Face:《Forge: Scalable Agent RL Framework and Algorithm》。