银河通用发布WAM-TTT框架,机器人凭少量人类视频即可适配新环境
声明:文档由AI根据原文生成。
银河通用推出部署期轻量学习框架,基础模型主干保持冻结
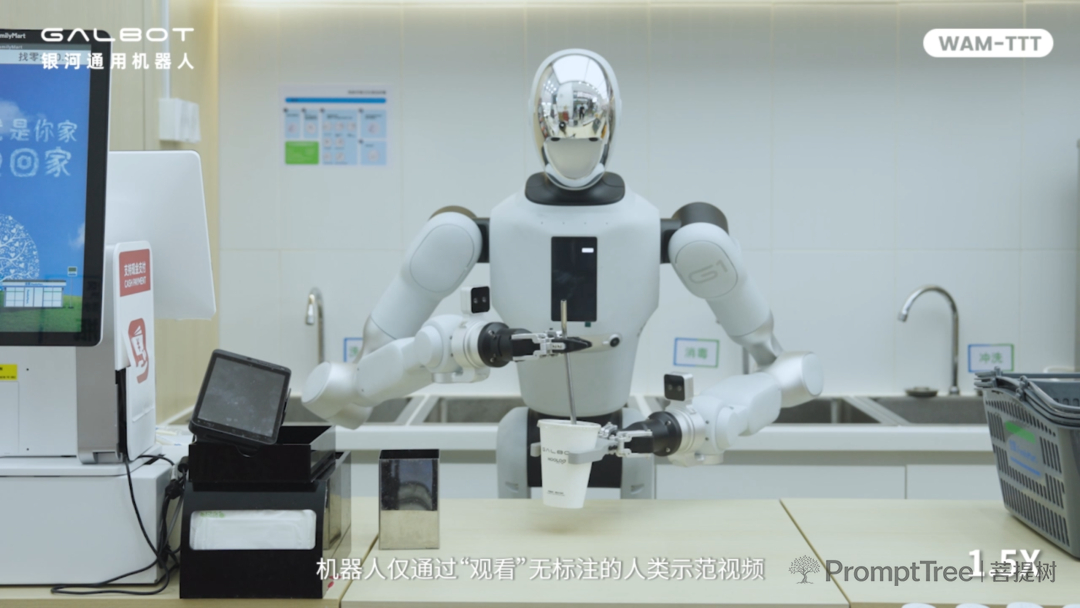
2026年7月16日,北京银河通用机器人有限公司(以下简称"银河通用")发布WAM-TTT(World-Action Model Test-Time Training)框架。该框架定位为全球首个面向具身智能大模型的测试时后训练框架,也是银河通用旗下银河星脑(AstraBrain)持续学习体系中面向世界-动作模型(World-Action Model,WAM)的又一项原创性技术。
银河通用创始人兼CTO王鹤曾以厨师换厨房作比:厨师在技校学会做菜,换到锅碗灶台全不同的餐厅仍知道怎么做。WAM-TTT希望赋予机器人的正是这种能力——基础技能来自预训练,进入新环境后只需快速理解"新厨房"。
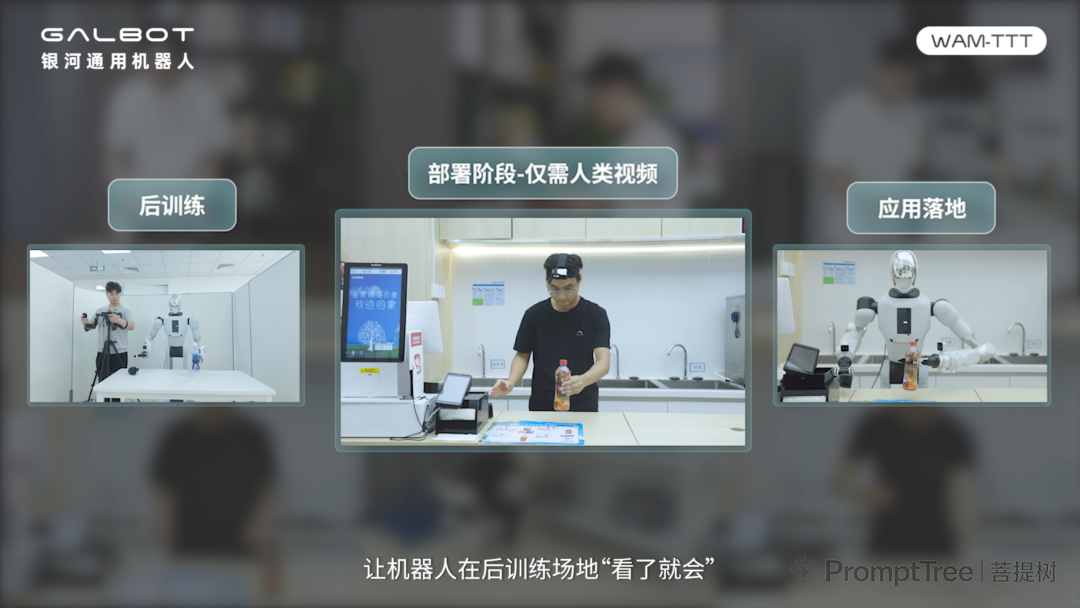
按照银河通用的定义,该框架首次建立起从模型预训练到部署阶段迅速、低成本完成适应的技术路径:机器人进入新环境后,无需大量机器人轨迹数据、数据无需人类动作标注,仅通过观看少量第一视角人类视频,即可完成部署阶段的快速适配。
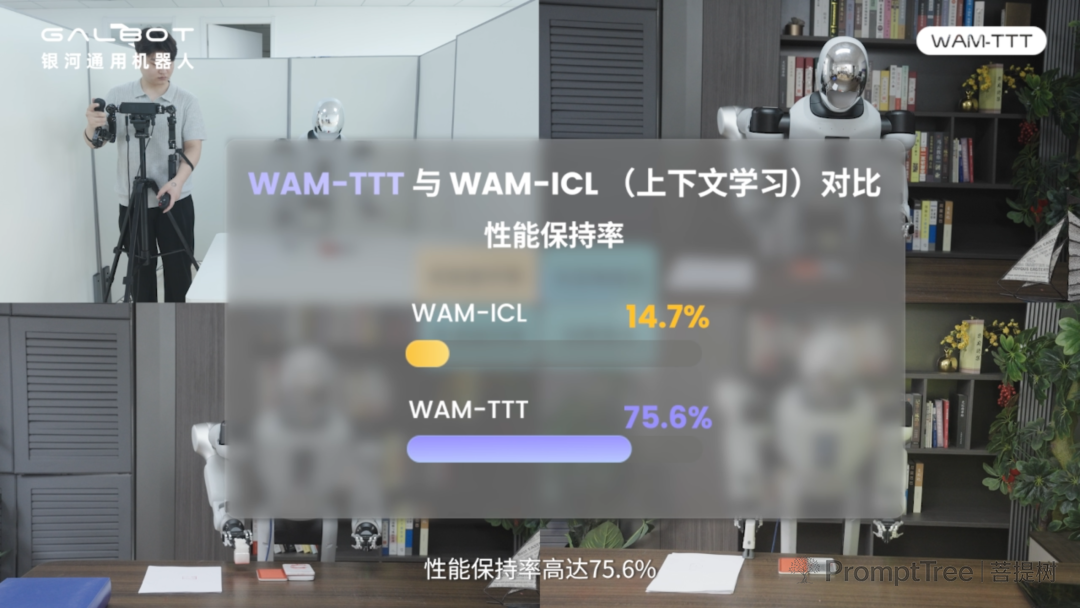
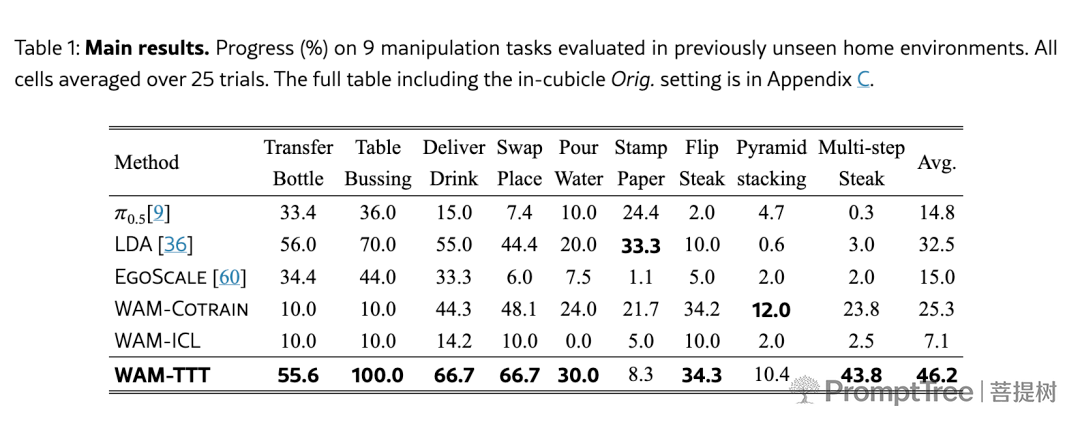
同步发布的技术论文显示,面对光照、桌面高度、操作物体同时变化的全新家庭环境,上下文学习基线WAM-ICL(将人类示范视频直接放入模型上下文、执行时临时参考)九项任务平均进度从48.4%下降至7.1%;采用WAM-TTT后,同样的人类视频、同样的基础模型,跨环境表现保留率由约15%提升至约76%。
王鹤在ICRA 2026主旨演讲中将WAM-TTT称为连接预训练与真实部署的重要一环,认为其解决的核心问题是如何把已训练好的基础模型快速带到真实世界并支撑长期部署。
从"毕业即定型"到"到岗即适应"
过去几年,机器人行业竞争集中在预训练阶段,拥有更多机器人数据、训练更大基础模型、在标准环境下完成更多任务是核心竞争指标。但随着机器人进入零售、药房、工厂和仓储场景,"会干活却不会换地方干活"成为更现实的瓶颈。
便利店灯光变化、同一张餐桌在不同门店的餐具差异,同一技能面临大量场景变化。目前行业主要采用三种适应方式:重新采集目标场景机器人轨迹进行监督微调(SFT),成本最高;上下文学习(In-Context Learning),将人类示范视频直接输入模型参考;部署后强化学习,需要真实环境允许持续试错。
三种方式各有成本门槛:机器人数据昂贵,上下文过长导致注意力分散,强化学习依赖真实环境容错。若每增加一个客户都重新采集数据、重新训练、重新派工程师,规模化难以成立。
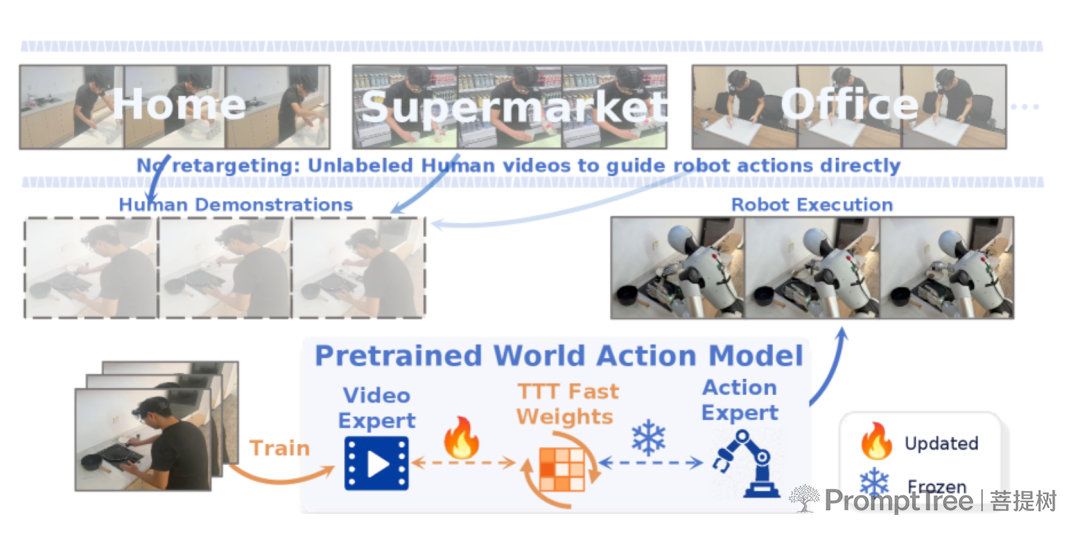
WAM-TTT采用测试时训练(Test-Time Training)思路,不重新训练整个基础模型,而是在部署阶段进行轻量学习,模型主干保持冻结。
三项技术突破:人类视频直接驱动适配
WAM-TTT建立在银河通用此前提出的World Action Model(WAM)之上。与传统机器人模型只预测"下一步动作"不同,WAM同时学习预测未来视觉状态和生成机器人动作,这也是其能理解人类视频的基础——人类视频中不存在机器人关节角度或控制信号,但物体状态变化本质上是世界状态,WAM将视觉变化和动作变化纳入同一套隐空间建模。
论文提出的第一项突破是部署阶段仅需人类视频。机器人进入新环境后,操作者录制少量第一视角人类示范视频,系统利用这些视频完成自监督任务——预测未来视频帧,并据此更新一组轻量快速权重(Fast Weights)。整个过程不需要新增机器人轨迹、遥操作采集或动作标签。但需注意,WAM-TTT体系并非完全摆脱机器人数据,预训练阶段仍需机器人数据支撑。
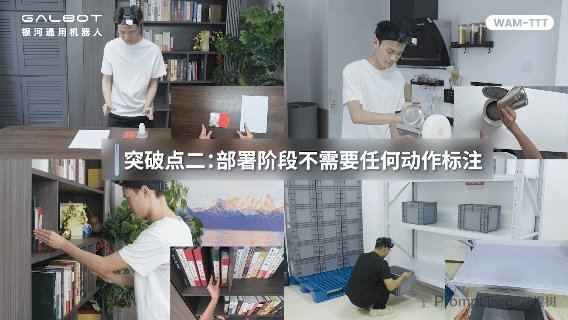
第二项突破是跳过动作重定向。传统方法需先估计人的三维手部姿态,再映射到机器人关节空间,涉及人体姿态估计、动作重定向、机器人运动学等多个步骤,对遮挡、深度误差和本体差异敏感。WAM-TTT完全绕开该路线,学习的是任务进行到哪一步、物体发生何种变化、环境最终应呈现什么状态。
第三项突破是将新场景信息保存到独立记忆。部署阶段WAM主干、动作专家及其他慢权重全部冻结,仅快速权重发生变化。银河通用将此概括为"零遗忘",即部署阶段不直接修改基础模型和动作专家,规避新场景适配覆盖原有动作能力的风险。
跨环境保留率提升约5倍,人类视频成"第二种数据"
WAM-TTT还回应了产业核心问题:人类视频能替代多少机器人数据?
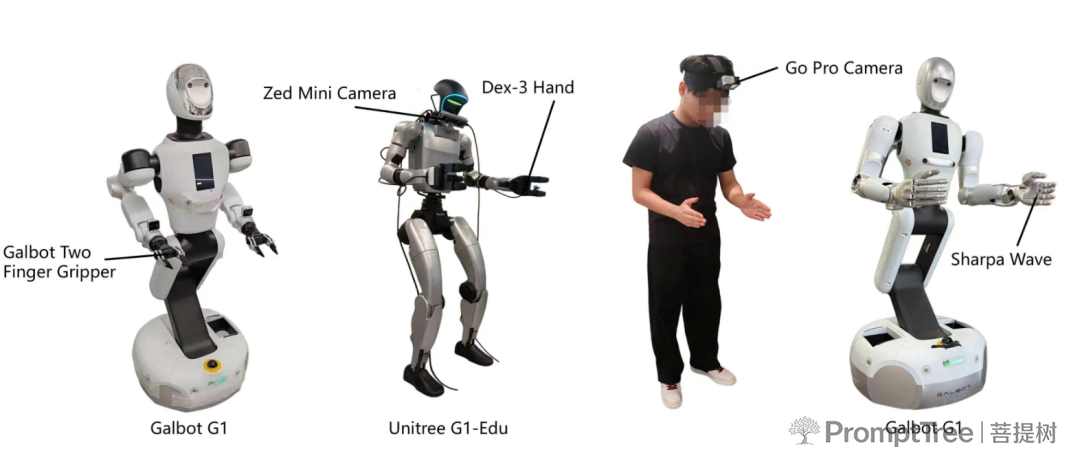
论文在Unitree G1、Galbot双臂夹爪和Galbot灵巧手三种机器人本体上完成九项真实操作任务测试,每个"任务—环境"组合运行25次。对照实验中,两组模型接收完全相同的人类示范视频,唯一区别在于视频进入模型的方式:WAM-TTT将视频用于更新快速权重,WAM-ICL则将视频直接放入模型上下文作为参考、不更新模型参数。
原始训练环境中两者差距不大,但跨环境迁移拉开显著差距。当光照、桌面高度和操作物体同时变化,机器人进入此前未见过的家庭环境后,WAM-ICL跨环境表现保留率约15%,WAM-TTT约76%,相差约5倍。
论文单独测试了光照变化和空间位置变化。Deliver Drink任务中,面对光照扰动,WAM-TTT任务进度达66%,WAM-ICL仅12%;面对空间位置变化,两者分别为56%和20%。
另一组实验聚焦数据成本。Transfer Bottle、Table Bussing和Deliver Drink三个任务中,总数据预算200条。第一组全部使用机器人示范,第二组使用100条机器人示范加100条配对人类视频,两者平均任务进度分别为73.7%和74.1%,几乎无差别。即在元训练阶段,100条人类视频承担了接近100条机器人示范的数据价值。
机器人数据负责身体(Body),人类视频负责任务(Task),二者形成新的分工。这一趋势已现端倪:Physical Intelligence同样发现,随着机器人基础模型增强,人类第一视角视频开始能够有效迁移到机器人任务,在机器人数据受限条件下利用人类视频辅助训练可显著提升模型泛化性能。
部署后持续学习成竞争新焦点
具身智能行业的竞争重点正从"谁拥有更大的基础模型",转向"基础模型部署后还能不能继续学习"及低成本规模化部署能力。Google DeepMind发布Gemini Robotics On-Device,希望开发者利用少量示范完成新任务适配;NVIDIA围绕GR00T建立覆盖数据生成、仿真训练和后训练的机器人开发体系;Physical Intelligence持续探索机器人利用真实交互积累经验。各公司技术路线不同,方向趋同。
银河通用对银河星脑(AstraBrain)的定义以预训练基座模型与后训练框架为核心:AstraBrain WAM作为大脑预训练的基座模型,负责环境理解与动作规划;WAM-TTT作为后训练阶段的适配框架,使机器人学会技能后进入新环境能够快速适应。
若部署阶段可通过少量标准化人类视频完成适配,机器人公司的交付方式或将改变:基础模型统一维护,不同客户保存自己的快速权重,新增门店即增加一段场景记忆。但产品化仍面临工程问题,论文尚未回答一次适配需多少时间、多少视频,也未验证快速权重如何管理大量客户、长期升级和版本兼容。
王鹤曾定义具身智能的"ChatGPT时刻":预训练后的机器人在无需专门后训练情况下,对大多数任务达到70%到80%的零样本成功率。WAM-TTT距离此目标仍有距离,但补上了重要能力拼图——机器人离开训练中心后,首次拥有经论文验证、可工程化实现的部署期学习机制。