自变量发布 DMuon 优化器,让具身模型训练提效 30%,3行代码改造底层基础设施
声明:文档由AI根据原文生成。
具身模型企业首次向底层训练基础设施突破
神经网络优化器是大模型训练中的核心组件,负责指导模型权重的调整方向与步长。近两年,Muon 优化器因计算收敛更快、所需步数更少,正逐步替代 AdamW,应用于 Kimi-K2、DeepSeek-V4 等模型的训练。但 Muon 的 N–S 迭代步骤需要完整的权重矩阵信息,在 GPU 集群分布式训练场景下,各计算节点需重复拼装完整矩阵并频繁通信,导致单步耗时达到 AdamW 的 2.2 倍。优势被额外开销抵消后,企业在生产环境中是否采用 Muon 仍需权衡。
具身模型的处境更为棘手。其时序上下文更短,前向-反向传播的计算占比更小,额外引入的计算与通信开销占比反而更大,训练效率拖累尤为严重。改造底层训练基础设施对技术能力要求极高,此前国内鲜有具身模型企业涉足这一层面。
三项改进将额外开销从 120% 压至 2%
自变量机器人近日发布 DMuon 优化器,对 Muon 进行分布式改造,将单步训练时间从 AdamW 的 2.2 倍降至 1.02 倍,额外开销近乎消除。
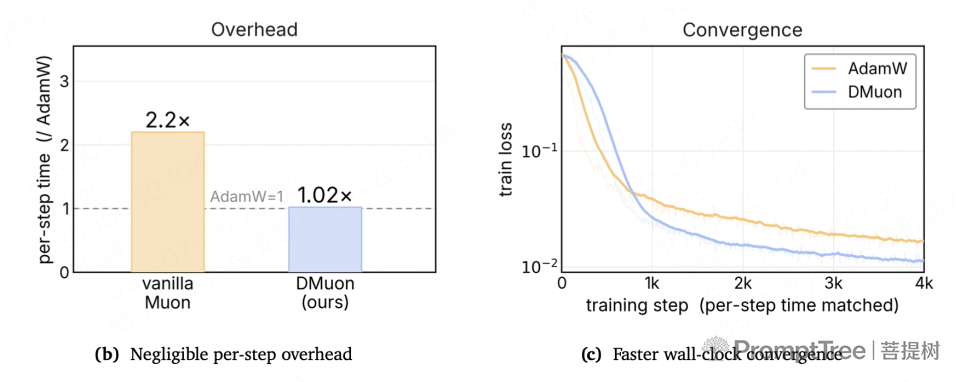
具体而言,DMuon 提出三项技术改进:
Owner 中心执行与通信优化。指定唯一 GPU 负责完整梯度计算与 N–S 迭代,结果分发至其他节点;通信操作被嵌入计算空档执行,避免突发流量造成的网络拥堵。
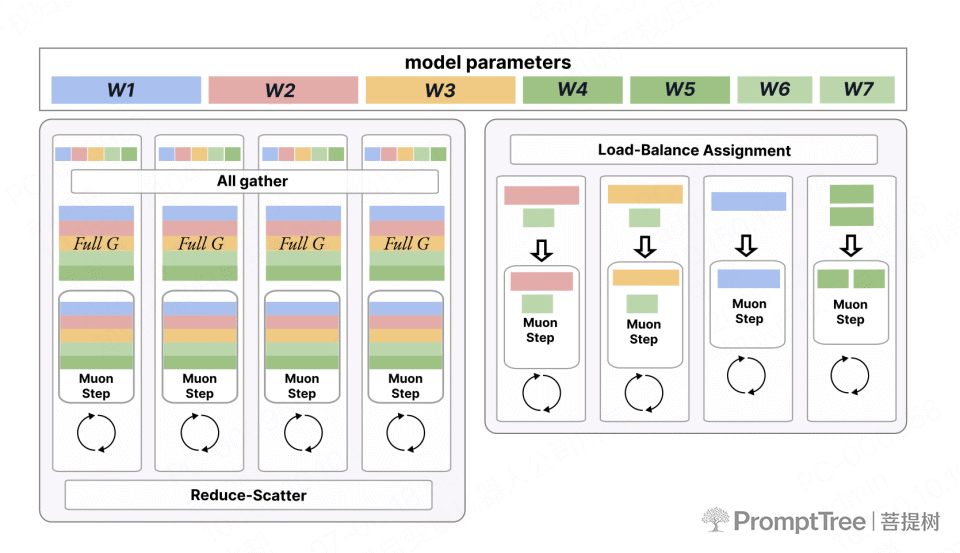
矩阵形状的自动内核优化。针对不同维度的权重矩阵,DMuon 批量生成多种计算内核并实测性能,建立形状-最优内核的映射表,后续相同形状直接复用。
Owner 负载均衡。预先记录各矩阵形状的真实计算耗时,以"最慢矩阵耗时最小化"为目标分配任务,避免部分 GPU 空闲等待。
综合测算,DMuon 将具身模型分布式训练效率提升约 30%。代码已完全开源,与 Muon 训练框架兼容,引入仅需 3 行代码。
从"手工作业"到"生产线"改造
具身模型行业起步晚于大语言模型,多数企业长期依赖调用现成技术框架,目标集中于训练出好模型、榜单评测争先。但模型迭代需要持续积累,训练"生产线"的效率同样关键。
自变量机器人此次向底层基础设施突破,意味着头部具身模型企业开始走出单点模型优化的"手工作业"阶段,投向工程化生产提效。此前 Muon 的技术贡献主要来自 Kimi、DeepSeek 等大语言模型企业,全球范围内尚无具身模型公司完成同类成果。DMuon 的开源发布,使行业开发者能以极低门槛引入生产,成为具身智能领域向技术社区的一次实质性回馈。