自变量发布跨模态具身动作分词器X-Tokenizer,多模态对齐能力提升13.5%,长程任务性能提升8.25%
声明:文档由AI根据原文生成。
重新定义动作分词:从压缩工具到语义接口
自变量机器人科技发布跨模态具身动作分词器 X-Tokenizer,将 VLA(视觉-语言-动作)模型中的动作离散化问题,从单一的"压缩-重建"重新定义为"多模态推理与动作之间的语义接口学习"。
具身智能的 VLA 模型通常将预训练的 VLM(视觉语言模型)与动作专家(Action Expert)相连:VLM 接收图像和语言指令后输出隐藏状态,动作专家再将其转化为机器人可执行的连续动作指令。但两者存在表示方法的不匹配——VLM 输出离散表示,而机器人需要连续指令。动作分词器(Action Tokenizer)的作用正是将连续动作拆分为离散表示,供预训练使用。自变量机器人发现,分词器拆分出的动作 Token 是否具有语义、能否加速预训练收敛,最终直接影响 VLA 模型输出连续动作的性能。
语义残差量化架构:分离动作意图与几何细节
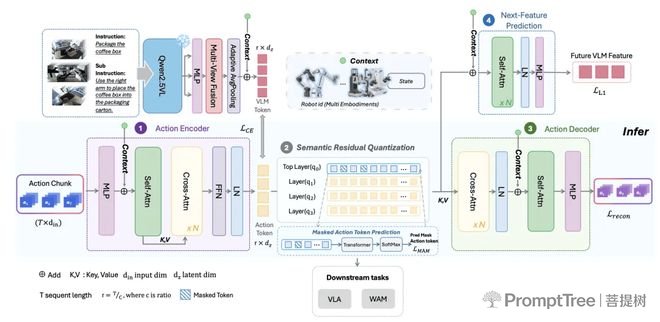
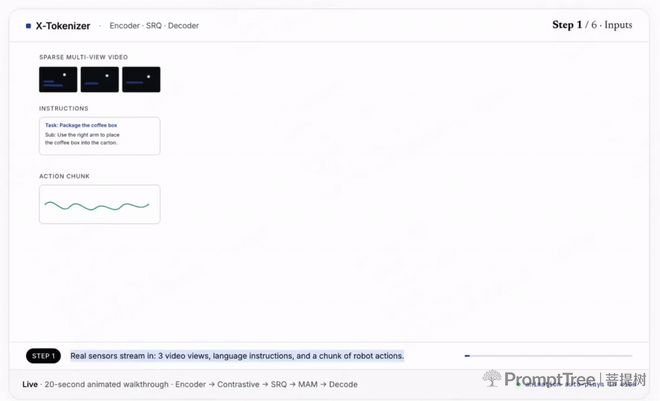
X-Tokenizer 采用"编码器-语义残差量化(SRQ)-解码器"轻量级架构,以 SRQ 替换传统标准残差向量量化(RVQ),在量化层分离动作意图。该模型在涵盖17个机械臂系列的240万条轨迹(含20亿动作帧)上完成预训练。
与 FAST、VQ-BeT 等仅以最小化重建误差为目标的传统分词器不同,X-Tokenizer 对残差量化施加监督:第一层通过掩码动作建模(MAM)学习粗粒度动作意图,形成离散动作语言;第2-4层保留细粒度几何残差。同时引入两类跨模态监督信号——与预训练 VLM 表征空间的对比对齐、未来帧视觉-语言特征预测——使动作 Token 在预训练阶段即与视觉、语言语义共享同一表示空间。
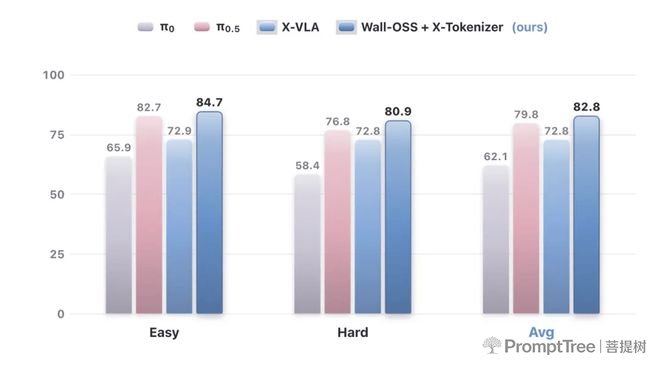
预训练完成后,X-Tokenizer 作为可复用表示模块冻结插入 VLA 主干。实验显示,相比 FAST,其多模态对齐能力提升13.5%,长程任务性能提升8.25%,RoboTwin 2.0 得分达到82.8。
抗噪声能力:意图层与噪声层的分离
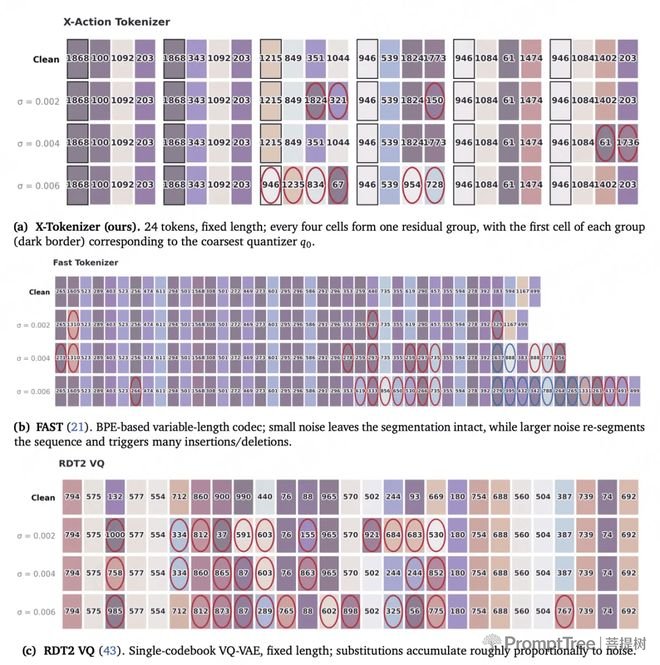
传统 RVQ 在重建动作时,所有层级面对相同的重建损失,趋向均匀分配,拆分出的 Token 仅为纯几何表示,缺乏特定动作语义。SRQ 的创新在于将粗粒度动作意图与细粒度几何修正拆分至不同层级:第1层捕捉更多动作语义,第2-4层保留更多重建细节。
通过掩码动作建模(MAM)、Vision-Language Feature 对比对齐、下一帧 Vision-Language Feature 预测三类语义监督信号,SRQ 实现了出色的抗噪声效果。当动作被注入噪声时,SRQ 拆分的动作 ID 几乎保持不变——在 σ=0.008 的噪声下,词错误率(WER)为0.526,噪声被第2-4层吸收,识别出的动作意图保持稳定。相比之下,FAST 的动作 ID 序列长度发生改变,WER 高达1.445,无法区分主要动作与噪声,出现语义反转。
这些监督头仅在预训练时使用,推理阶段移除,不带来额外性能开销,动作知识沉淀于 SRQ 网络结构中。
真机验证:视觉-动作语义对应与跨机型知识共享
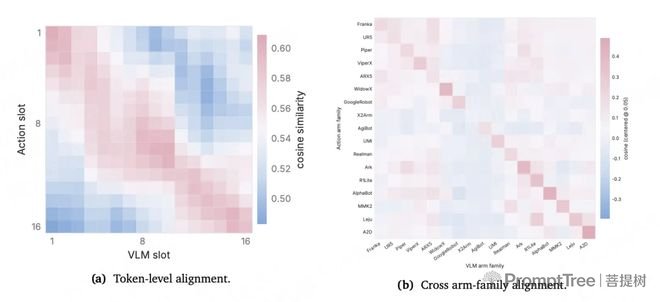
自变量机器人通过 Slot 热力图验证了视觉-动作对齐效果。将64帧动作块压缩为16个 slot,每个对应一小段动作序列,VLM 特征同步压缩至16个时间步,计算两者余弦相似度矩阵。结果显示,中段余弦值峰值约0.6,呈现较高相关性;多种机械臂实验中,对角线均为正值,形态相似的机械臂之间表现出强相关性。这表明 VLM 模型学到了动作与视觉的语义对应关系,且形态相近的机械臂可共享知识。
在 RoboTwin 2.0 基准评测中,WALL-OSS + X-Tokenizer 在简单和困难任务中均超过 Pi 0、Pi 0.5 和 X-VLA 等业界主流模型,困难任务中领先优势更为明显,说明视觉条件变化时,动作与其他模态的对齐对任务完成更具价值。
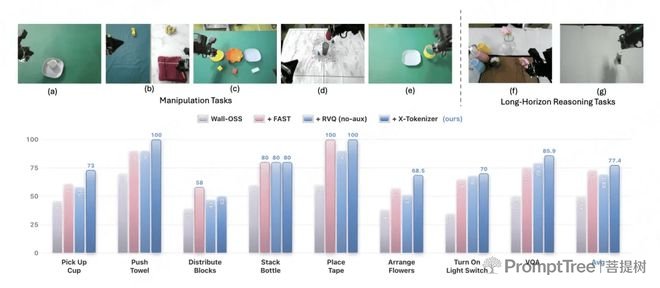
真机测试覆盖7个桌面任务(5个短期操作+2个长程推理),比较了四种方法:原始 WALL-OSS 模型、FAST 动作分词器、仅重建动作的4级 RVQ 分词器,以及完整 X-Tokenizer。X-Tokenizer 优于或打平其他方法,长程推理任务提升8.25%。