自变量、PI相继开源,VLA SOTA模型发展到什么水平了?
声明:文档由AI根据原文生成。
开源节奏加快:两家SOTA模型前后脚亮相
2月4日,Physical Intelligence(PI)开源了当时最先进的VLA模型π0。七个月后,中国公司自变量机器人在9月8日推出端到端具身智能基础模型WALL-OSS,采用紧密耦合的MoE架构,支持动作生成与推理,并第一时间在Hugging Face开源了权重。一天之后,PI的π0.5也在GitHub开源。两家公司的CTO王昊与研究员柯丽一鸣(Kay Ke)在近期一档对话节目中,也谈及了各自的开源计划。
这一节奏让人联想到大语言模型的开源史:Meta 2022年发布OPT、2023年LLaMA 1代码与权重外泄后引发社区热潮,斯坦福Alpaca等衍生模型相继出现;DeepSeek R1则以6710亿开放权重进一步模糊开源与闭源边界。VLA领域的两轮密集开源,正在复刻类似路径。
两大核心挑战:跨模态训练与物理常识缺失
两家模型面临相似的结构性难题。互联网数据上预训练的VLM/LLM虽赋予机器人一定泛化能力,但距离真实物理世界中的可靠行动仍有明显落差。
跨模态协同训练是首要瓶颈。VLM本质上是"非具身"的——它缺乏在物理空间中理解动作、生成可执行指令的能力,既无法通过环境交互获得反馈修正,也不能输出连贯的机械控制信号。业内常做的类比是:这类AI更像一个只通过书本和图片学习游泳理论的人,下水后并不知道如何协调身体。
物理常识的匮乏则加剧了落地难度。视觉语言模型对空间关系、物体 affordance、动作后果的建模薄弱,导致"看得懂"与"做得出"之间存在断层。
技术解法:动作专家、知识绝缘与紧密耦合
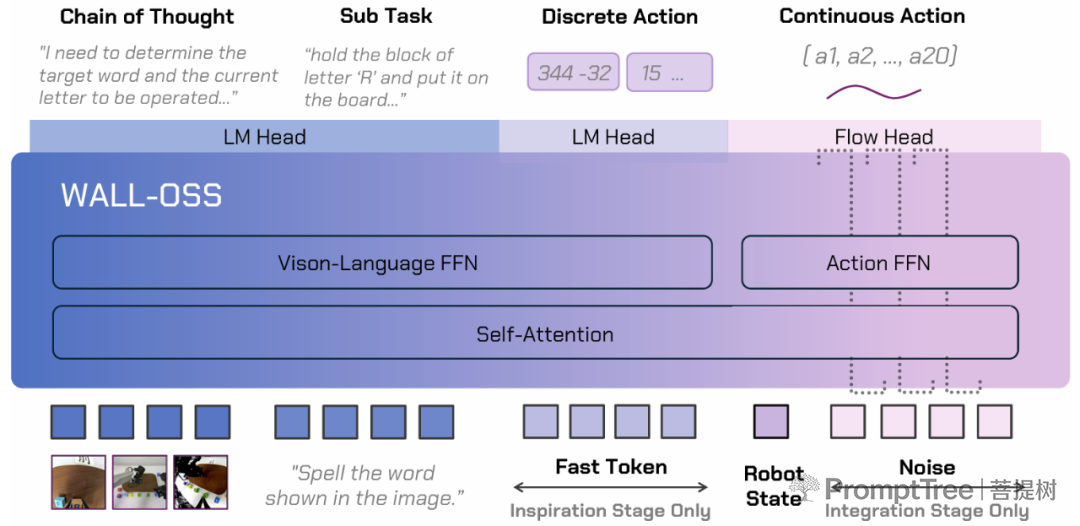
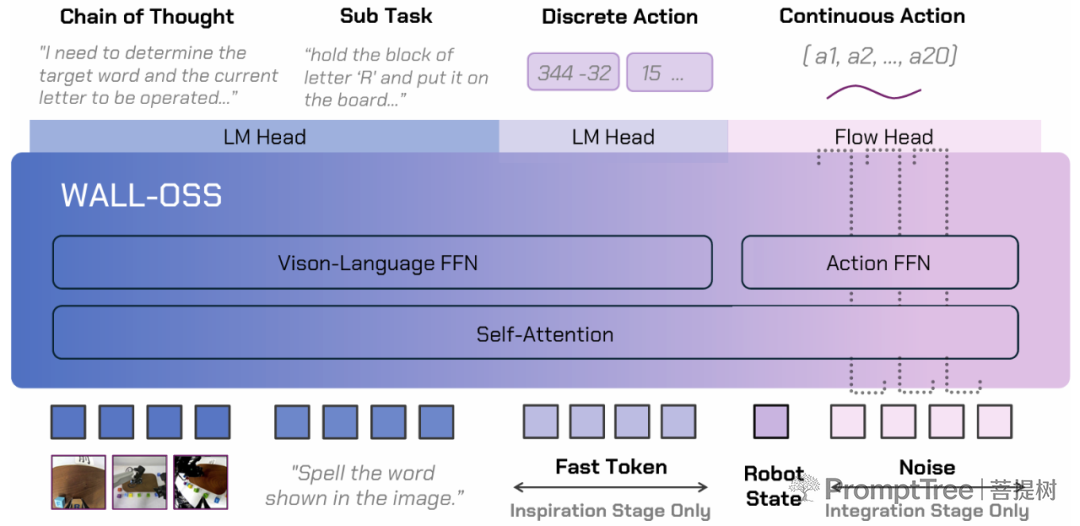
针对动作表达的难题,π0率先引入独立的"动作专家"分支,采用Flow Matching直接建模连续动作分布;PI后续又提出FAST tokenizer,将高频精细的机械臂关节变化转为离散token,便于Transformer处理。自变量机器人延续了Flow Matching路径,同时采纳了FAST tokenizer方案。
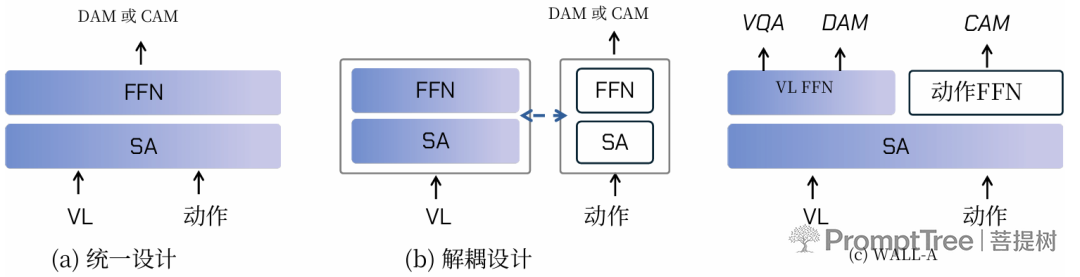
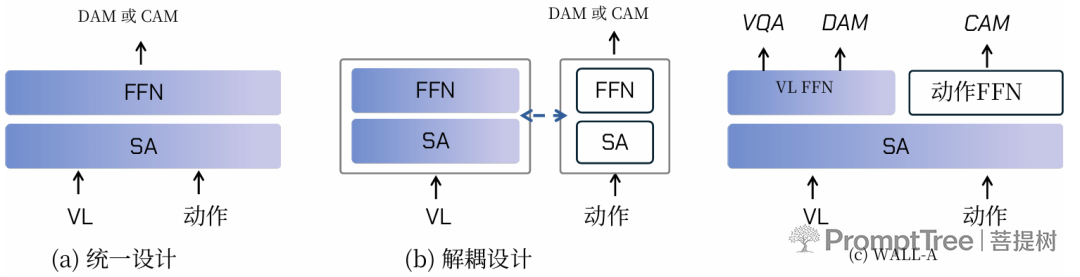
训练过程中的干扰问题更为棘手。MoE架构下,新加入的"动作专家"初始参数随机,其错误产生的反向梯度会"污染"VLM主干已习得的知识。PI的应对是"知识绝缘"——在训练时保护VLM主干不受动作专家干扰。WALL-OSS则走了另一条路:让视觉语言专家与动作专家共享注意力等核心认知模块,但在执行层保留各自专属网络,实现"紧密耦合"。这种设计既维持专业性,又保证语言指令向动作的高效传导。
长推理与具身语义:让模型"会思考"
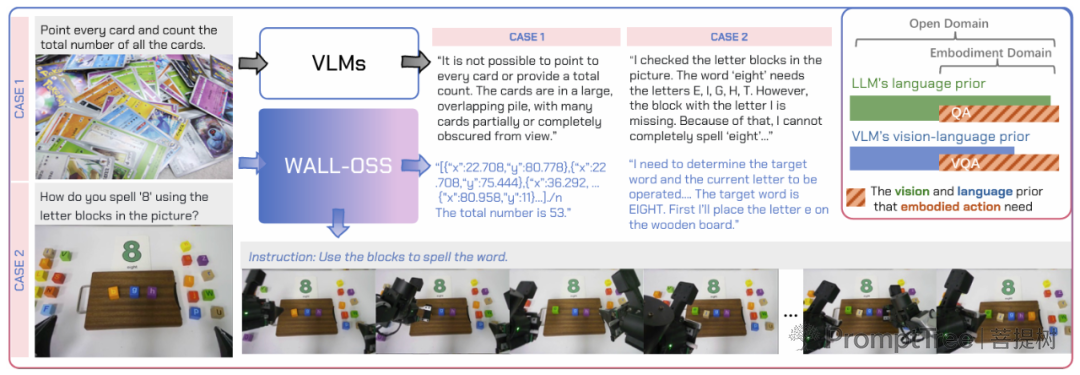
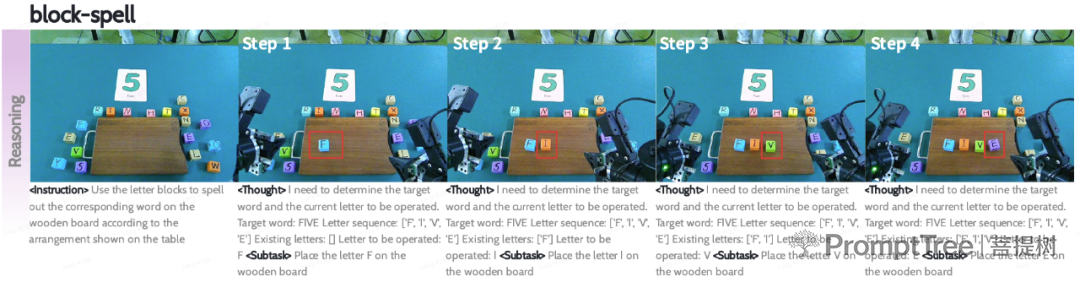
π0.5采用层次化推理,先输出高层子任务(如"pick up the plate"),再由动作专家生成连续动作。WALL-OSS在此基础上强化了思维链(CoT)能力:面对"整理书桌"这类模糊指令,模型内部会先拆解为"识别垃圾—丢弃—摆放书本"的子任务规划,再逐条执行,全程无需外部模块介入。
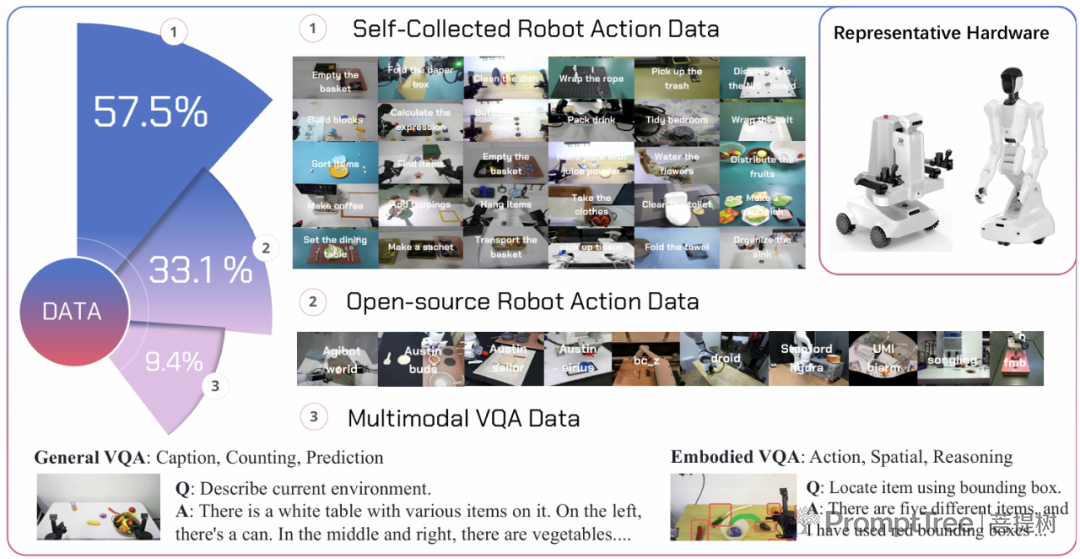
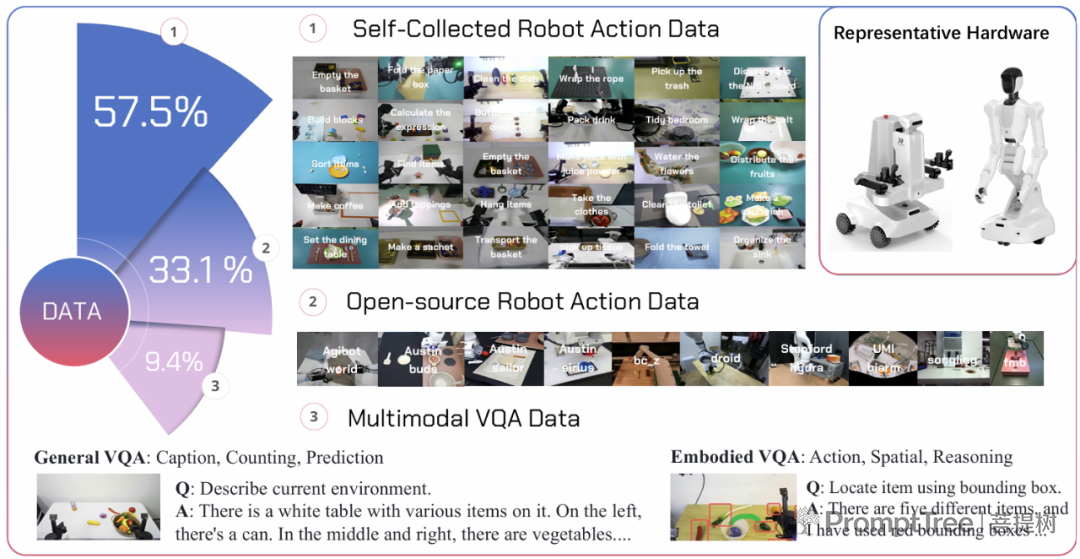
为弥补物理常识短板,两家模型在数据策略上各有侧重。π0.5在预训练中混入互联网图像描述、VQA与目标定位数据,以提升对未见过物体类别的指令跟随能力。WALL-OSS则设计了两阶段预训练——"灵感"(Inspiration)与"整合"(Integration),并引入具身VQA数据增强空间推理;其数据集规模达数万小时,由自采机器人动作数据、开源跨本体数据与多模态VQA数据三部分构成。
实测表现:零样本泛化与长程任务
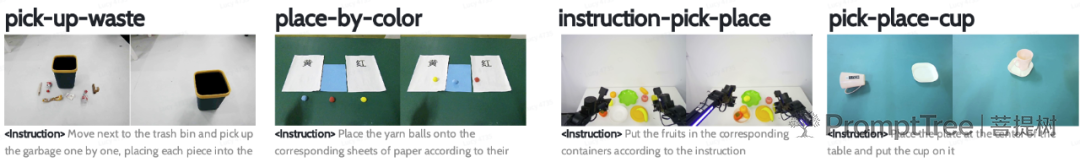
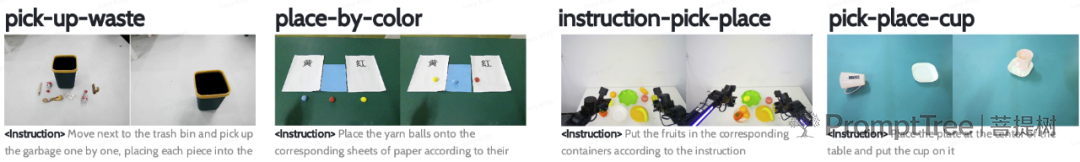
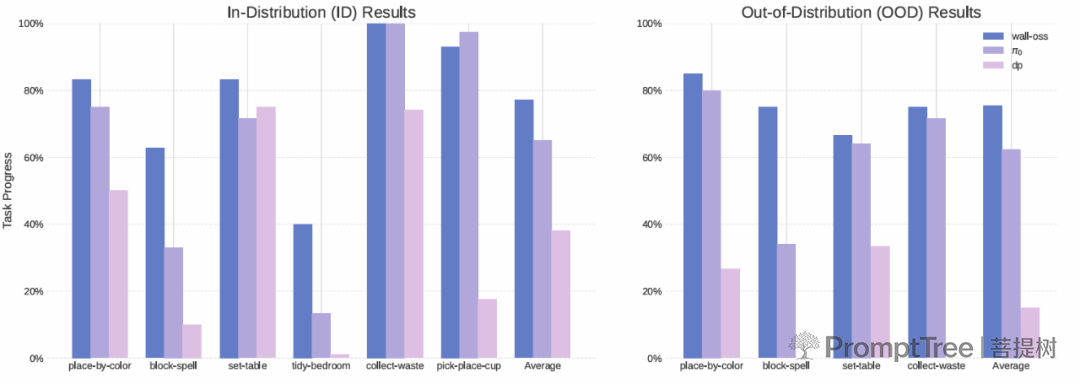
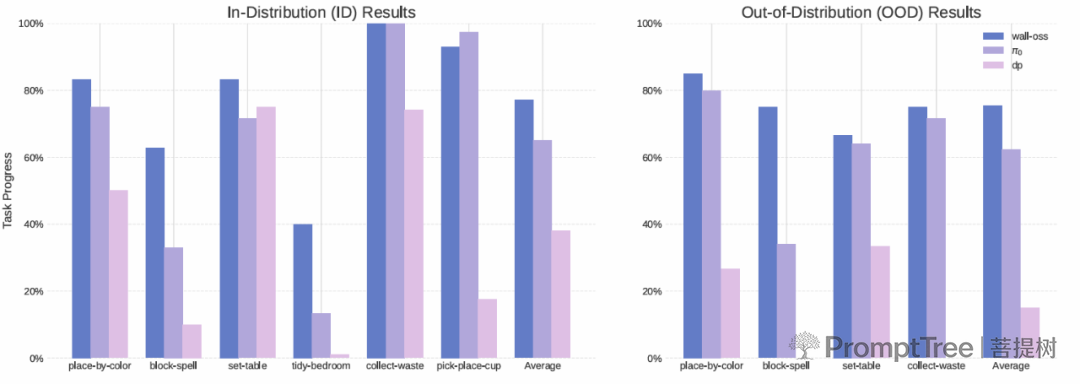
实验结果显示,WALL-OSS在多项指标上表现突出。捡垃圾、摆放杯子等任务中,面对新环境与新物体仍保持较高成功率;动作生成的文本对齐度与执行精度优于π0与Diffusion-Policy。零样本测试里,已见过物体的pick-and-place任务平均完成度85%,全新物体达61%。
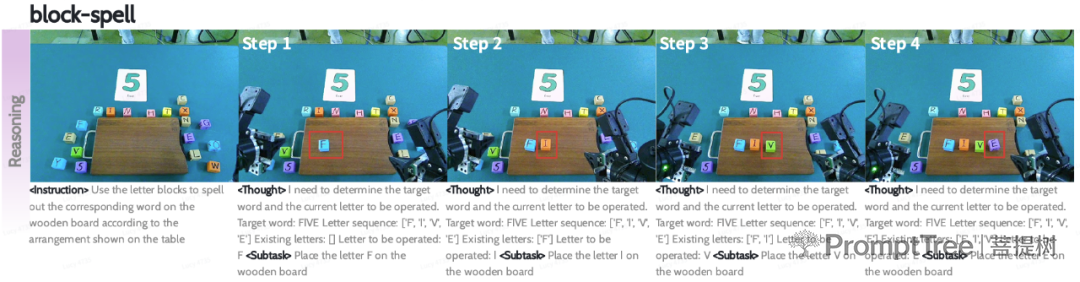
长程复杂任务是其差异化优势。整理卧室、布置餐桌等多步骤场景中,其他模型常出现步骤遗忘或重复无效动作,WALL-OSS凭借子任务规划能力可稳定推进。在字母积木拼单词等需逻辑推理的任务中,模型展现出"先思考答案、再规划动作"的行为特征。