临近机器人GPT-3时刻,具身智能开源模型的加速演进
声明:文档由AI根据原文生成。
中美同日开源,具身大模型进入爆发期
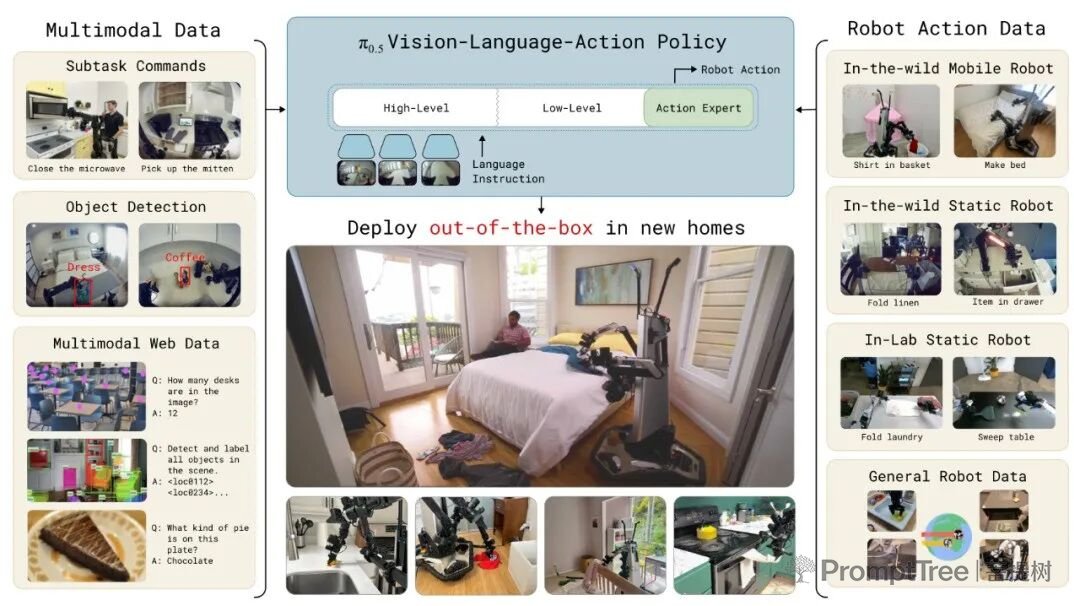
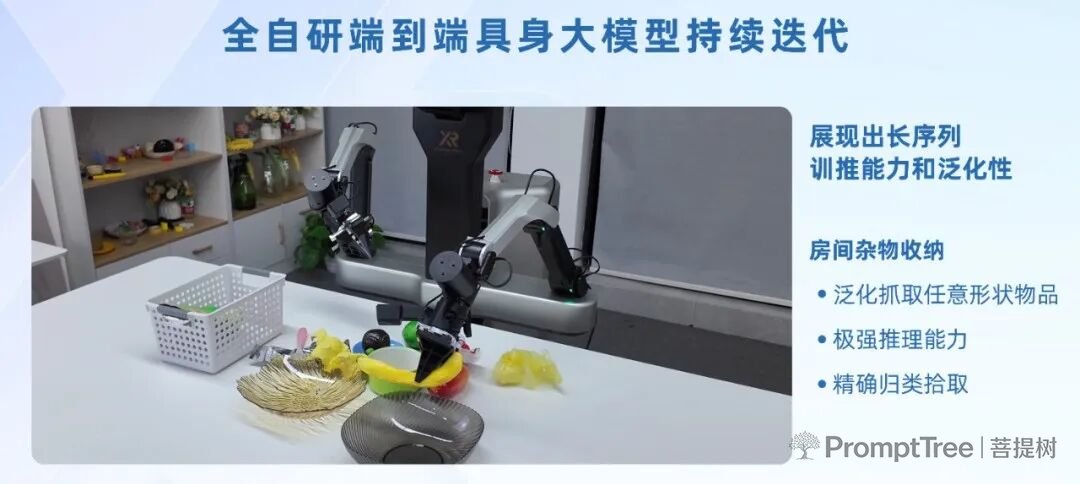
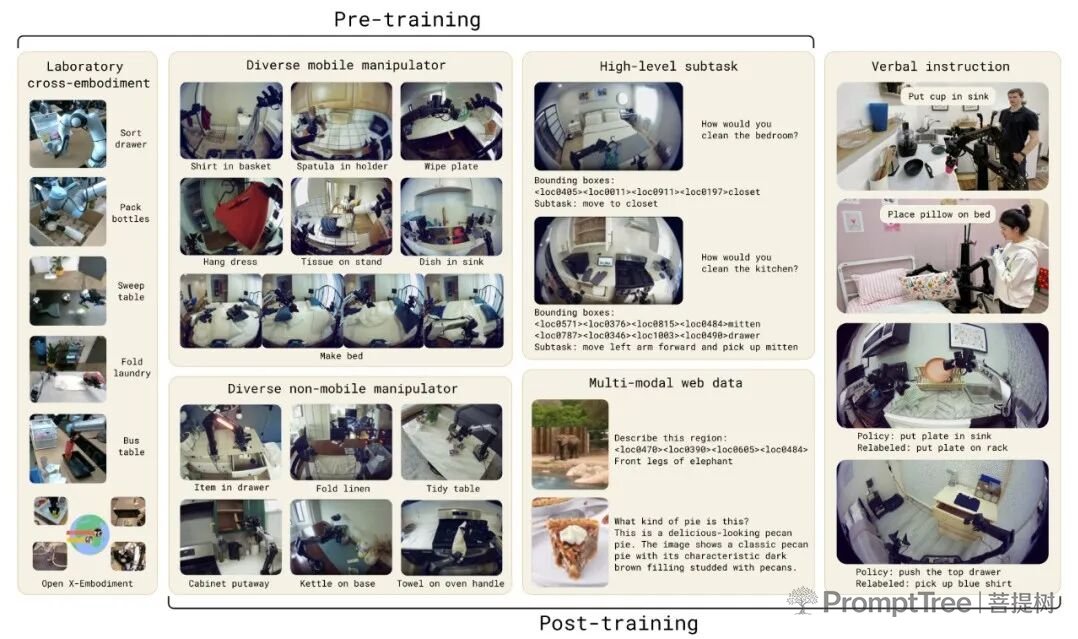
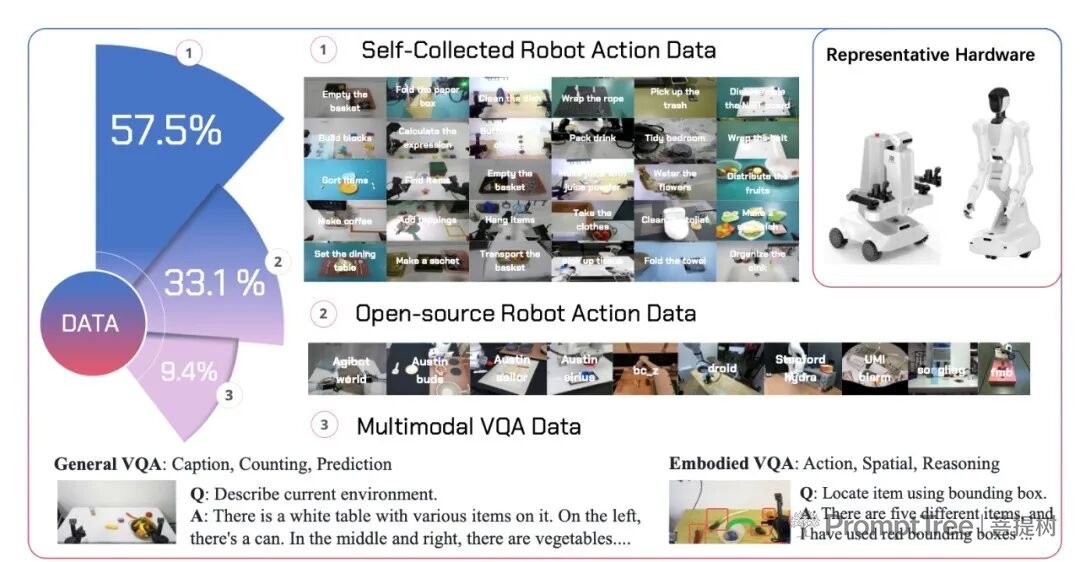
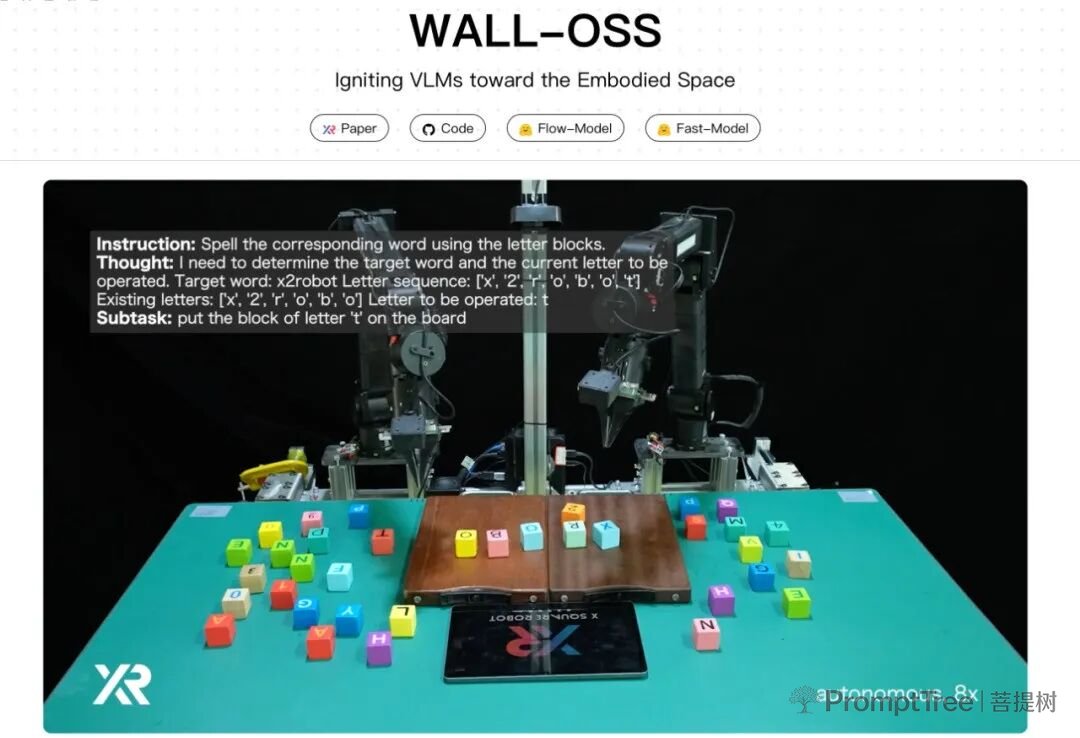
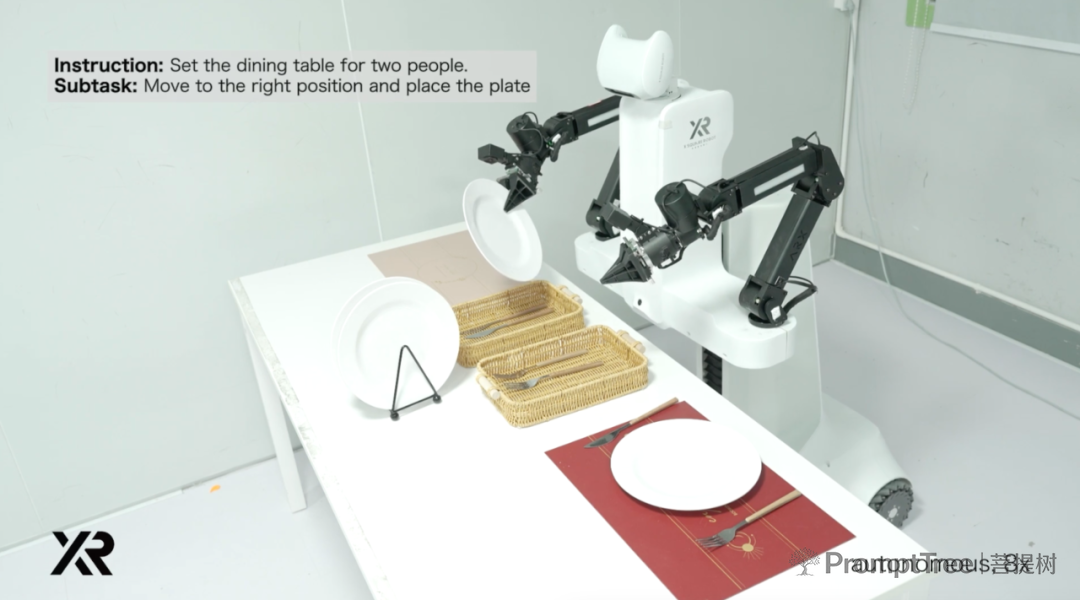
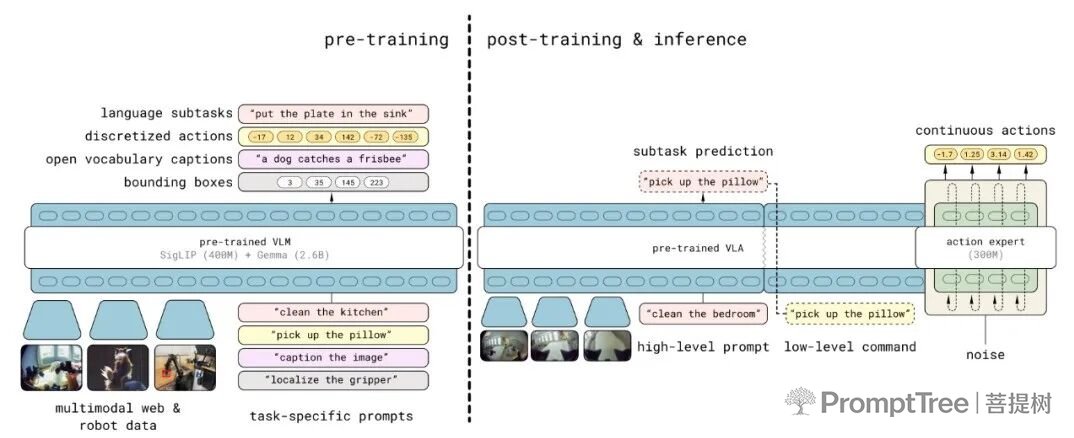
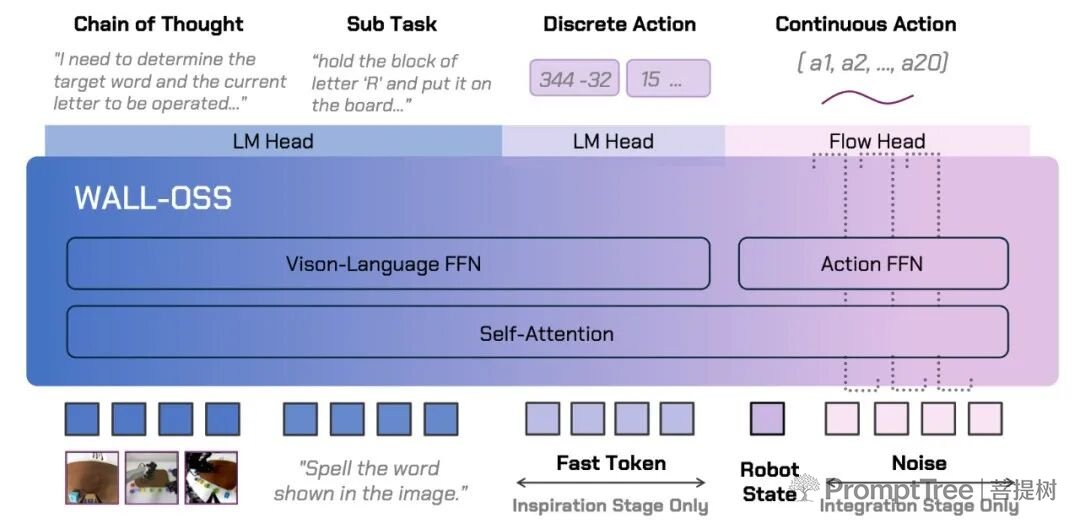
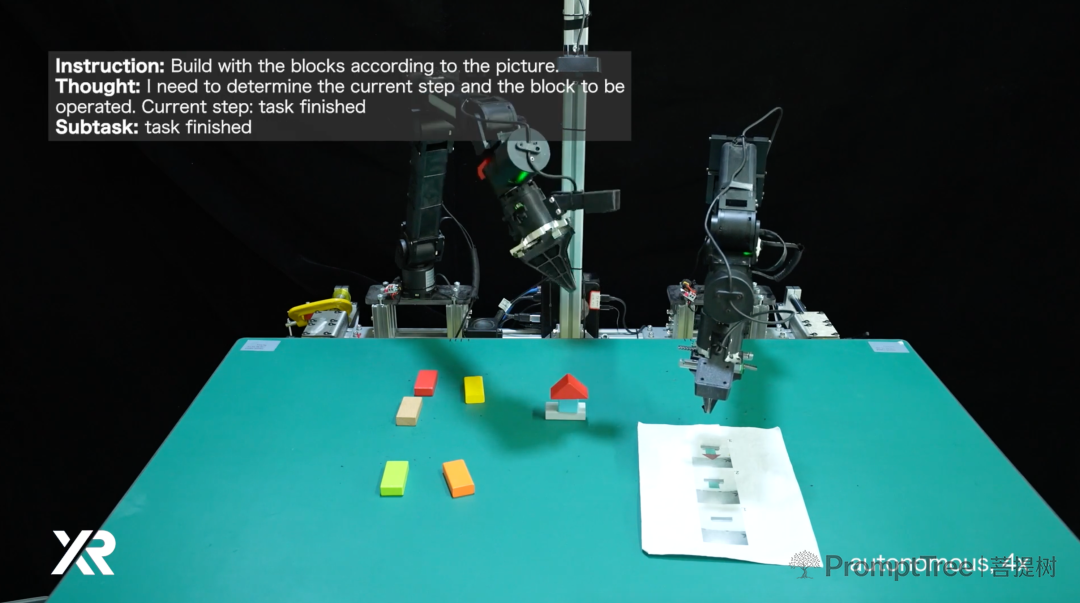
9月8日,中国具身智能公司自变量机器人开源其基础模型WALL-OSS;次日,美国公司Physical Intelligence(PI)开源π₀.₅模型。两家公司的动作仅隔一天,这并非巧合——2025年,具身大模型的开源生态正进入密集落地阶段。
这一态势让人联想到语言大模型的演进:从2018年开源社区初兴,到2020年GPT-3引发全球关注,用了约三年。机器人大模型距离属于自己的"GPT-3时刻"还有多远?
从单任务到"指数效应":泛化与长程任务成关键词
柯丽一鸣从事机器人研究约七八年。她回忆,早年做"小而精"的特定任务时,一套方案在一个场景效果不错,却"很难便宜、便捷地复制到新问题上"。探索大模型过程中,最大的惊喜是"验证了模型的通用性",这才有条件讨论性能提升和机器人大模型的可能性。"现在比起两三年前,对大模型技术路线的信仰要浓厚得多。"
王昊观察到,2023年前行业多专注单个任务极致优化;有了统一基础模型后,"能够同时学习并执行成百上千种不同任务",优化目标转向"提升整个模型在所有任务上的平均成功率"。这构成了指数效应的基础,也使得复杂长程任务(Long-Horizon Task,需多步推理规划的连续步骤任务)成为可能。
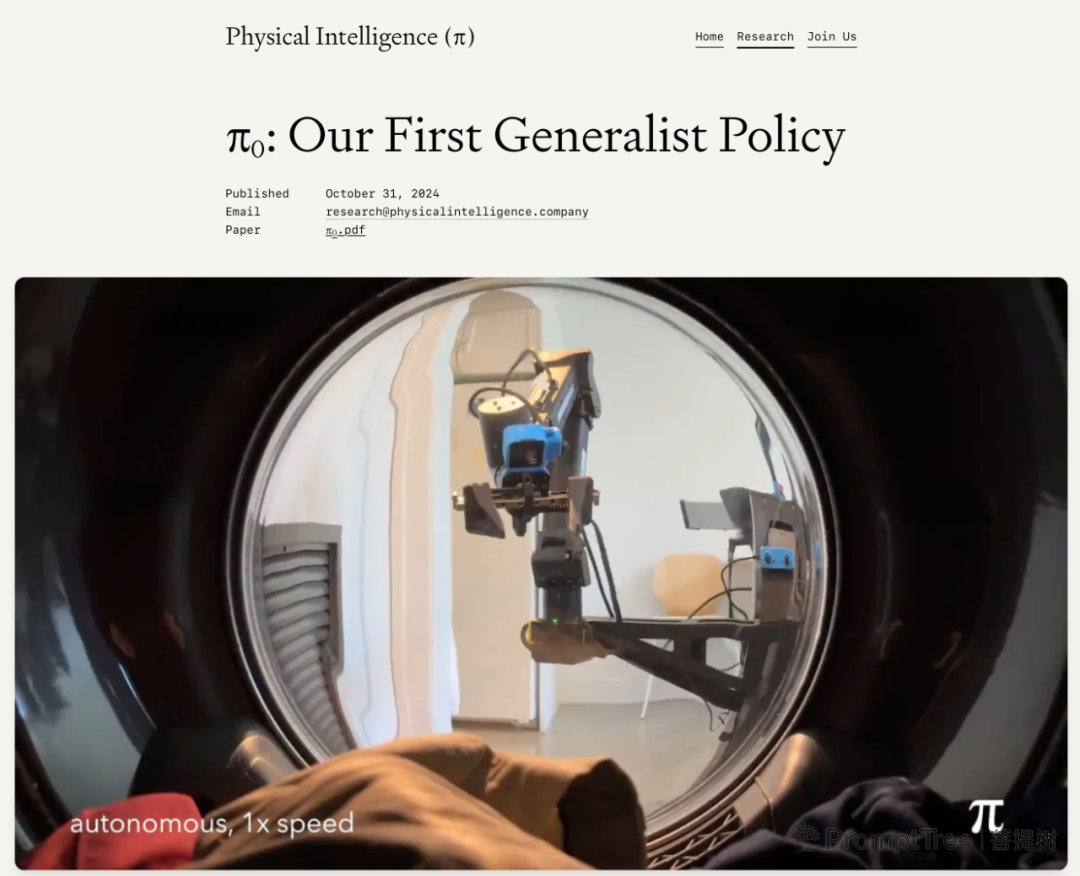
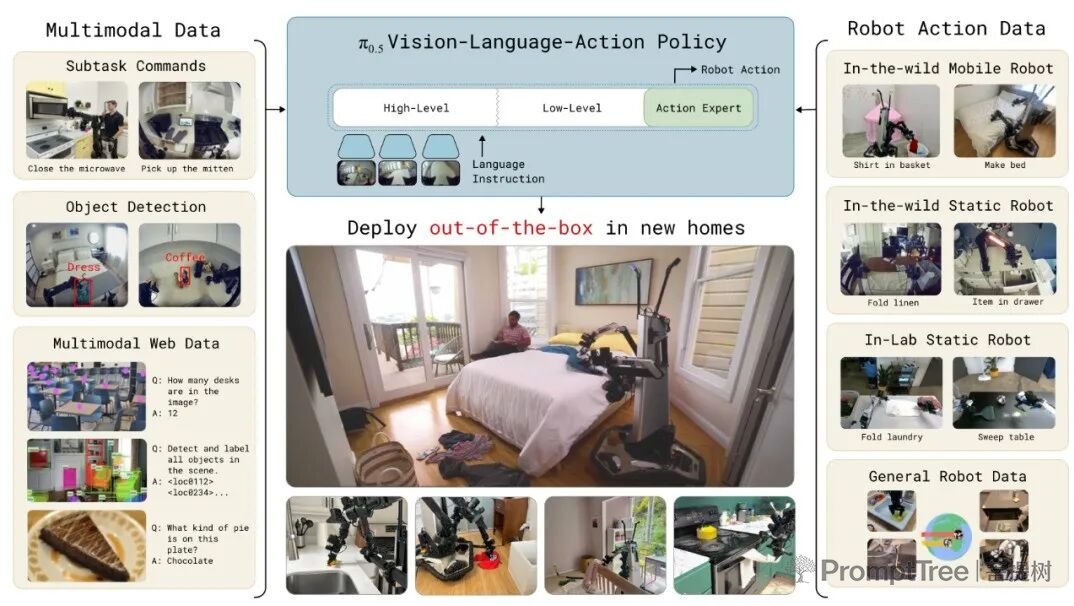
以叠衣服为例,柯丽一鸣解释,这一"对人很简单"的任务在机器人界研究了十几到二十年:衣服折痕数量、角度不同,对机器人都是新情况;步骤序列性也增加了复杂度。2024年PI发布π₀时,叠衣服已是代表性泛化案例。到2025年,团队将π₀.₅装入移动机器人,放入训练集未包含的新家庭环境测试,"虽然表现不完美,但展现出一点像人类的特性,拿东西换到别的家还是能拿"。
抓取问题是另一层考验。柯丽一鸣指出,即便相同水杯,不同环境也需要不同策略;未来要实现的彻底泛化,是"不管去了一个新的家、拿了一个完全不一样的杯子,都要能完成"。
三大瓶颈:评测缺失、数据两难、硬件维护
谈及研发难点,王昊和柯丽一鸣各列出三项。
王昊认为,物理世界的长尾鲁棒性是核心挑战。环境、光照造成的视觉误差,桌布褶皱、杯子不稳、透明物体反光等corner case(边角案例),"没法让机器提前学习"。更棘手的是,长程任务中微小物理扰动造成的误差会"像滚雪球一样被放大",最终导致失败。解决方向是构建"能理解物理常识、有物理直觉"的模型基础,但这需要"真实数据、人类视频数据等合在一起",而高保真的真实交互数据目前稀缺,"不止是数据量的问题,还是数据工程、数据管线的问题"。
柯丽一鸣补充,机器人领域数十年来"一直没有办法在真机世界中做出一个榜单",无法客观、公正、可重复地比较模型A与模型B。发表论文时,研究者往往"既当作者、又当测评官",缺乏统一评价机制使行业发展受限。业界已开始探索模拟器和第三方擂台式评测标准。
数据的质量与数量则是"鱼和熊掌不可兼得"。柯丽一鸣表示,追求高质量需精心设计、勤勤恳恳清洗,追求数量便有难度。她提出一个"暴论":假设人一生约100万小时,"什么时候能收到等同于一个人一生的物理经验的数据,可能才能开始后面的探索"。目前公开信息中,尚未见如此规模的数据集。
王昊解释,与人相比"对机器人不公平",因为人经过生物进化"预训练",基因中写入了物理世界交互策略;且人学习是多任务并行,能从不同任务中习得底层共同物理结构。自变量的做法是用尽可能多样的数据覆盖各种能力任务,"让机器人从这个学习过程中理解物理规律",使新任务所需数据量大幅减少。
硬件维护是第三项瓶颈。柯丽一鸣笑称"天天都在拧螺丝",至今"没有一个大家都非常认可、都愿意拥抱的硬件平台",甚至硬件应该长什么样仍在争论。泓君补充,机器人研究员聚会时"白天啥都没干,专门在修手"。
技术路径:端到端训练,推理可分层
关于模型架构,王昊明确自变量"非常相信数据驱动的端到端模型",WALL-OSS即基于此架构:语言、视觉、动作在同一空间表征对齐,"分层会带来信息损失"。但推理时可做优化——慢速任务过程放云端,快速任务过程放物理端侧,"再由梯度回传更新整个系统参数"。
柯丽一鸣表示PI持开放态度,"一切工作还是为了数据驱动在服务"。她注意到,三四年前行业方向分散,"自从VLA(视觉语言动作模型)出世以后,反而越来越趋同化了"。此前做车、做手、做人形各不相同,现在"很多人开始想说能不能把这些东西糅合在一起"。
对于当前阶段,两人判断略有差异。柯丽一鸣认为机器人大模型"还没有达到GPT-2的时刻";王昊则认为"已经到了GPT-2阶段"——GPT-1是概念验证,GPT-2验证了规模化力量,"现在基本上已经知道规模化是唯一的可靠路径"。他预测1~2年内可达到GPT-3水平。
中美路径:自上而下与双轨并行
中美发展路径的差异是对谈另一焦点。
王昊分析,美国"自上而下的不计成本",优先做接近AGI的超大模型,"最顶级的芯片、最大量的算力集群都在美国"。中国芯片受限,倒逼企业在有限算力下追求效率;但中国拥有全球最大互联网移动应用场景和完善的硬件产业链,"国内更像是上下结合,双轨并行"——既考虑通用泛化场景,又迭代通用基础模型能力,"更快地让机器人在现实世界获得反馈,形成数据飞轮"。
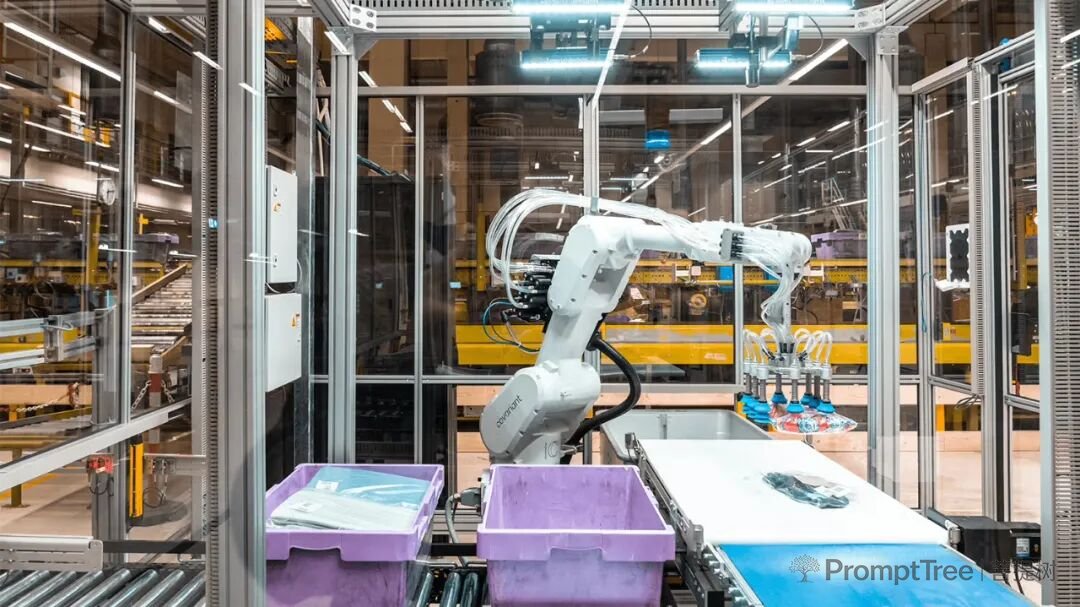
柯丽一鸣从历史生态角度补充:国内经济高速发展经验使创业者倾向"解决问题、解决用户需求",深耕垂直领域;制造业优势也使硬件需求旺盛。美国方面,PI等公司的出现"恰巧"因为OpenAI做通了大语言模型,"给整个行业一个反思和震撼"。她提及前辈公司Covariant Robotics,早年也想做通用,但因物流业务过于成功而被记住另一面,"现在的很多企业和研究者就是受到他们的经验的启发,选择走了现在的路"。
落地时间表:家用机器人5年可期?
家用场景被视为具身智能的终极测试。王昊认为做家务是"完美的图灵测试",包含精细动作、丰富感知、长程规划和意外处理等全部挑战。他预测:两三年内可在半结构化环境(如限定厨房)做简单任务;完全开放的厨房环境需约5年,"允许机器人与人协作、获得人类帮助"的前提下。
柯丽一鸣给出5~10年的保守估计,类比扫地机器人"最早的版本其实不完美,需要用户明白它能做什么、不能做什么"。她好奇的是,以产业化为目标的公司如何兼顾商业化与研发。
王昊回应,自变量的策略是"尽可能不去碰比较封闭的场景",选择公共服务、养老服务等与最终通用场景接近的领域,"涉及复杂任务也涉及不那么复杂的任务",以此迭代模型能力、获取数据反馈。他认为家用机器人"很有希望"形成足够销量,硬件成本随产业规模扩大仍有大幅下降空间,"模型水平提升加上硬件成本降低,几年后价格会让用户接受度更高"。
开源生态:降低门槛,站在巨人肩上
两家公司对开源持积极态度。柯丽一鸣说,看到模型"在一些我们自己都没想到的机器人上面跑起来了",很开心;开源也是变相降低研究入门门槛。王昊认为"开源意味着我们可以站在巨人的肩膀上继续前进",社区反馈帮助开源公司"把技术路线思考得更加深入",高校和小型企业可用基础模型做应用,"丰富整个生态"。
他观察到,大模型时代AI研究与大模型前"很不一样":过去研究离散,以论文发表为要务;现在有社区和开源体系后,"大家更在乎怎么在一个工程化体系下,把这个工程基础打好"。