π0.5开源前,国内也开源了一个强大的端到端统一基础模型!具备强泛化和长程操作
声明:文档由AI根据原文生成。
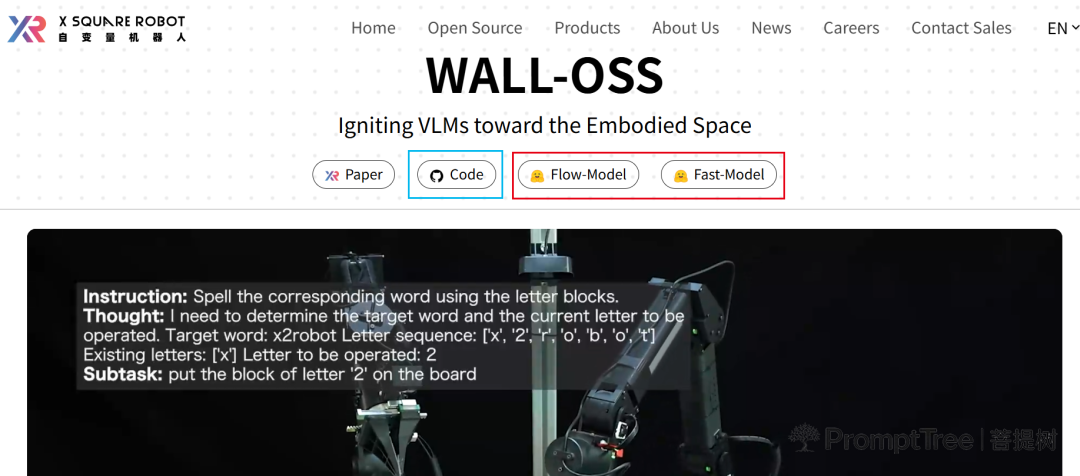
自变量机器人开源端到端具身模型WALL-OSS
在Physical Intelligence开源π0.5的前一天,自变量机器人于2025年10月15日公开了其端到端具身智能基础模型WALL-OSS的完整方案,包括预训练模型权重、训练代码、数据集接口及部署文档。开发者可在自有机器人上直接跑通闭环流程,仅需RTX 4090级别显卡即可完成从训练到推理的全过程。
现有VLA模型的结构性困境
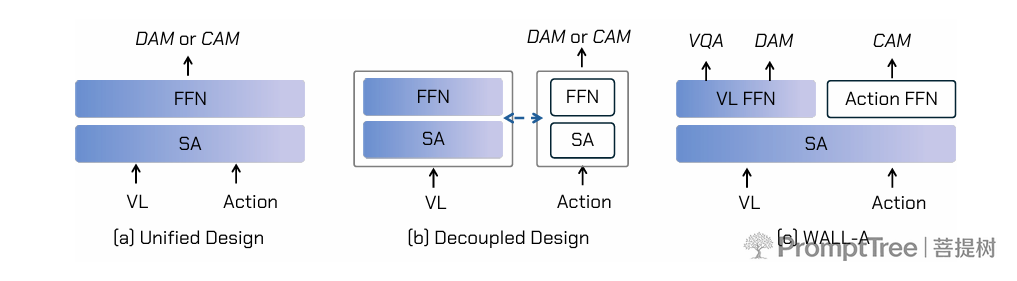
当前视觉语言动作(VLA)模型主要存在两种设计范式。混合设计如RT-2、OpenVLA,通过离散或连续动作建模直接扩展原始VLM,但动作监督会显著扰动VLM权重分布,导致动作过拟合与泛化退化。解耦设计如π0,采用独立动作预测分支与VLM松耦合交互,却削弱了动作预测的指令遵循能力。
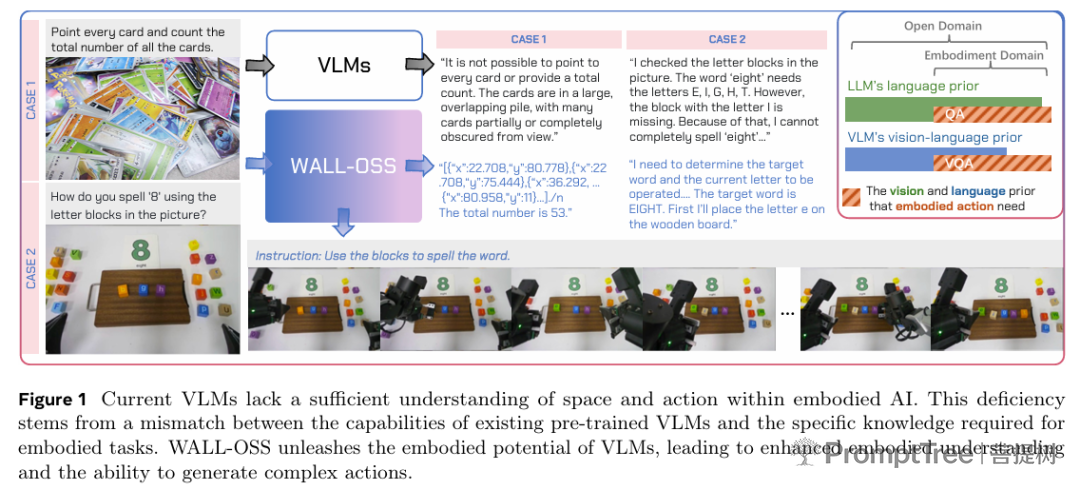
现有视觉语言模型向具身领域迁移时,暴露出模态间、数据分布与训练目标的根本性错配,动作理解与生成成为核心瓶颈。
紧耦合架构与三阶段训练
WALL-OSS以QwenVL2.5-3B为主干网络,采用紧耦合架构与多策略训练,在单一可微分框架内整合指令推理、子目标分解与细粒度动作合成。
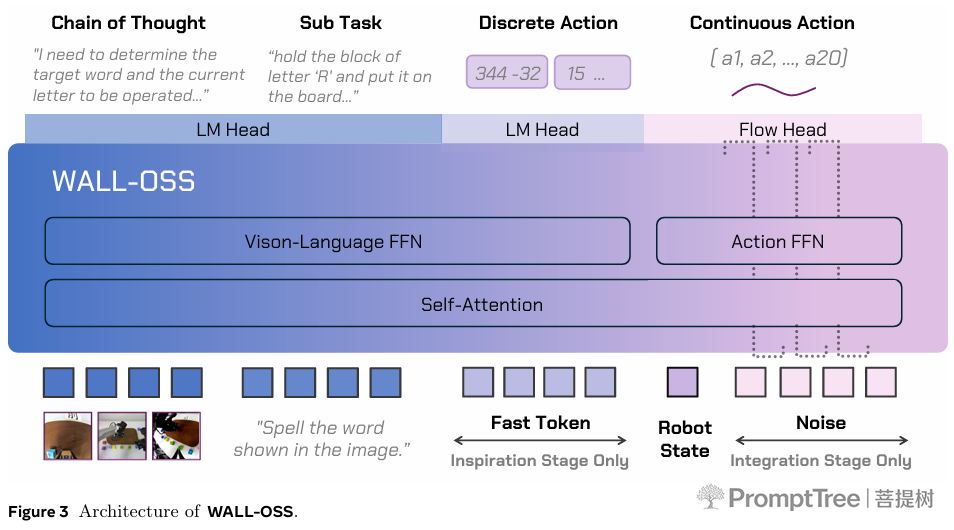
训练分为"先离散、后连续、再联合"三阶段。启发阶段重用预训练VLM前馈网络,通过具身视觉问答增强空间推理,引入FAST tokenization获得的离散动作token,建立粗略的语义grounded动作感知。整合阶段先冻结VLM仅训练流匹配头,再解冻联合优化,通过静态路由器实现特征分流:动作中心特征导向Action FFN,视觉-语言特征导向Vision-Language FFN。
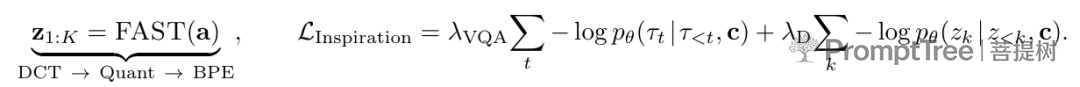
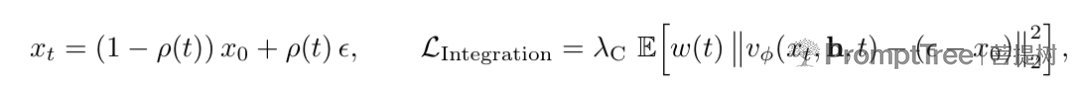
统一跨层级思维链
WALL-OSS将思维链从传统狭义形式扩展为涵盖语义到感觉运动的广义链条:指令→推理→子任务计划→连续动作。现有方法如Hi Robot、GR00T N1通常将各级别分解为pipeline或多模块系统,引入不可微分接口与跨阶段误差累积。WALL-OSS的单一端到端模型支持灵活的前向任意映射,可根据任务复杂度自适应调用完整推理步骤或直接映射到动作,甚至实现推理与执行交错,为实时人机交互提供异步控制能力。
大规模真实场景数据
自变量机器人坚持以真实世界数据为主要来源,构建了数万小时的多源数据集,包含三项互补组件:自收集机器人动作数据、开源跨形态跨环境动作数据、以及多模态视觉问答数据。
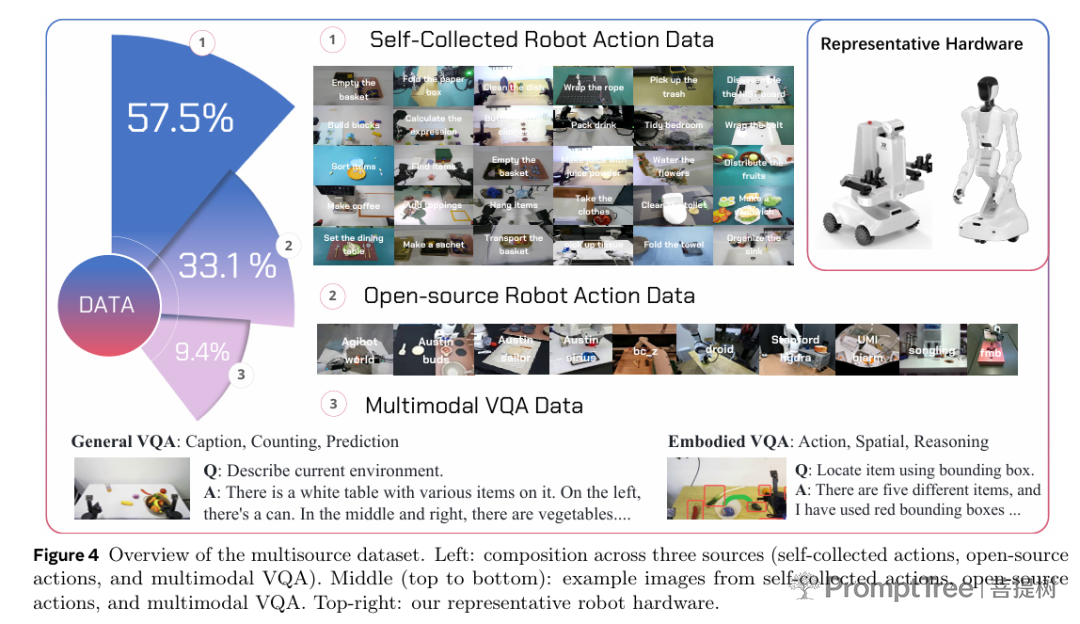
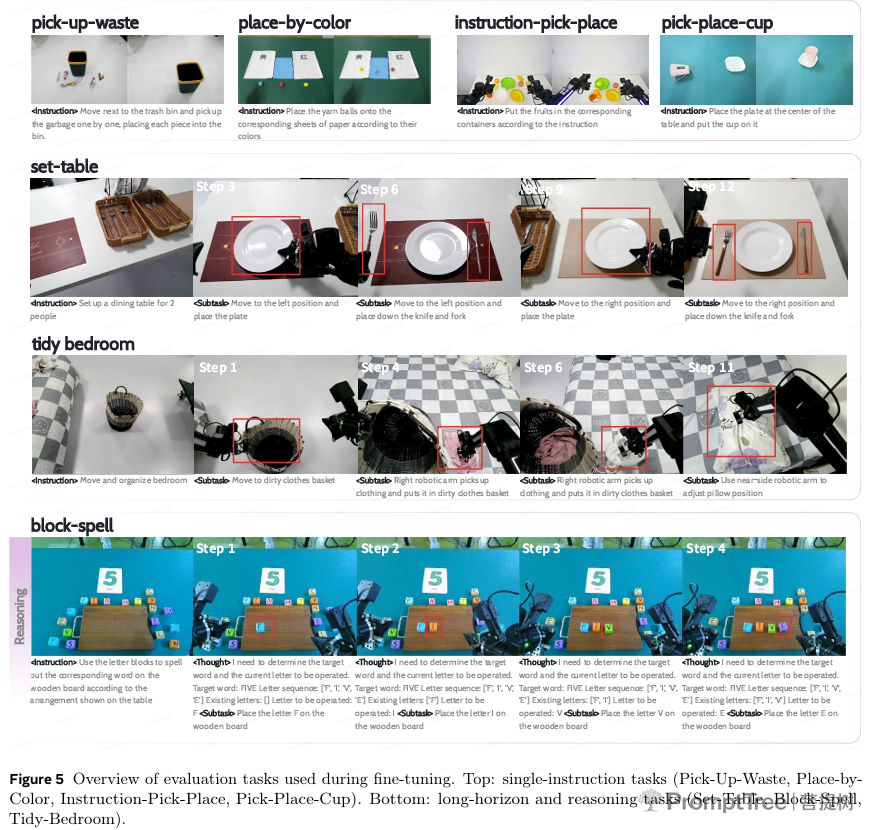
数据覆盖显式指令下的短程精度任务,以及目标明确但流程隐式的长程推理任务。项目采用多模型pipeline进行细粒度步骤标注与人工抽查,按场景/物体/任务/形态分层抽样,对长程任务和稀缺技能实施温度控制重采样与困难样本上采样。
实验结果
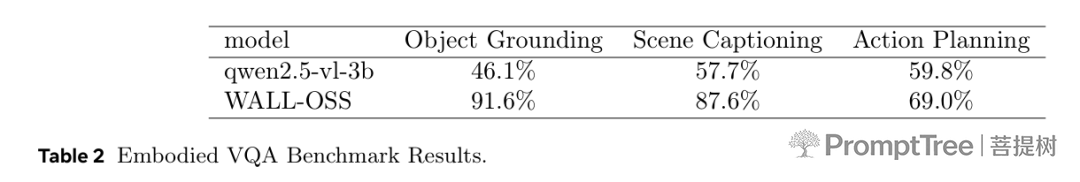
在自建具身视觉问答基准上,WALL-OSS较基础模型Qwen2.5-VL-3B在物体定位、场景描述与行动规划任务中均有提升,证明预训练策略成功注入了机器人为中心的场景知识。
零样本泛化测试中,模型在已知物体指令上达85%平均任务进度,新物体指令保持61%。失败多源于陌生物体的姿态偏差,而非语义误解。
动作精度对比显示:1000条演示的垃圾收集任务中,WALL-OSS与π0均达100%成功率,未预训练DP模型仅80%;500条演示的杯子抓取放置任务中,预训练模型保持90%以上,DP降至20%以下。分布外泛化测试中,DP模型成功率从80%骤降至0%,WALL-OSS与π0均保持80%以上。
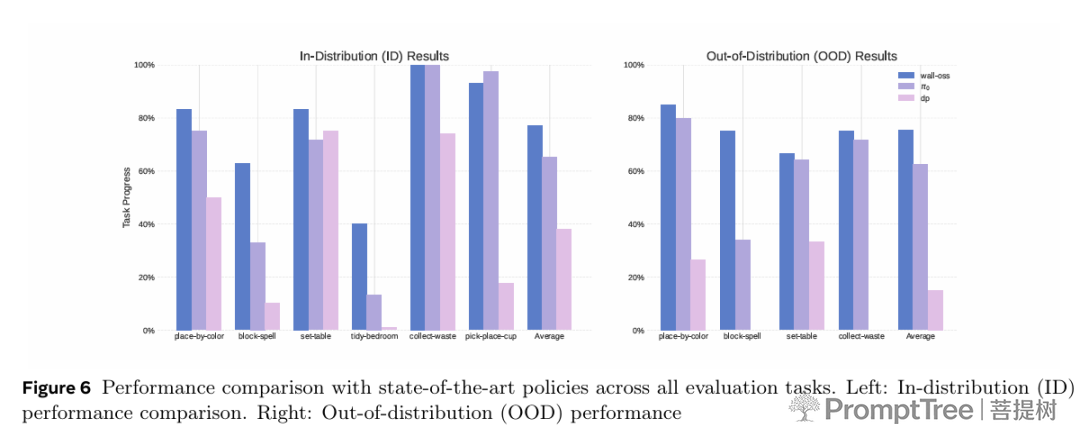
长程任务中,WALL-OSS通过动态语言模型生成子任务实现目标分解。在需文本推理的"按颜色放置"任务中,其完成率显著超越所有基线;积木拼写任务中,扁平化基线进度接近零,WALL-OSS在分布内外均优于GPT生成子任务的基线。GPT-4虽能推断正确子指令,但缺乏时效性与上下文适应性,且高层策略与底层执行存在脱节。
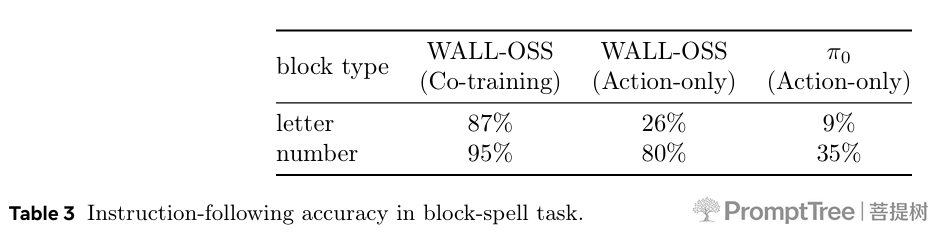
细粒度指令执行方面,WALL-OSS在积木拼写任务中准确率显著高于π0,尤其在识别和放置正确字母积木序列方面。
开源链接
- Hugging Face:https://huggingface.co/x-square-robot
- GitHub:https://github.com/X-Square-Robot/wall-x
- 项目主页:https://x2robot.com/en/research/68bc2cde8497d7f238dde690
自变量机器人成立于2023年12月,聚焦自研通用具身智能大模型,2025年已完成近10亿元A+轮融资,资金主要投入全自研基础模型的持续训练。