自变量机器人、π相继开源,机器人迎来「新基建」!
声明:文档由AI根据原文生成。
自变量机器人开源WALL-OSS,具身智能进入"可复现"阶段
9月8日,自变量机器人正式发布通用基础具身模型WALL-OSS,同步开放预训练权重、训练代码、数据集接口及部署文档,支持开发者在实际机器人系统中快速完成闭环验证。一天后,Physical Intelligence的π0.5也宣布开源。两家顶级模型的接连开源,让端到端的统一VLA(视觉-语言-动作)路线进一步成为行业默认选项。
与以往"有限开放"的做法不同,WALL-OSS将输入输出扩展至语言、视频、动作等多模态数据,并具备因果推理、空间感知与反思优化能力。开发者无需再从"看Demo"起步,可直接在自有硬件上跑通全流程。
模型架构:MoE架构解决跨模态融合难题
WALL-OSS基于Transformer构建,核心设计以"强化跨模态关联"与"保障开源复用性"为双主线。模型引入混合专家(MoE)架构,为不同训练任务分配专属前馈神经网络,使视觉、语言、动作三类信息深度交互。
针对传统具身模型(如RT-2、OpenVLA)易出现的权重分布紊乱问题,WALL-OSS通过任务-专家的精准匹配规避性能波动,同时可快速适配桌面臂、移动机器人等不同硬件平台。
统一跨层级思维链:从语义到动作端到端
WALL-OSS的另一项创新是统一跨层级思维链(Uni-CoT)机制。该机制将传统思维链的推理能力拓展至"语义理解-子任务规划-动作生成"全流程,覆盖从高层语义到传感器-运动的完整链路,且全程在单一可微框架内完成,避免了传统多模块方案的非可微接口与误差累积。
具体而言,高层次语义推理依托具身视觉问答(VQA)数据与多场景指令数据训练;子任务规划将复杂任务拆解为可执行步骤;细粒度动作生成则输出标准化连续动作轨迹,通过统一硬件形态规范适配常见机器人平台。
两阶段训练:从离散动作到连续建模
训练分为启发阶段与集成阶段。启发阶段结合具身VQA任务,通过掩码语言建模、图像/视频-文本对比学习等目标建立VL先验知识,并引入FAST标记化方法将文本与离散动作标记对齐。集成阶段则通过流匹配方法转向连续动作建模:先冻结VLM、仅训练动作部分的flow head,再解冻VLM联合优化,视觉、语言和动作特征通过注意力机制交互整合。
多源数据构建:覆盖自收集与开源数据
为解决数据稀缺痛点,WALL-OSS提供了多源融合数据集构建方案。自收集的机器人动作数据涵盖桌面臂、移动支架、双臂系统等平台,涉及厨房清洁、装配、取放物品等任务;开源动作数据整合了DROID、BC-Z、BRIDGE等数据集;多模态VQA数据则通过自收集轨迹生成,增强空间-时间和任务推理能力。
实验结果:Zero-shot泛化与长时间任务优势
评估套件包含具身VQA基准与六个机器人操作任务,从语言指令理解、长时间任务规划、动作准确性三个维度考察模型表现。
在具身VQA的物体定位、场景描述、动作规划三项任务中,WALL-OSS均展现优势。Pick-Place任务的Zero-shot测试显示,模型在已见物体指令上任务进度达85%,未见新物体上保持61%,失败多源于抓取姿态微调而非语义误解。
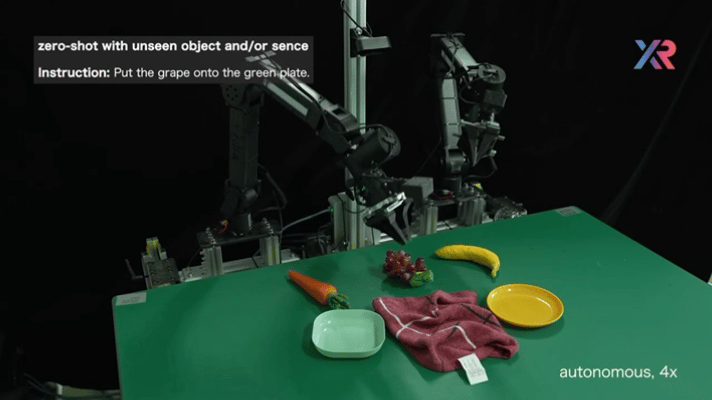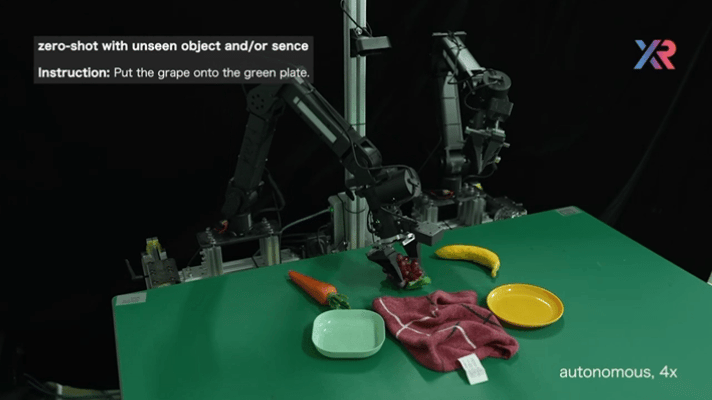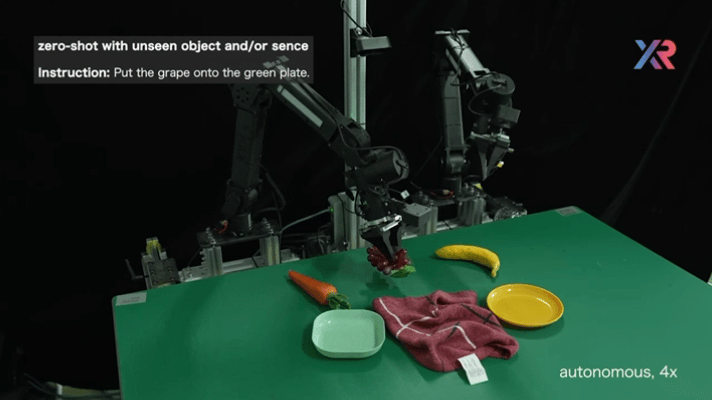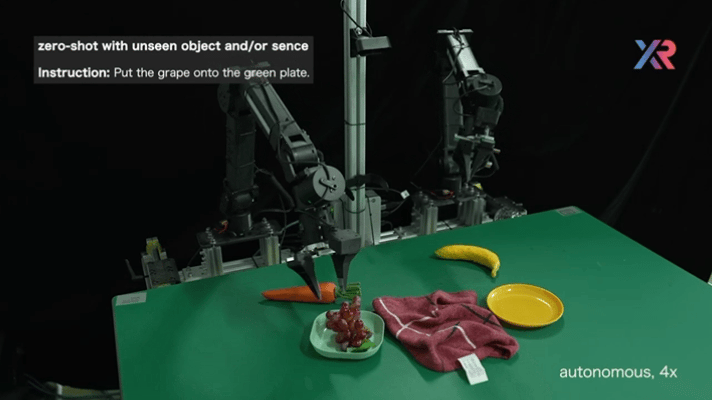
动作准确性方面,Collect-Waste任务中WALL-OSS与π0的入库成功率均达100%,未预训练的Diffusion-Policy为80%。随着任务复杂度增加,预训练模型优势更明显:Pick-Place-Cup任务(500个演示样本)中WALL-OSS与π0成功率超90%,Diffusion-Policy低于20%。OOD环境下,Diffusion-Policy成功率从80%降至0%,WALL-OSS与π0仍维持80%以上。
长时间任务中,WALL-OSS通过动态分解高层目标为中间子任务,在Set-Table和Tidy-Bedroom任务中表现远超基准模型。尽管仅1%训练数据标注子任务,模型仍能高效生成高质量子任务指令。
引入思维链后,WALL-OSS在Place-by-Color等需文本推理的任务中超过所有基准模型。多模态联合训练也使模型在Block-Spell等细粒度指令跟随任务中精度优于π0。
开源意义:降低门槛,推动集体迭代
WALL-OSS将预训练权重、训练代码、数据集接口和部署文档打包开放,解决了开发者"缺零件"的痛点。在端到端VLA已成主流的当下,模型效果与应用效率成为拉开差距的关键。这份开源方案使不同资源背景的团队都能在自有机器人上快速验证和迭代,推动具身智能从"单点突破"走向更广泛的集体参与。
论文题目:Igniting VLMs toward the Embodied Space
发文机构:X SQUARE ROBOT TEAM(自变量机器人)
论文地址:https://x2robot.cn-wlcb.ufileos.com/wall_oss.pdf
项目主页:https://x2robot.com/en/research/68bc2cde8497d7f238dde690
代码链接:https://github.com/X-Square-Robot/wall-x
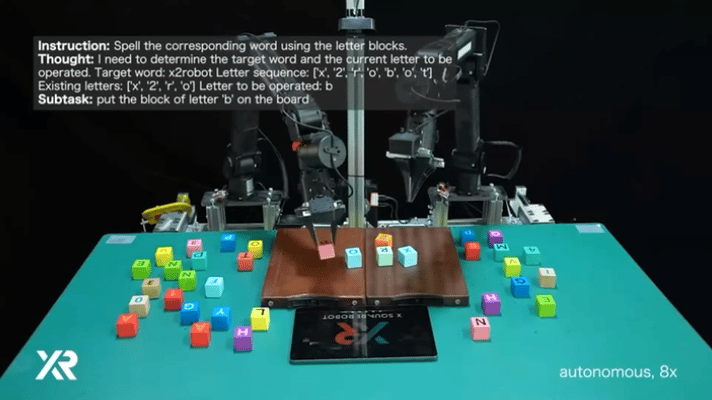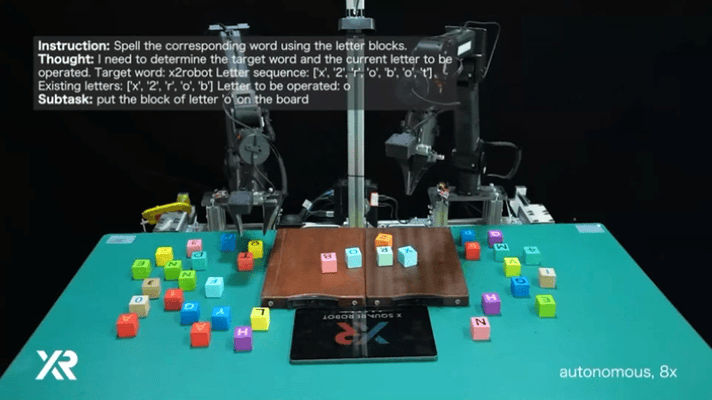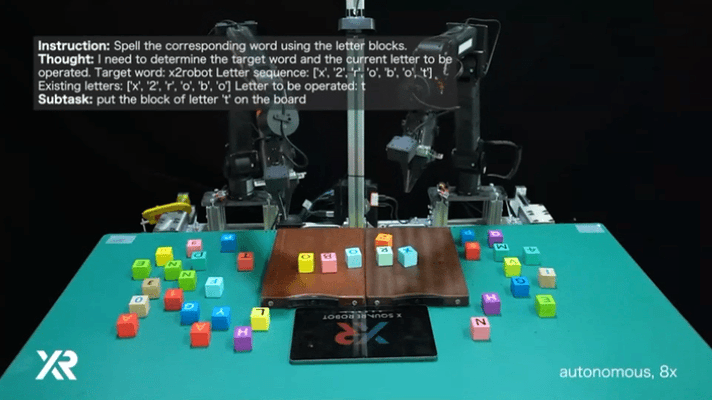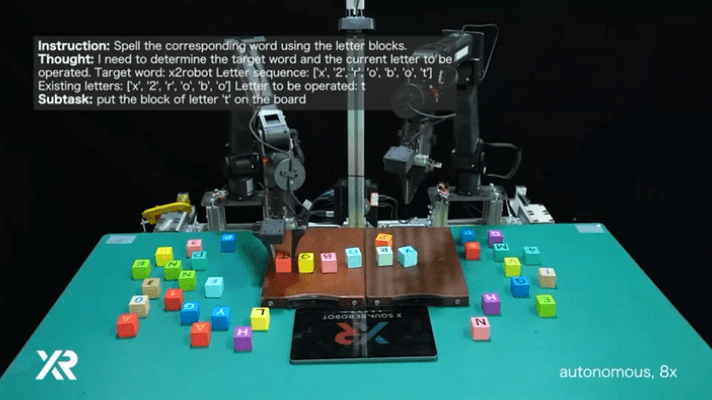
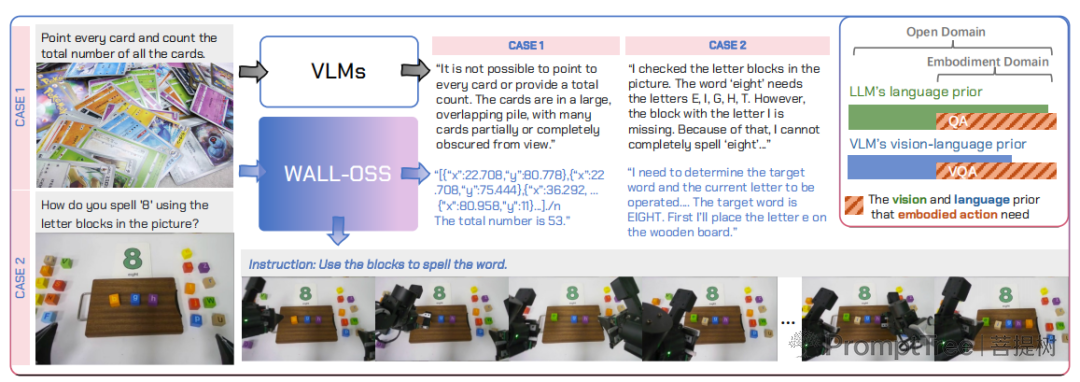
图1|当前的视觉语言模型(VLMs)在具身智能中的空间理解和动作执行能力上存在不足。这一缺陷源于现有预训练的VLMs能力与具身任务所需的特定知识之间的不匹配。WALL-OSS释放了VLMs的具身潜力,从而增强了具身理解能力,并能够生成复杂的动作。
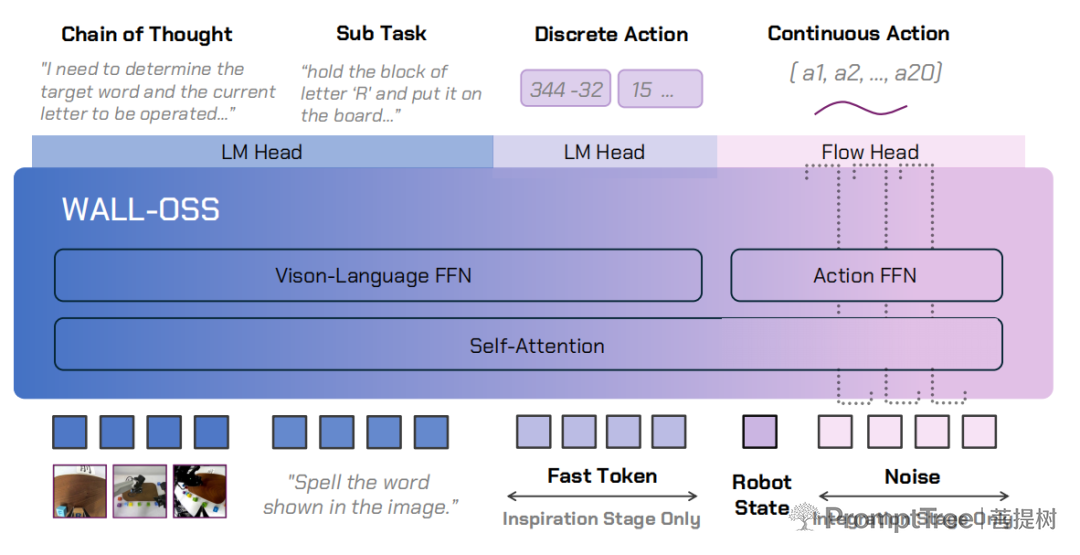
图2|WALL-OSS的架构
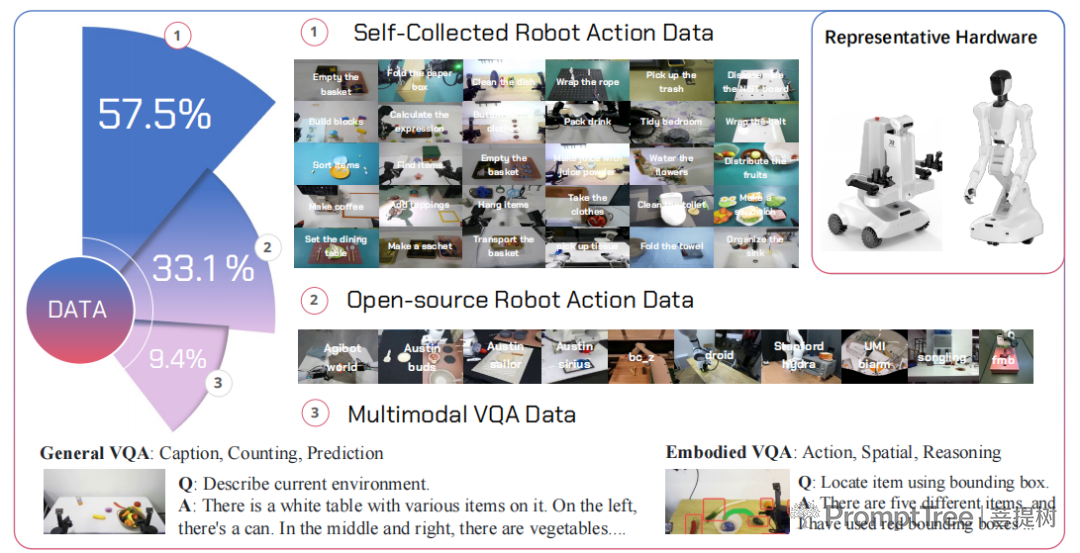
图3|多源数据集概述。左侧:来自三个来源的组成(自收集动作、开源动作和多模态VQA)。中间(从上到下):自收集动作、开源动作和多模态VQA的示例图像。右上角:我们的代表性机器人硬件
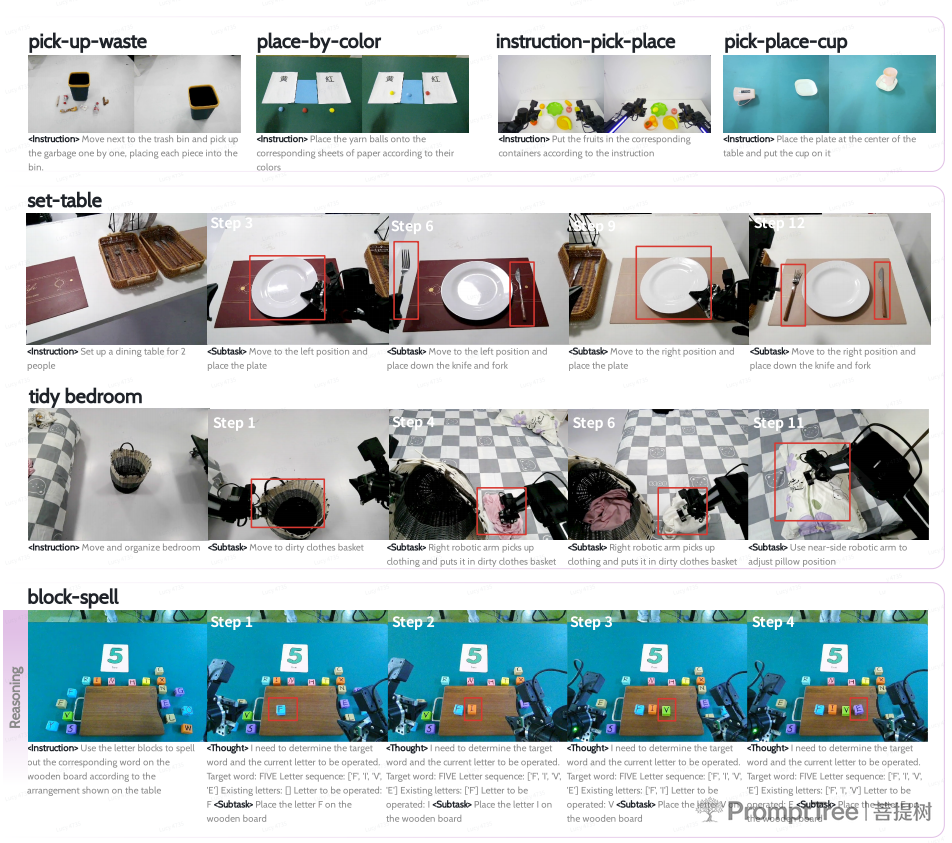
图4|微调过程中使用的评估任务概述。顶部:单一指令任务(拾起垃圾、按颜色放置、指令-拾取-放置、拾取-放置-杯子)。底部:长时间跨度和推理任务(摆放餐具、拼字、整理卧室)
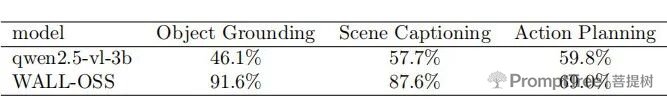
表1|WALL-OSS具身问答任务评估结果
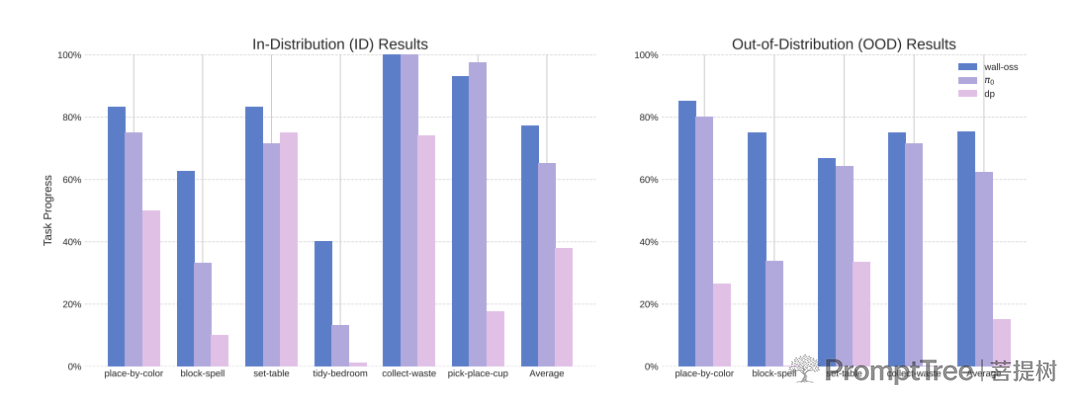
图5|WALL-OSS与最先进策略在所有评估任务中的性能比较。左侧:分布内(ID)性能比较。右侧:分布外(OOD)性能比较
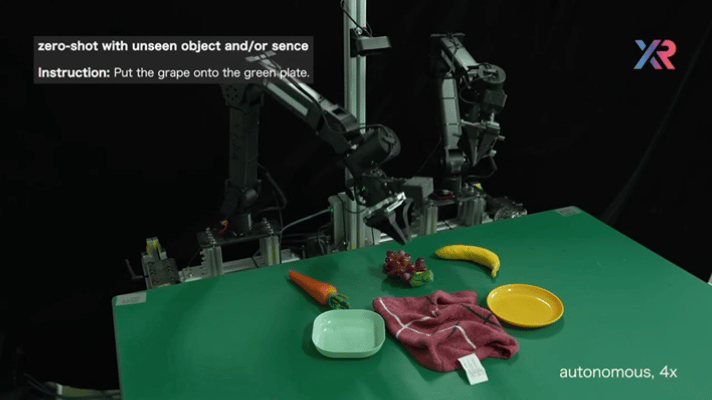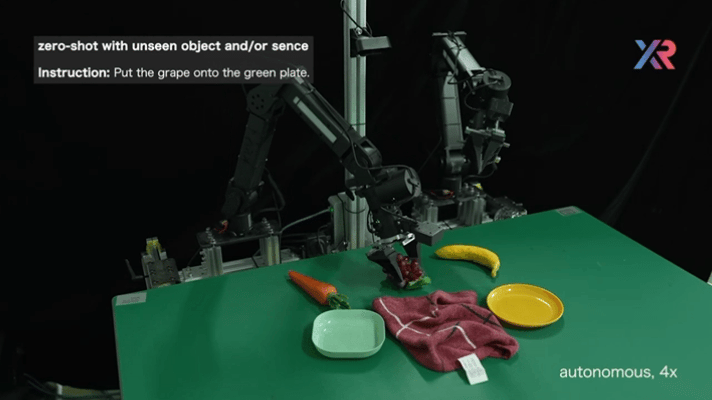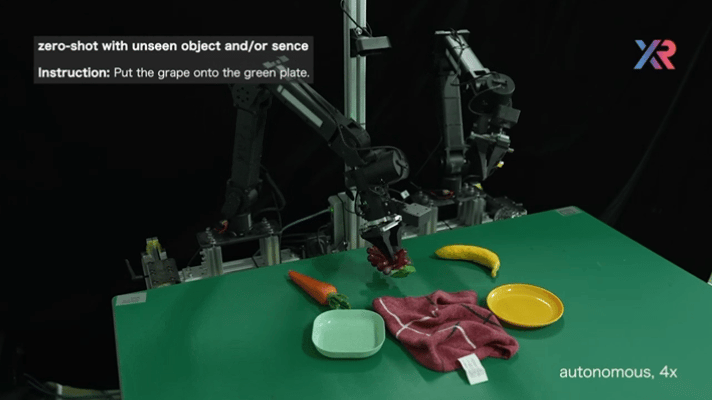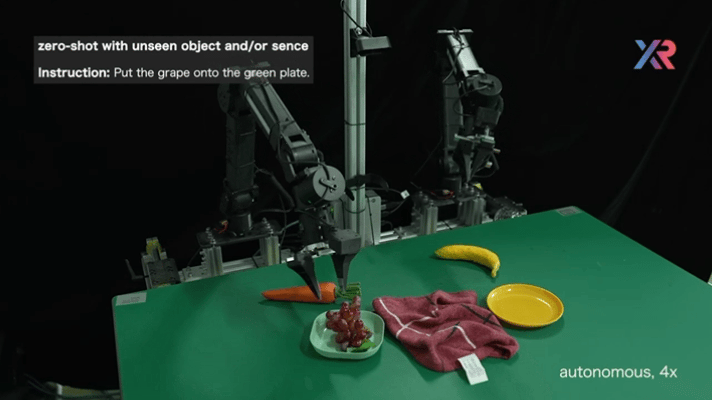
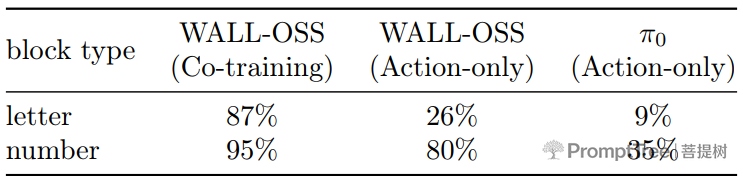
表2|WALL-OSS在Block-Spell任务中的指令遵循准确率