开放全栈!超越π0,具身智能基础大模型迎来真·开源,开发者狂喜
声明:文档由AI根据原文生成。
自变量机器人开源WALL-OSS,同日宣布近10亿元融资
自变量机器人于9月8日正式开源其通用具身智能基座模型WALL-OSS。该模型在4.2B参数规模下融合了超大规模高质量真机数据进行预训练,具备语言、视觉、动作多模态端到端统一输出能力。同日,该公司宣布完成近10亿元A+轮融资,阿里云、国科投资领投。
单卡可训,泛化性能领先同类开源模型
WALL-OSS支持在RTX 4090级别显卡上完成从训练到推理部署的全过程。在严格的ID(分布内)和OOD(分布外)评测中,该模型展现出优于π0等同类开源模型的性能。
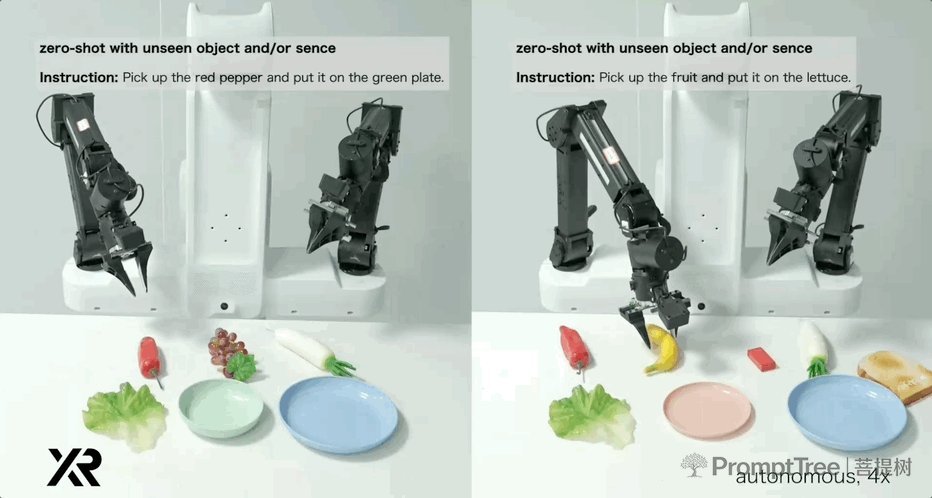
在OOD场景下,即使指令描述、动作动词、物体方位等要素发生变化,WALL-OSS仍保持较高的任务成功率和指令遵循度。在长程任务中,其表现显著优于采用扁平化策略的π0-flat等基线模型;在依赖思维链的推理类任务中,亦优于π0-flat和pi-gpt-prompt。
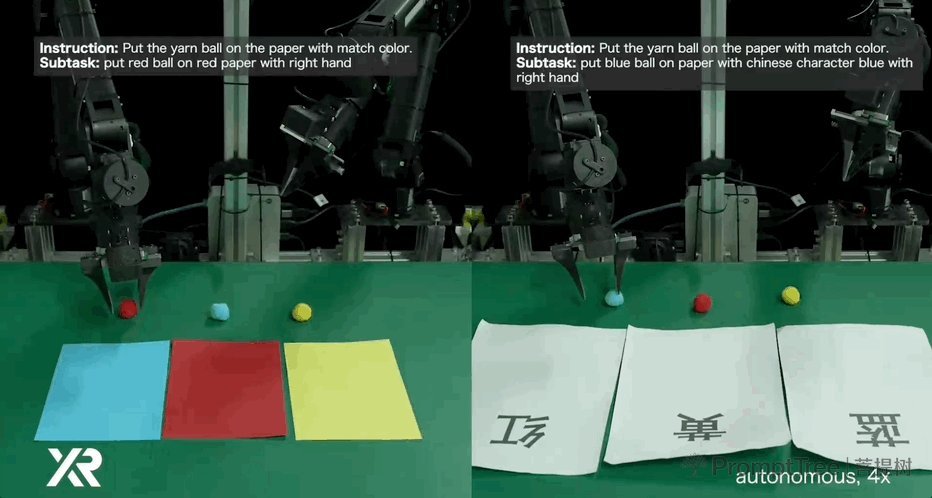
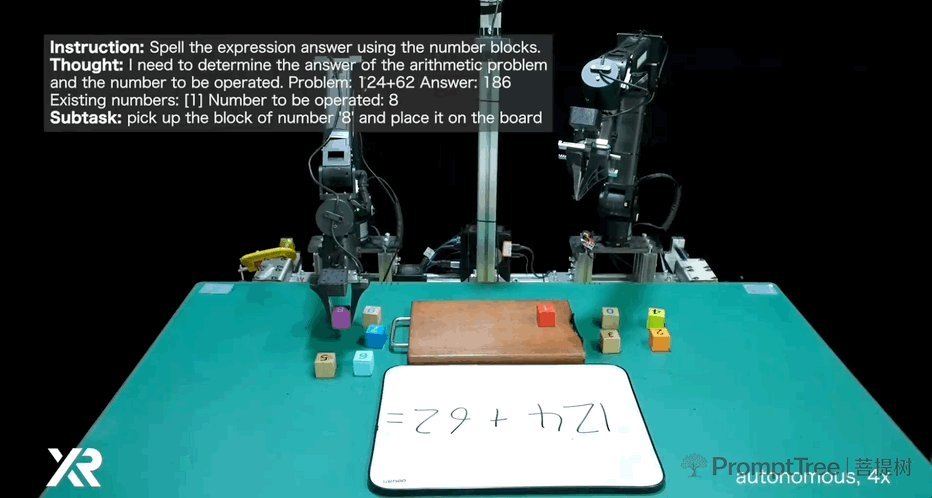
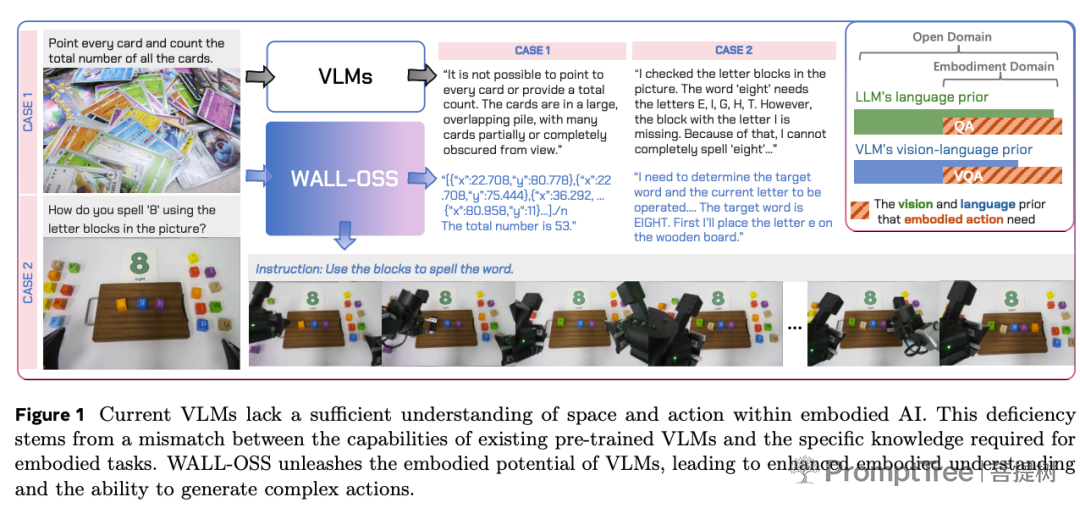
通过空间VQA、视觉定位、场景语言描述等多模态基准测试验证,WALL-OSS完整保留了VLM核心功能并实现了能力强化,可同时兼顾推理规划和动作执行,输出语言和动作双模态。
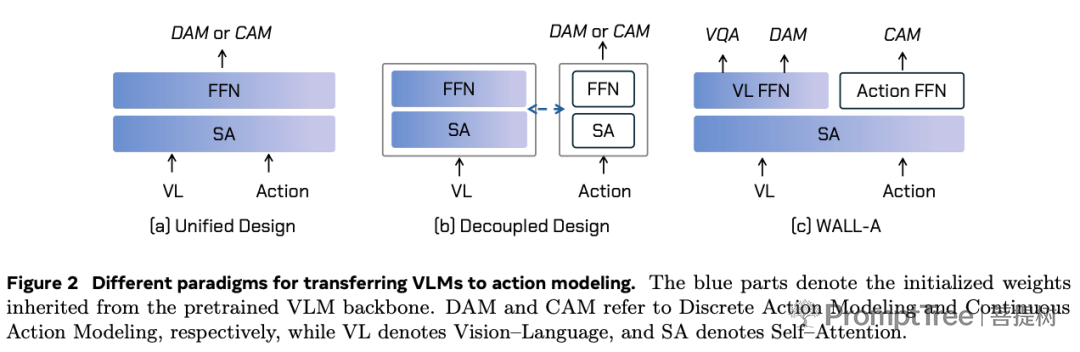
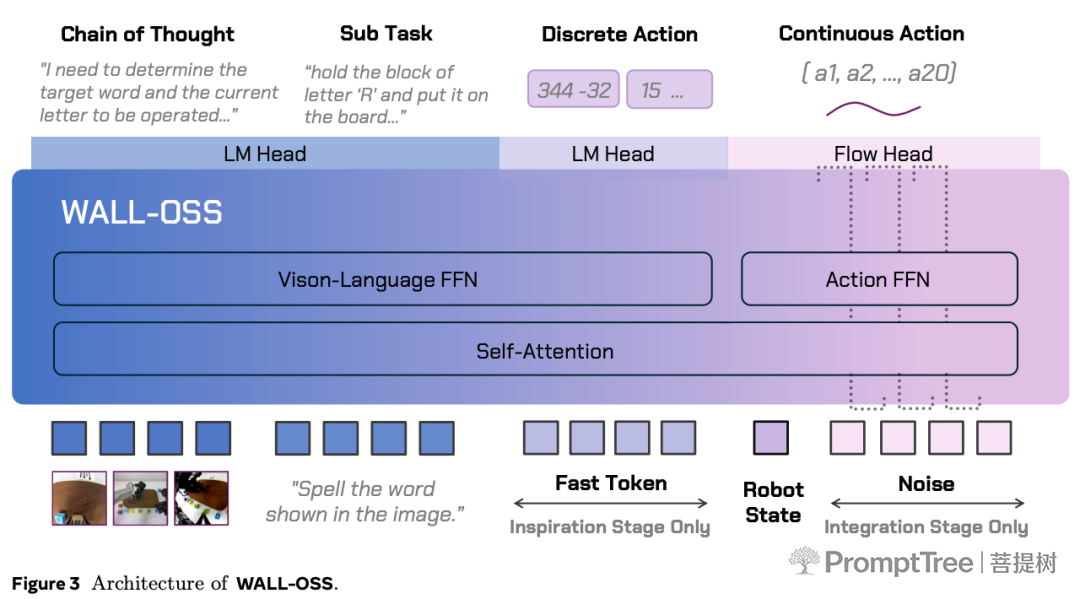
该模型采用统一的Transformer架构,通过专家分流机制实现语言、视觉、动作在统一框架下的生成与协同优化。这种端到端设计避免了多阶段流程的误差累积,提升了长程和"推理+操作"复合任务上的稳定性。
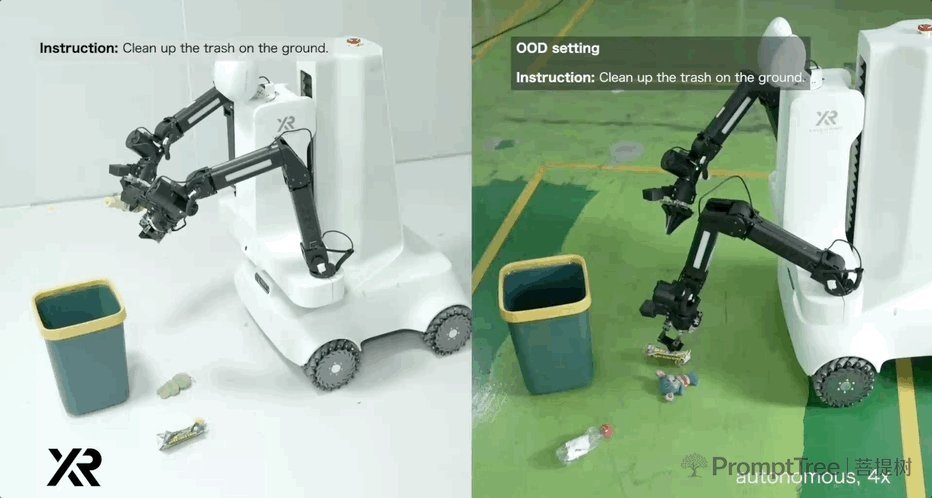
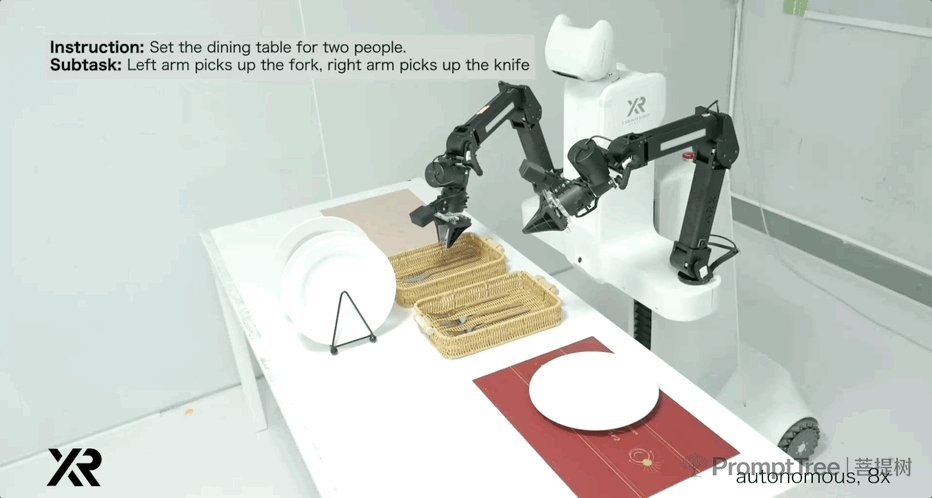
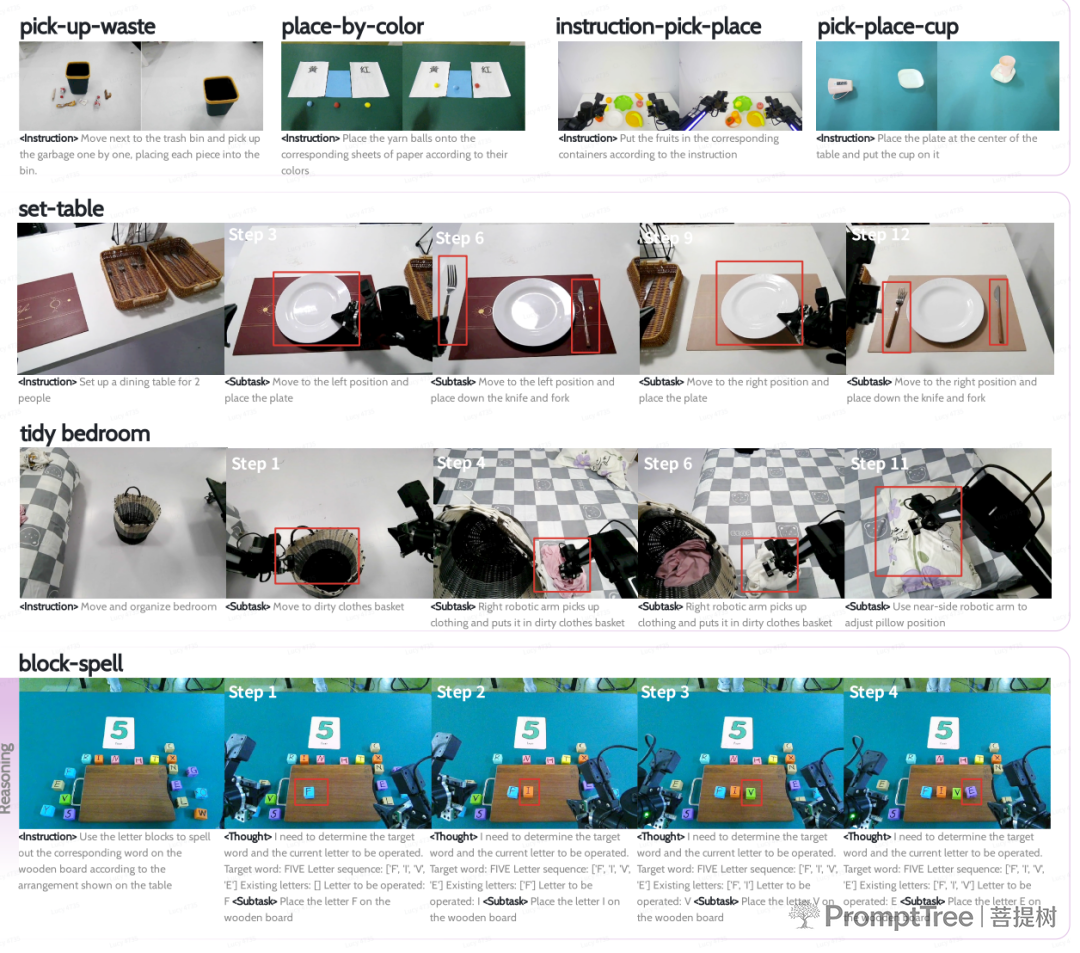
WALL-OSS具备跨场景迁移与执行能力,可应用于养老护理、工业装配、酒店服务、物流分拣等场景。开发者可通过微调将其快速适配到不同本体上。
四项技术创新破解"不可能三角"
具身智能领域长期面临模态统一、动作精度和能力泛化难以兼顾的技术困境。WALL-OSS从架构设计、数据构建、训练策略到推理机制进行了系统性重构。
架构层面,该模型首创"共享注意力+专家分流(FFN)"结构,将语言、视觉、动作信息嵌入同一表示空间处理,通过共享注意力实现模态间信息交叉,以专家FFN处理不同任务,避免了VLM知识迁移中的"灾难性遗忘"和"模态解耦"问题。
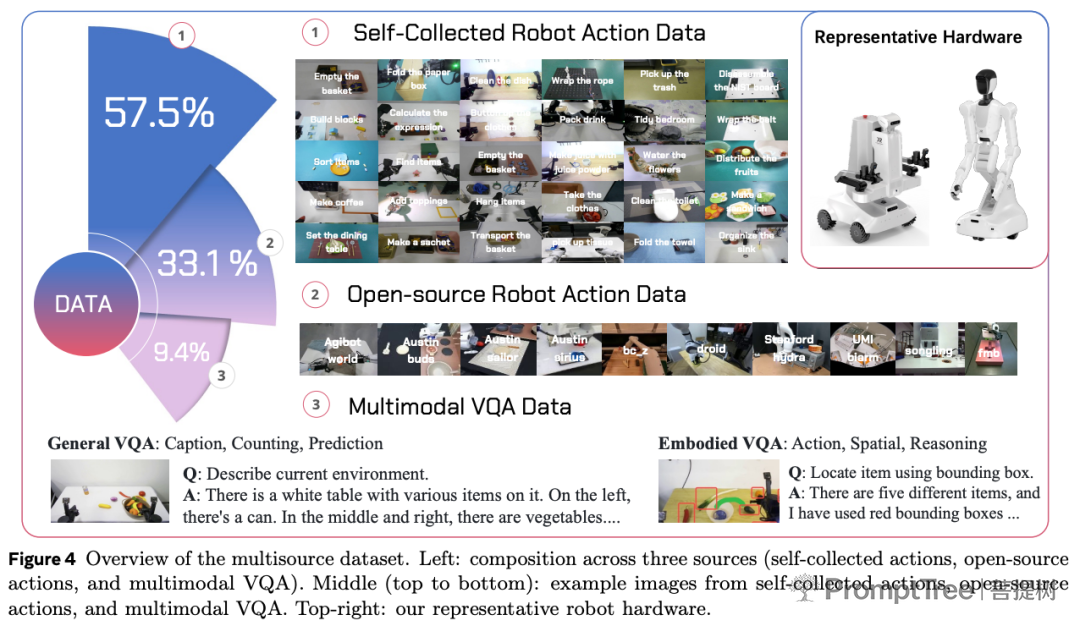
数据与训练策略方面,WALL-OSS依托大规模VLA训练集,以自采高质量真机数据为核心。团队设计了两阶段训练策略:Inspiration Stage(启发阶段)沿用原VLM的FFN结构,加入预训练任务增强空间语义理解,引入具身视觉问答和离散动作学习;Integration Stage(融合阶段)先冻结VLM仅训练动作模块,再解冻联合优化全模型,实现"先离散、后连续、再联合"的范式迁移。
推理机制上,WALL-OSS将思维链推理从传统狭义CoT推广至涵盖语义-感知运动频谱的广义CoT,形成"指令→推理(CoT)→子任务规划→连续动作"的统一跨层级框架,可在单一可微分框架内无缝切换高层决策与底层执行。
自变量机器人CTO王昊表示,这是WALL-OSS能够胜任长程、复杂任务的关键,"在面对未知环境、从未习得的任务时,模型也能自主拆解步骤,逐步思考,寻求解决办法。"
全栈开源降低行业准入门槛
WALL-OSS此次开源涵盖预训练模型权重、训练代码、数据集接口及详细部署文档,提供完整可复现的具身大模型方案。第三方机器人无需门槛即可接入,实测外部团队最快一周内完成适配,通常这一过程需1至2个月。
自变量团队指出,具身智能赛道存在"过拟合演示"现象——Demo效果惊艳,实际应用却大打折扣,根源在于模型基建缺失。由于具身智能"软硬件一体"的特性,基础设施受限导致高投入、高门槛、长周期的适配困境。
"我们想让整个行业以最低的成本,获得最先进、最通用的能力基座。"王昊表示,"因为没有基础模型,具身智能行业根本长不大。"
自变量机器人成立于2023年底,自成立起即押注端到端技术路径。2024年11月,该团队推出WALL-A,宣称当时全球最大规模的端到端统一具身大模型。此次A+轮融资股东包括国开金融、红杉、渶策、美团、联想之星、君联资本等,资金将主要用于全自研通用具身智能基础模型的持续训练。
项目地址:
GitHub:https://github.com/X-Square-Robot/wall-x
项目主页:https://x2robot.com/en/research/68bc2cde8497d7f238dde690