继宇树后,唯一获得三家大厂押注的自变量:具身模型不是把DeepSeek塞进机器人
声明:文档由AI根据原文生成。
自变量机器人获10亿元融资,字节、红杉入局
2026年初,自变量机器人传出融资消息,字节跳动、红杉中国等参与,融资额达10亿元。这家软硬一体的具身智能公司,其说服投资人的核心在于对机器人"大脑"的体系化思考。
与此前locomotion(移动)、navigation(导航)的赛道不同,"大脑"主导的manipulation(操作)涉及频繁的物理世界交互,随机性与不确定性贯穿每个看似简单的任务。多年机器人跳舞、跑酷之后,自主操作仍未出现突破性demo,而这恰是决定机器人能否大规模进入人类世界的关键。
自变量认为,"操作"任务的复杂性决定了机器人必须由"物理世界基础模型"支撑"大脑"。这一"大脑"并非"把DeepSeek塞进宇树"的简单嫁接,不是AI模型的"应用层",而是独立、平行于语言大模型、多模态模型等虚拟世界模型的新范式。
具身智能≠AI模型下游应用
近年机器人"大脑"的进化主要依赖语言模型与多模态模型,不少人据此将具身智能视为AI模型的应用方向。自变量CEO王潜多次公开强调,这一定位存在偏差。
以两个矿泉水瓶为例:一个瓶盖拧紧,一个未完全拧紧。仅靠视觉观察,二者图像差异极小;但拿起、翻转或倾倒后,结果截然不同——一个漏水,一个不漏。
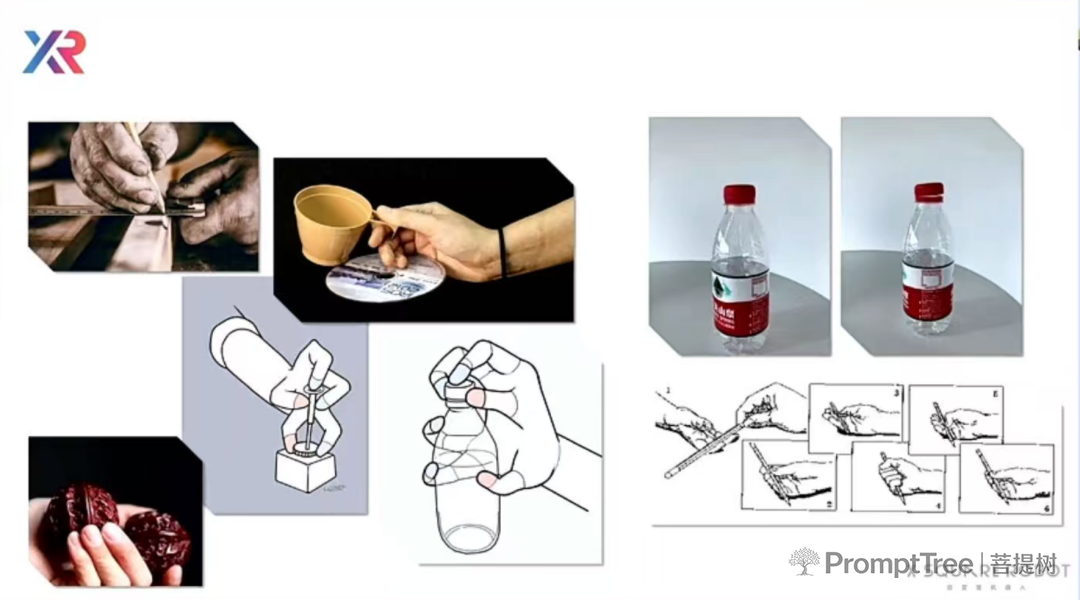
物理世界的关键信息常藏于"看不出来但会影响行为"的细节中,只有在真实交互时才会暴露,静态观察难以判断。更棘手的是,这类信息往往延迟反馈:拧瓶盖动作本身无可见变化,真正的差异要在后续步骤中显现。模型必须将一连串感知、动作和结果在时间上串联理解,而非仅处理单帧画面。
许多真实任务还要求机器人在行动前推演未来:倒水前判断瓶子是否漏水,整理桌前决定先后顺序。这类判断是对"接下来会发生什么"的内部演算,而非对当前状态的直接反应。单纯依赖静态信息训练的语言模型或多模态模型,难以应对连续变化、随机扰动和部分不可观测的现实环境。
自变量判断,这并非给现有模型打补丁所能解决,而是指向更底层的结论:需要一种"生于物理世界、用于物理世界"的基础模型,与语言模型、多模态模型平行存在,而非作为其下游应用。自变量的目标正是打造这一基础模型。
端到端架构与通才模型
自变量认为,构建物理世界基础模型有两点至关重要。
统一架构。 真正的物理智能需要整体性、具身的理解,而非模块化知识拼接。人类使用锤子时,注意力在木头、钉子和目标上,锤子作为工具在认知中"隐退";而现有机器人每次使用工具都需重新经历完整流程:识别、理解用途、规划、执行。自变量指出,这种分层架构导致模块间"看不见"彼此真正关心的信息,每跨一次模块,细节、关联和物理直觉便被削掉一层。
这解释了自变量从成立第一天便坚定"端到端"路线的选择:信息必须在统一空间流动,系统才能发现不同事物间的深层关联。早期这一选择饱受质疑,如今Google Robotics、Physical Intelligence等头部团队也已走上同一条路。
模型通用性。 只有足够通用,才能学到物理世界的共性结构。语言模型的经验表明,将翻译、问答、写作、推理等任务纳入同一模型,反而能让其学到更底层的逻辑和常识。物理世界同理——当模型同时学习足够多、足够杂的任务,会被迫发现背后的物理规律、物体属性、因果关系,掌握共性后学新任务所需数据量骤降,甚至出现"涌现"。
语言模型的成功还有一个关键:预测下一个词这一损失函数,将海量文本中的结构、逻辑、常识压缩进模型。机器人面临更复杂的局面,损失函数应预测什么?
自变量认为不能停留在"预测动作",否则模型沦为"模仿者",只学会手势形状而不懂背后原因。突破口在于将损失函数从"动作预测"升级为"多模态状态的预测"——当模型试图预测"推倒杯子后下一秒视觉画面如何变化、指尖触感如何消失"时,它被迫理解因果律,将物理世界的复杂性压缩进模型。
自变量的WALL-A模型不只输出动作,还能用语言对话、根据图片重建三维环境、像世界模型一样预测未来。这些能力背后逻辑一致:真正理解物理世界的模型,应能用各种方式表达这种理解,无论是控制机械臂、描述行为,还是预测物体滚动。
以外卖即时配送为例,自变量机器人在完全开放的室外及室内环境中执行移动操作任务,应对人流变化、突发干扰等不确定因素,完成从外卖柜取箱、拆箱、回收、室内导航、电梯交互到最终交付的超长序列操作。该场景首次让VLA模型在高频、强约束、强时效的真实环境中长期运行,完成从实验室验证到商业级部署的关键跨越。
坚持自研与开源并行
除对"机器人大脑"的独特思考,自变量在业内还有一个罕见特质:坚持基础模型自研。
Physical Intelligence开源的Pi0和Pi0.5、英伟达开源的GR00T等已是业内主流选择,但自变量判断,具身智能下一阶段竞争的本质是数据闭环构建的基础模型与模型进化能力的竞争,模型不掌握在自己手里,竞争无从谈起。
语言模型领域的从业者对此应有深刻感受——行业最大变量往往藏在基础模型内核。过去两年Cursor等应用层产品风头强劲,但其"智能"几乎完全依赖Claude或GPT的能力边界;上游模型一次升级,下游应用被动重构;API定价调整,成本结构随之改变。
机器人领域这一问题更深一层:真实物理世界的重量、阻力、空间关系无法从互联网文本习得,必须从数据采集到模型架构建立完整自研体系。基础层投入看似更慢,但历史反复证明:原始创新者定义规则,跟随者只能适应规则。
目前自变量有两款核心模型:主模型WALL-A和轻量化模型WALL-OSS,均为自研。该系列首创VLA与世界模型深度融合的系统范式,率先实现具身多模态思维链。
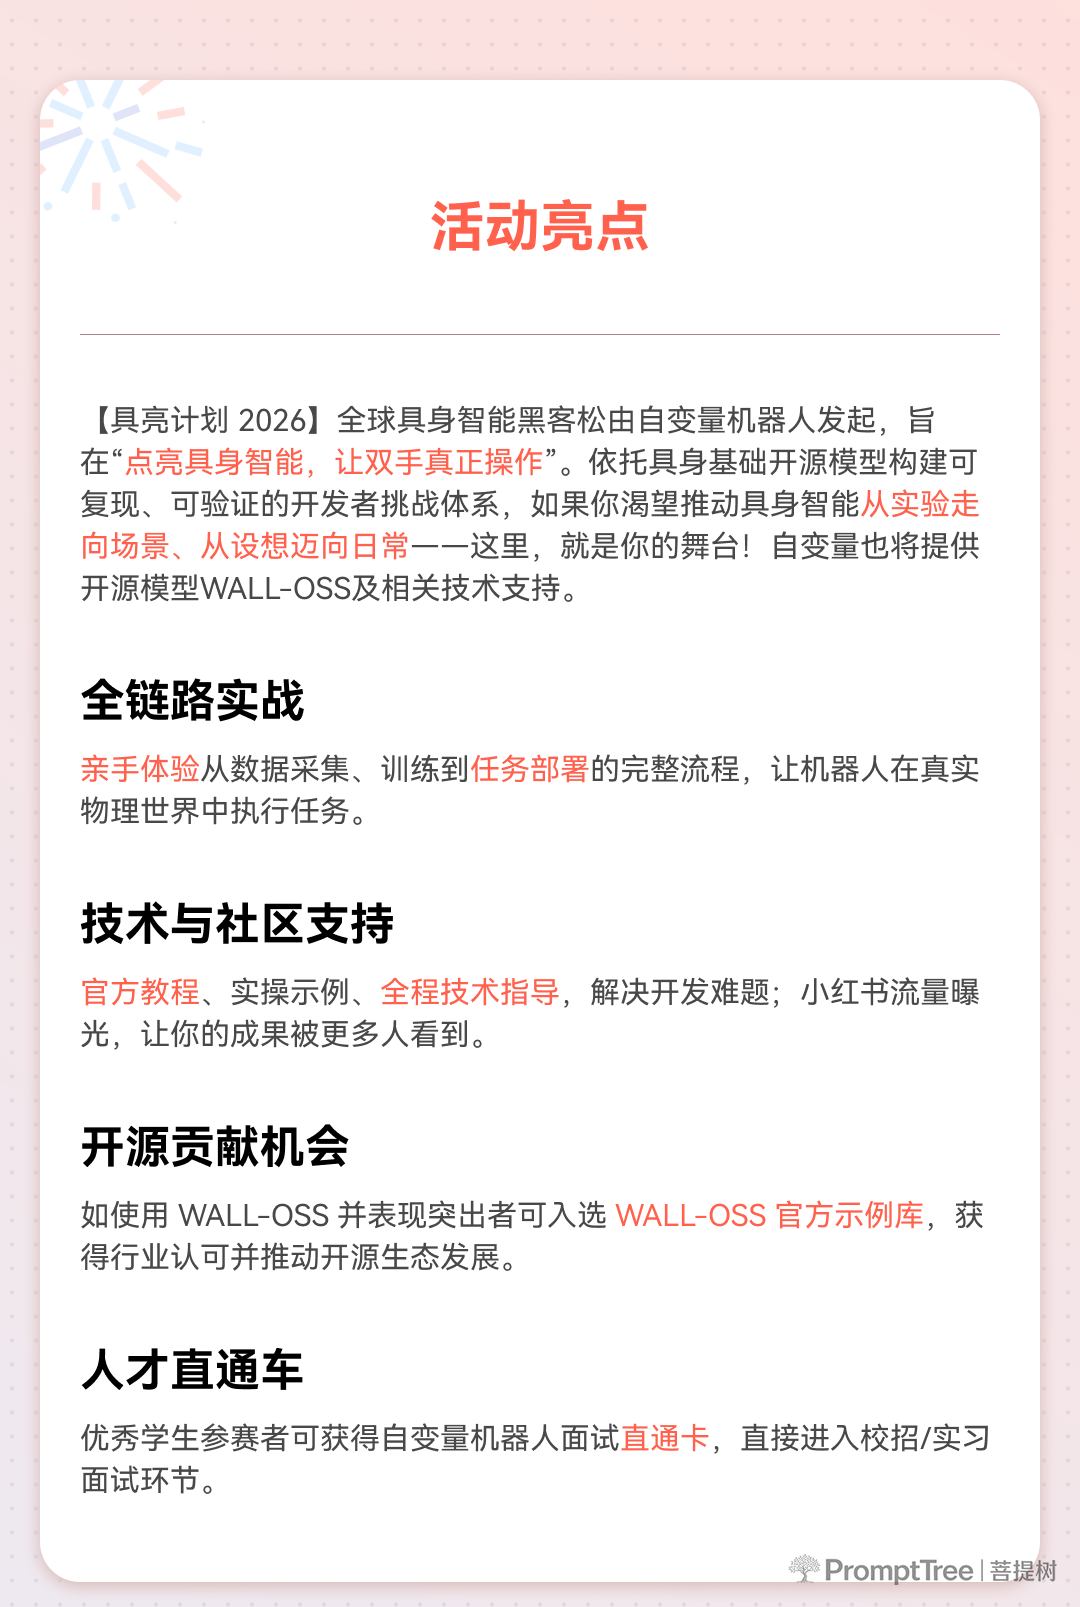
WALL-OSS已开源,自变量还围绕该模型等全球具身开源项目组织"具亮计划"黑客松,鼓励开发者利用具身基础开源模型,从数据采集、策略训练到真机部署跑通完整链路,让机器人在真实场景里动手完成任务。在国内,这种尝试被认为有益——语言模型发展离不开开源文化,具身智能领域也需要自己的DeepSeek。
重走婴儿的路
看到语言模型的蓬勃发展,不少人追问:机器人为何迟迟等不来涌现时刻?
一个可能的答案是:语言本身是高度压缩的符号系统,人类已用数千年将世界复杂性"预处理"成文字,模型只需学会这套编码规则。但物理世界没有这样的捷径——重力、摩擦、碰撞、形变从未被显式写下,它们散落在每次交互的细节里。
物理世界基础模型的构建,某种程度上是在重走人类婴儿的路。它要学的是那些人类"做得出但说不清"的东西,这可能才是智能更本源的形态。