↑
刚刚,国产预训练具身大模型开源了,让后训练不再是必选项!
自变量机器人科技开源国产预训练具身大模型,验证预训练模型可直接投入使用,无需依赖后训练即可实现多场景任务执行,为具身智能领域提供新路径。
声明:文档由AI根据原文生成。
国产预训练具身大模型开源,验证"即训即用"可行性
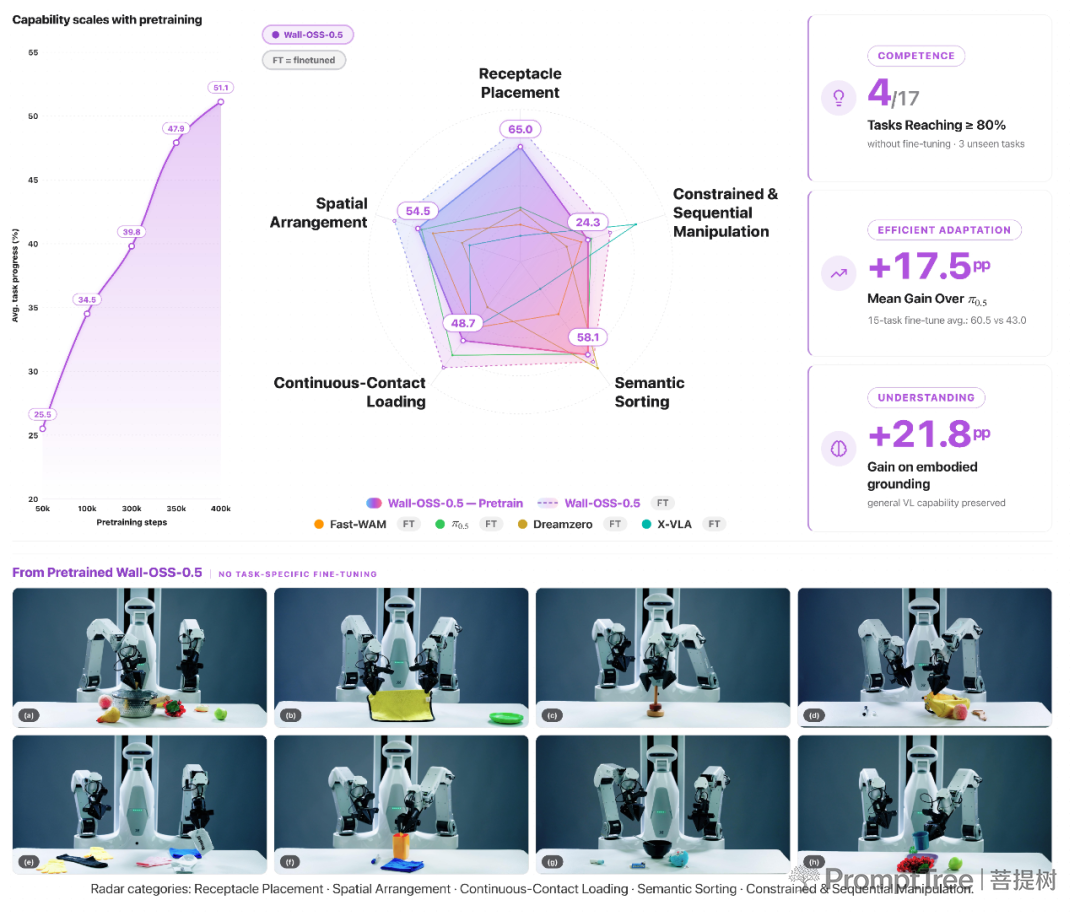
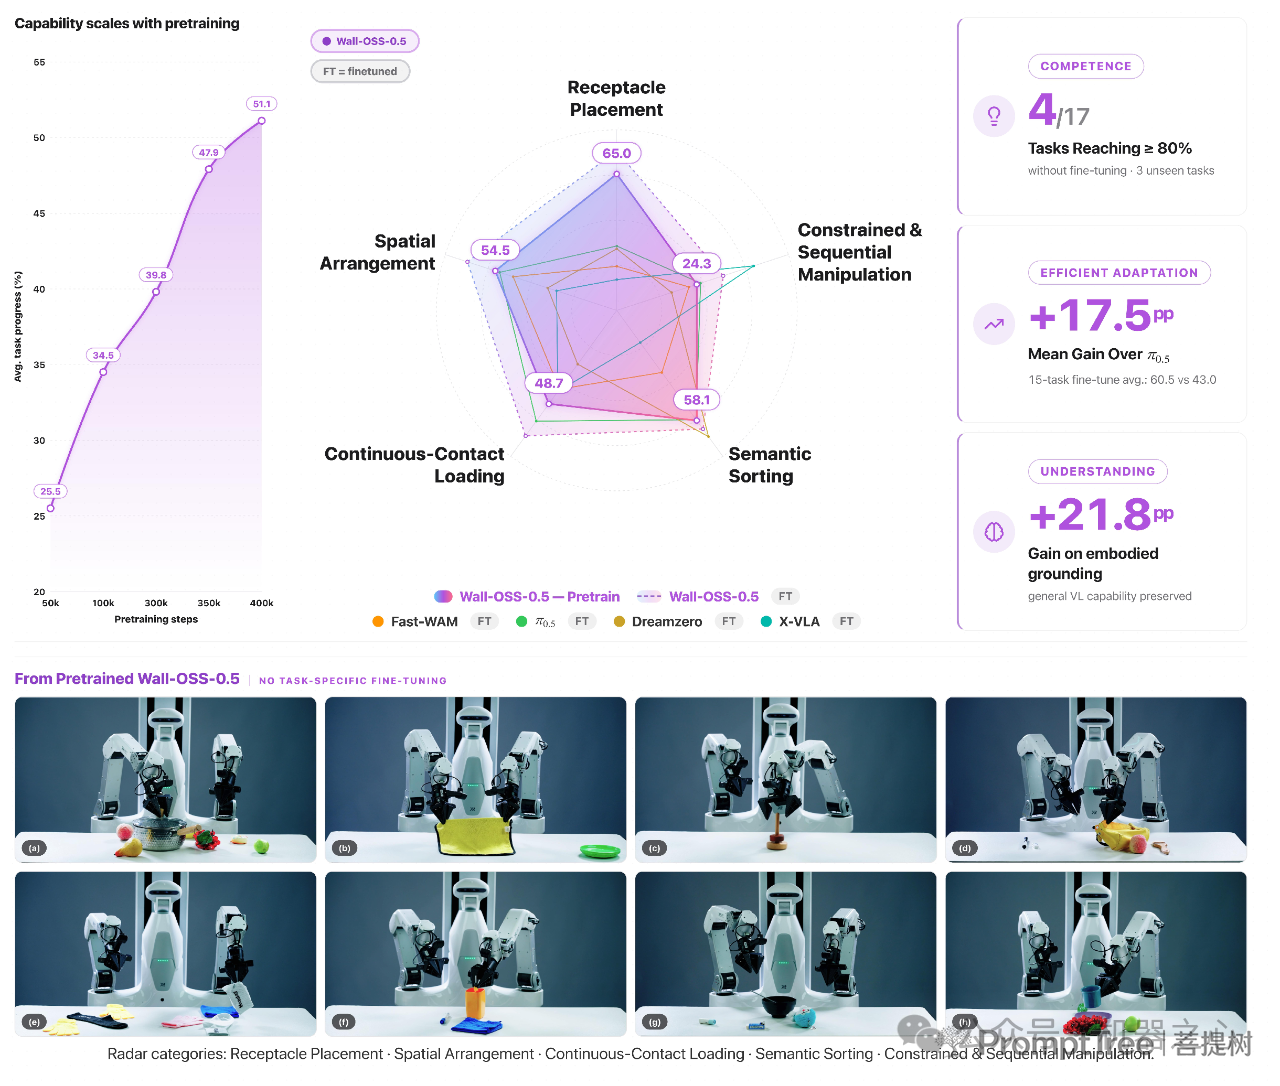
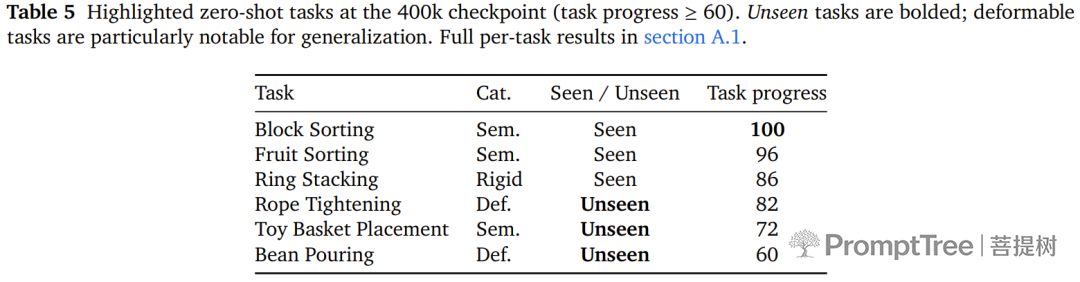
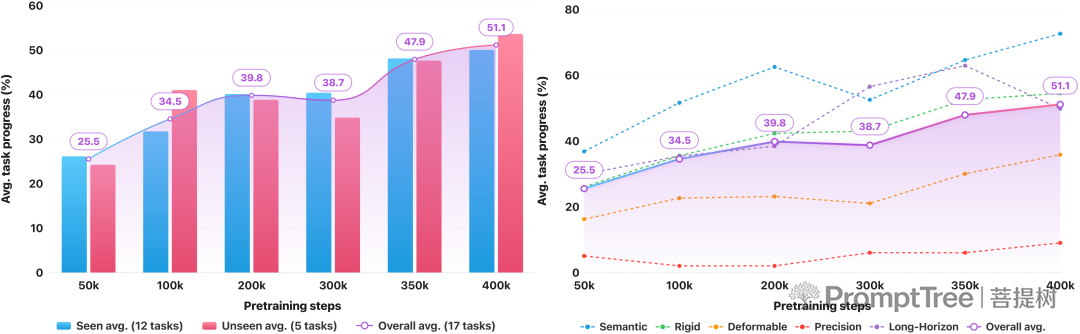
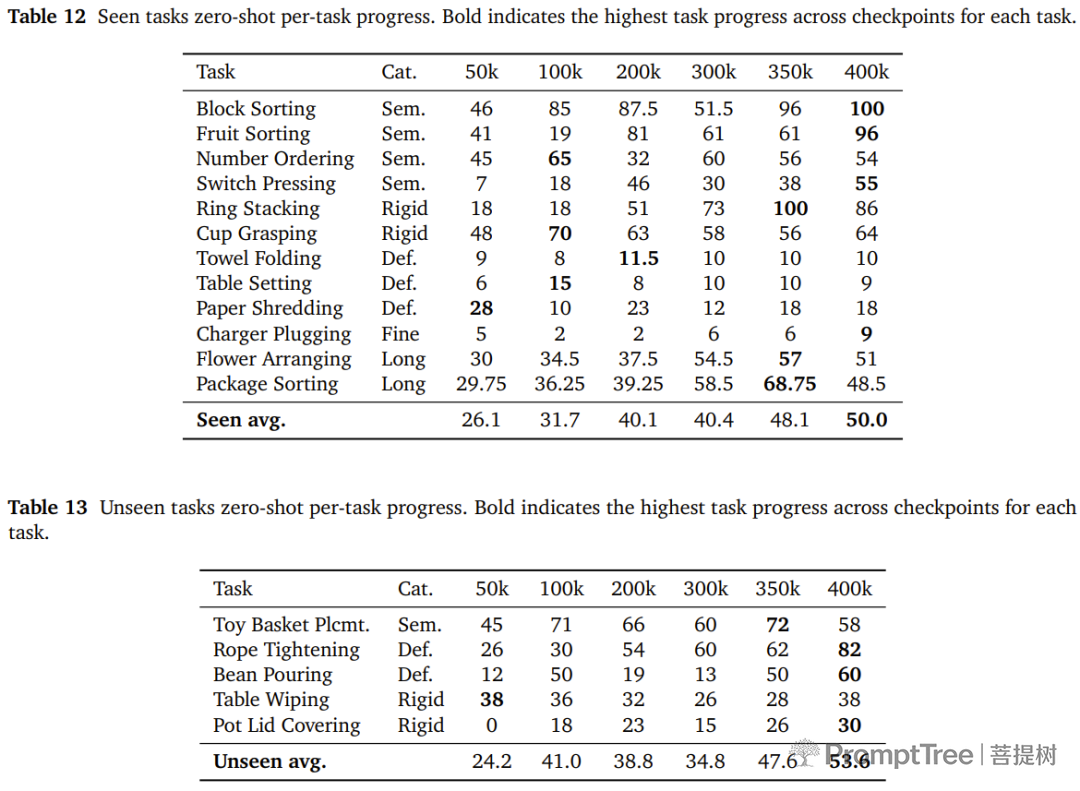
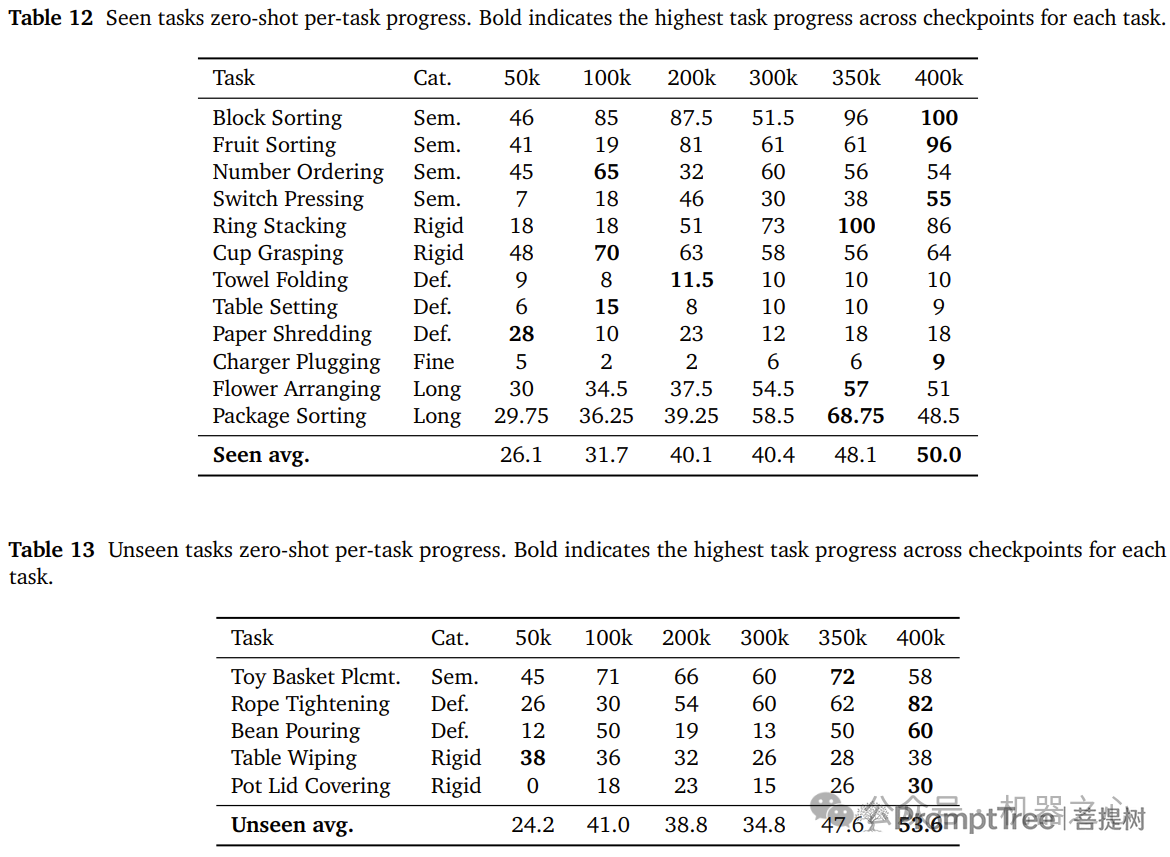
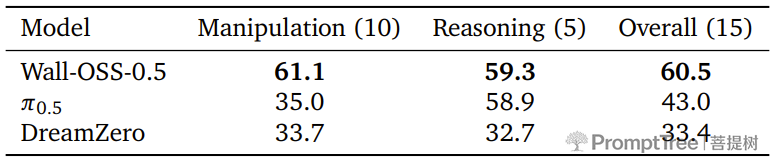
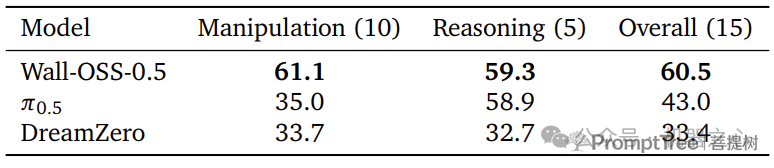
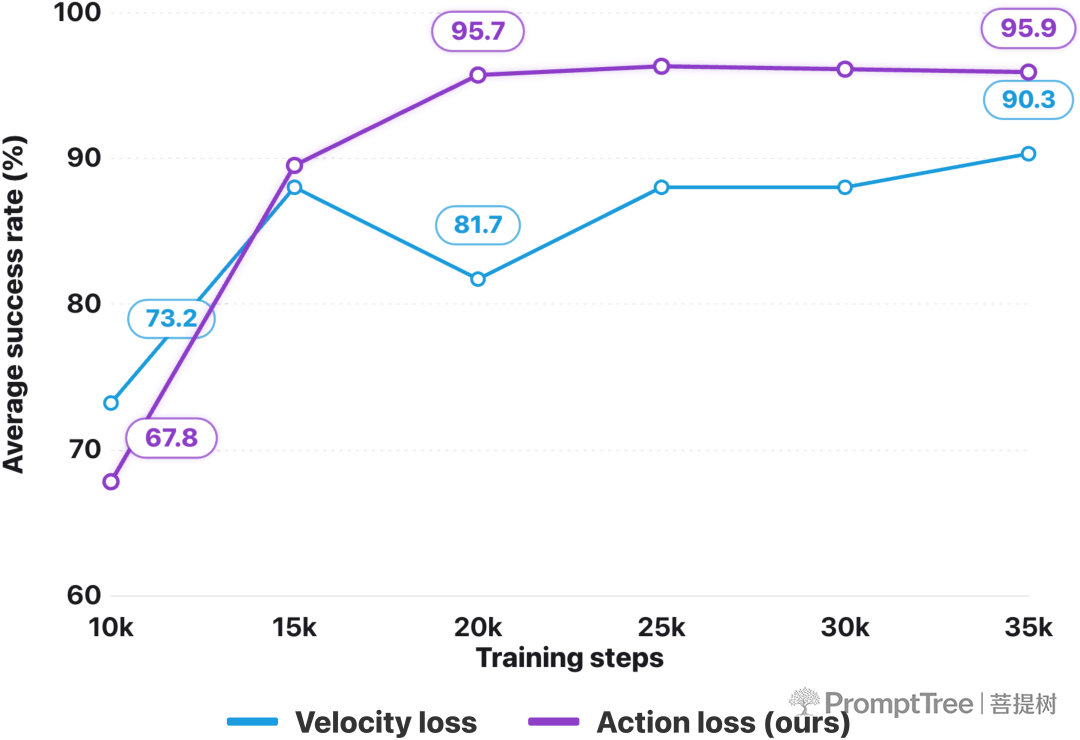
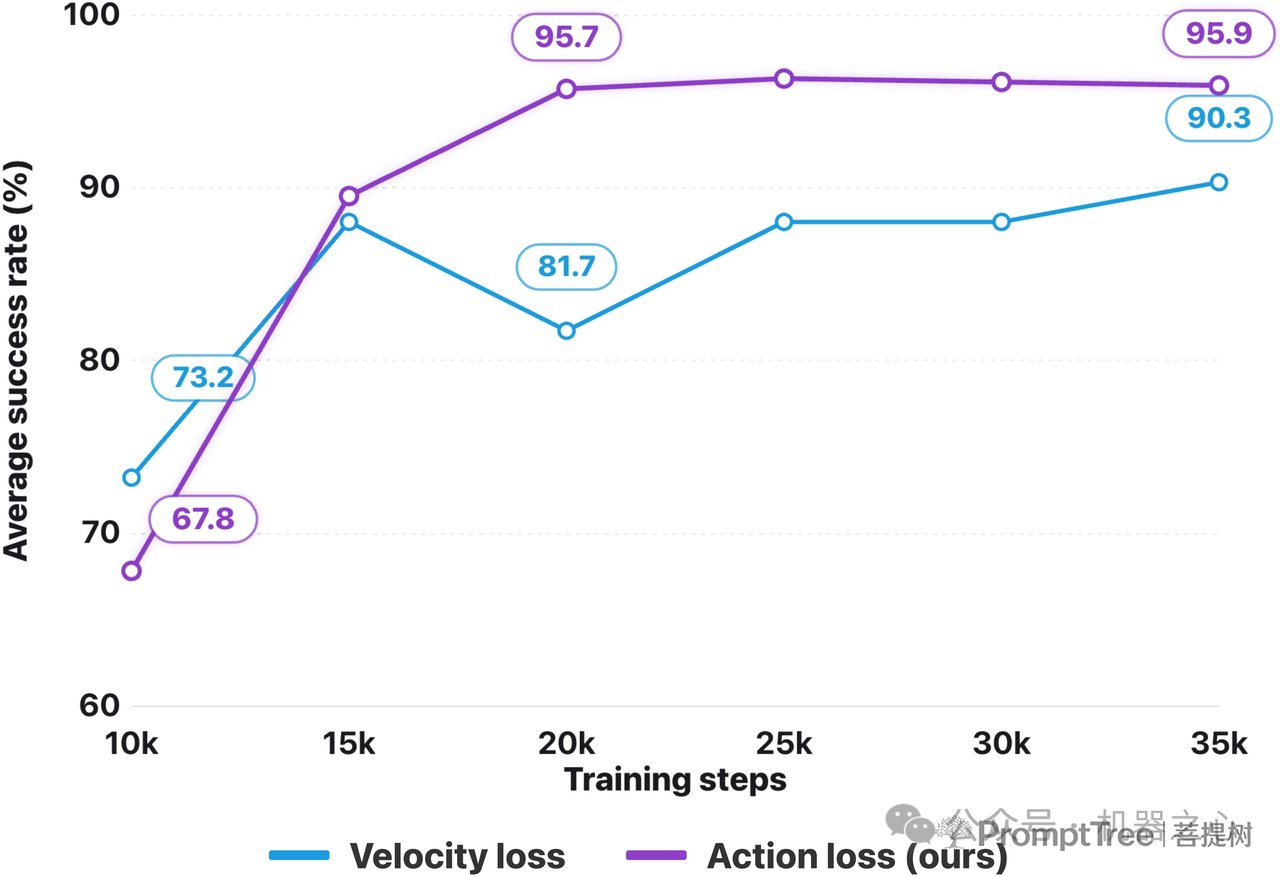
自变量机器人科技于2026年5月28日开源其预训练具身大模型,核心主张为:预训练模型可直接投入使用,后训练并非必要环节。这一结论直接回应了业界长期存在的争议——预训练模型是否必须经过后训练才能实际应用。

技术路径与验证逻辑
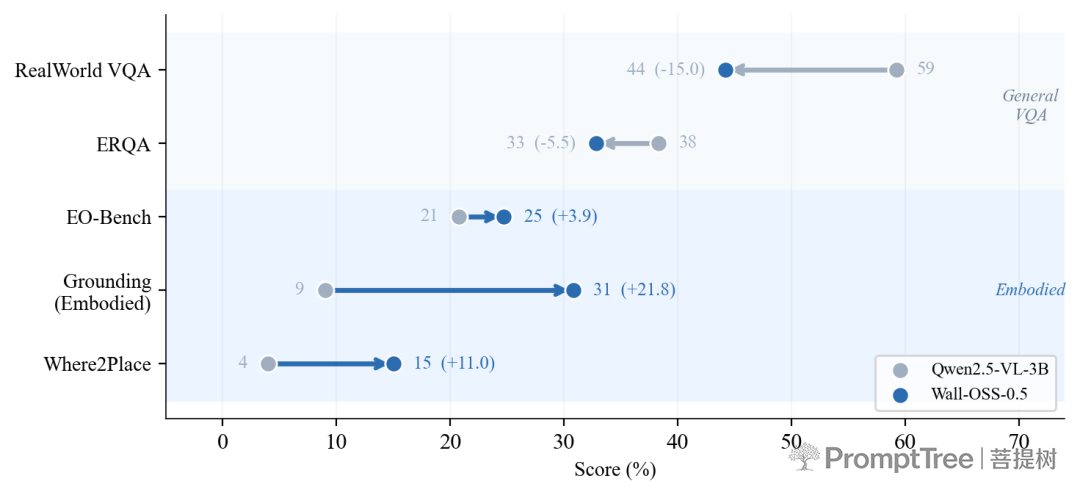
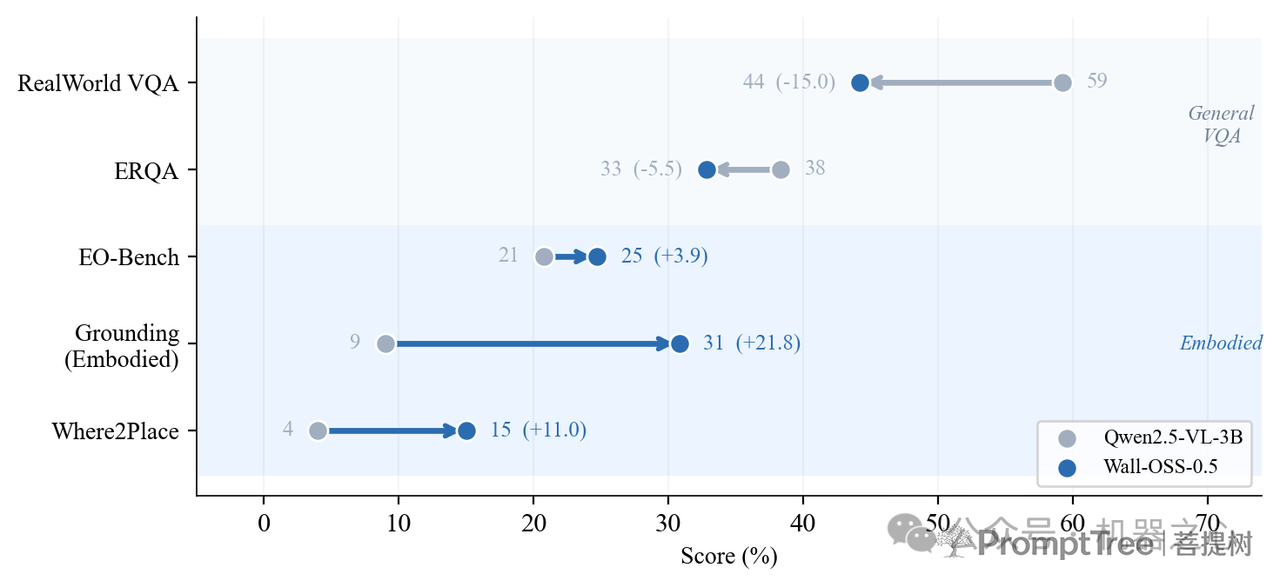
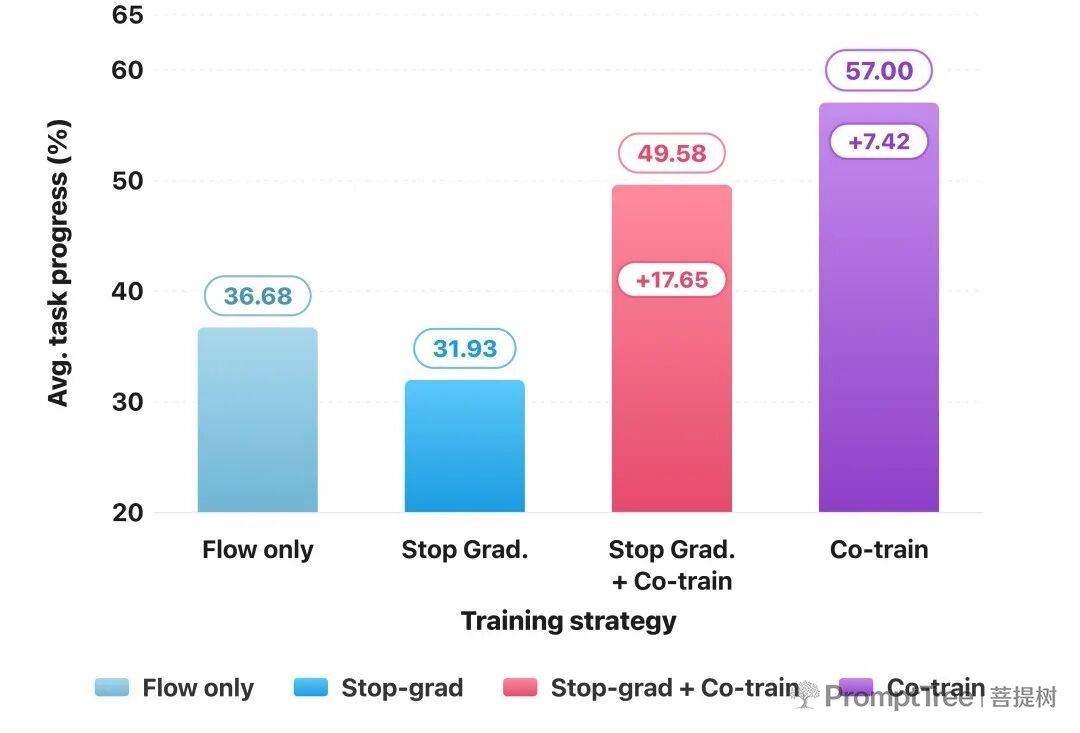
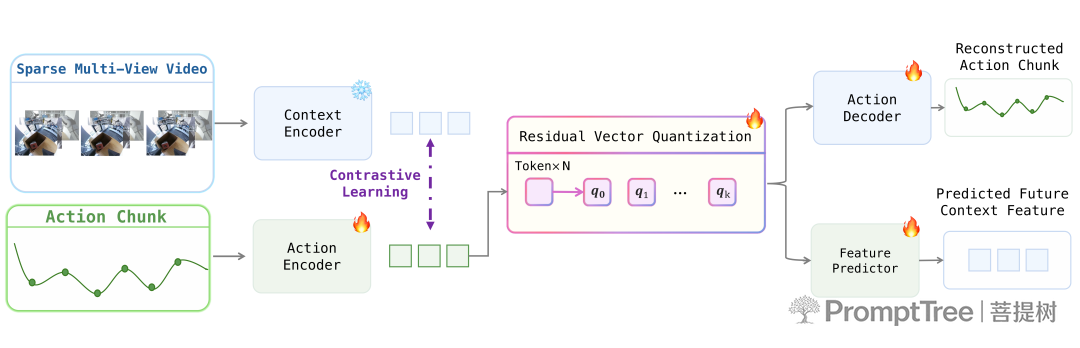
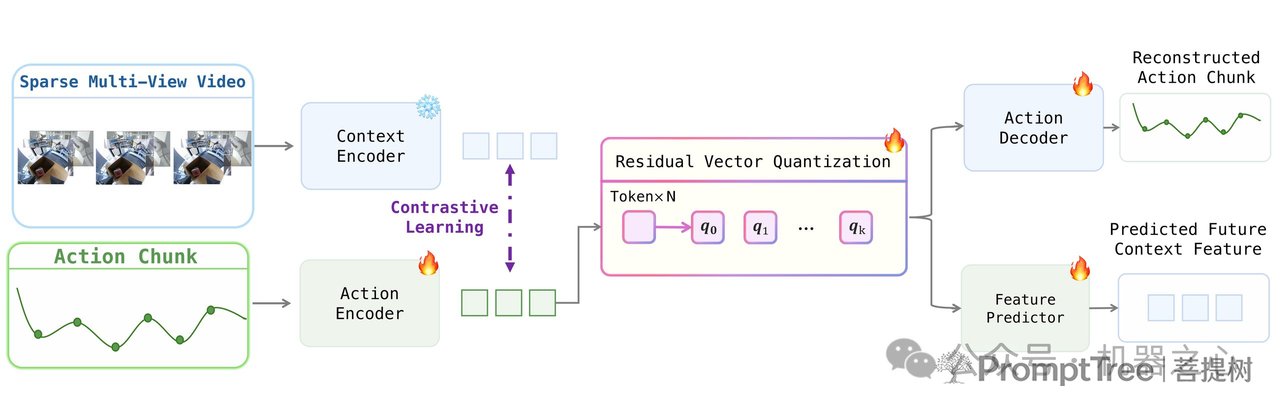
该模型采用预训练优先策略,通过大规模数据训练使基础模型直接具备任务执行能力。与传统"预训练+后训练"两阶段范式不同,这一路径试图压缩从模型到应用的部署周期,降低对特定场景标注数据的依赖。
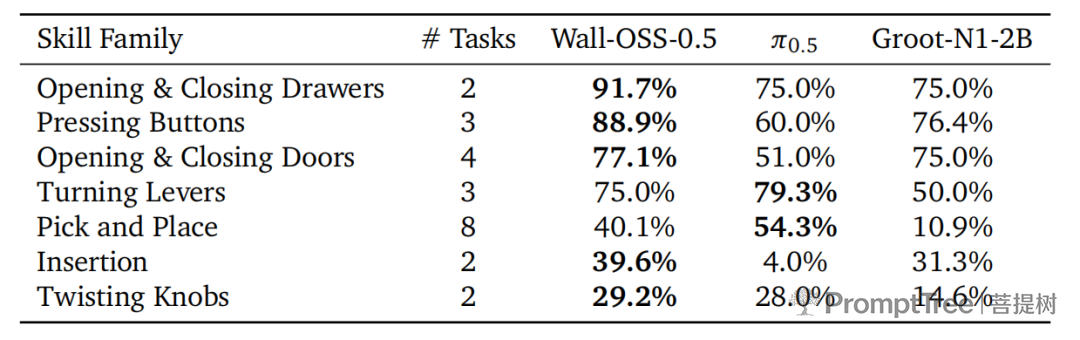
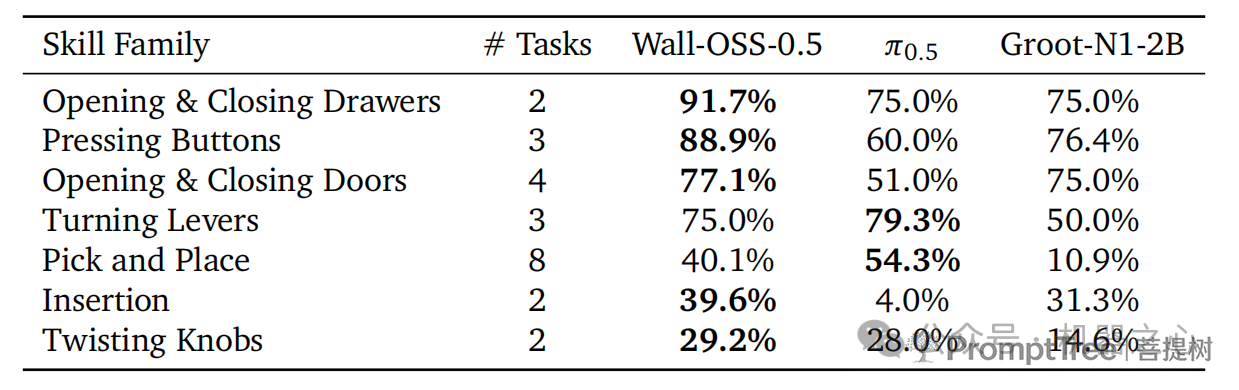
从公开材料看,验证聚焦于多场景任务表现,包括物体操作、环境交互等具身智能典型场景。模型在未经过针对性后训练的情况下,直接输出动作指令并完成指定任务。
开源意义与行业背景
具身智能领域当前存在路线分歧:一派坚持预训练后必须经过微调或强化学习后训练才能实用;另一派认为预训练本身可赋予模型足够泛化能力。自变量机器人科技的开源动作,为后一派提供了可检验的样本。
该模型开源后,研究者可直接获取权重与推理代码,验证其在具体硬件平台上的零样本或少量样本表现。这对于资源有限的学术团队与中小型企业具有实际价值——若预训练模型确可直接使用,将显著降低具身智能技术的准入门槛。
待观察的问题
预训练模型跳过后训练环节,其性能天花板与稳定性边界尚待更多独立验证。不同硬件构型、传感器配置下的迁移效果,以及长时自主运行中的误差累积情况,均需后续研究补充。