自变量机器人发布全球首个「事件级预测」具身智能世界模型WALL-WM
声明:文档由AI根据原文生成。
自变量机器人提出「事件级预测」新范式
2026年5月29日,自变量机器人团队发布全球首个「事件级预测」具身智能世界模型WALL-WM,相关论文《WALL-WM: Carving World Action Modeling at the Event Joints》同步公开。
传统VLA(视觉-语言-动作)模型通常采用固定时间窗口预测:输入当前画面和语言指令,模型逐帧预测接下来0.1秒、0.2秒后手的位置,生成固定长度的动作块。这种「逐帧填空」的方式让模型记住的是「手指每帧挪几毫米」的局部细节,而非「把杯子抓住」的完整目标,一旦更换物体、场景或节奏,模型容易失效。
WALL-WM将预测单位从「时间帧」替换为「语义事件」——模型不再预测0.1秒后的画面,而是直接想象「抓住杯子那一刻」的状态,跳过中间冗余帧,并同步生成抵达该状态的动作。由于「事件」本身是跨场景、跨物体的通用语义抽象,模型在泛化稳定性上表现更优。
文本、视觉、动作「天然不对齐」
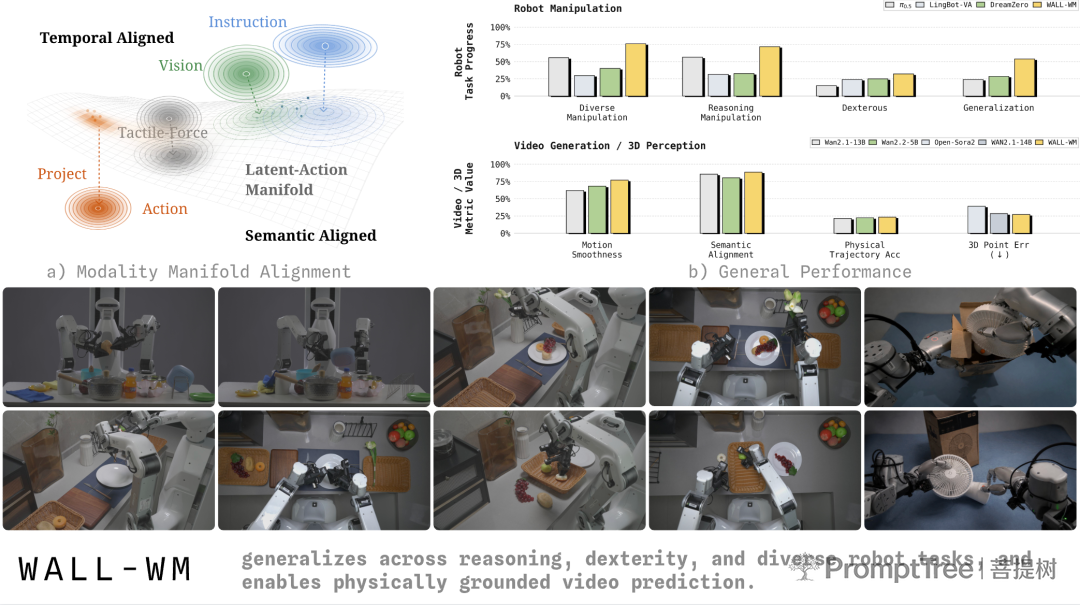
自变量团队在论文中提出一个核心判断:文本、视觉、动作三类信息在高维空间中具有不同的「流形几何」和「时间尺度」,难以被强行压入同一共享空间。
文本是高层、低熵的语义意图;视觉是连续演化的高维观察;动作受物理世界强约束,对接触状态、时间精度和微小扰动高度敏感。三者直接对齐会导致预训练表示偏离原有先验几何,这也是当前不少VLA模型在真机上的表现远逊于底座VLM水平的原因之一。
基于这一分析,团队重新追问:机器人该按什么单位学习动作?WALL-WM给出的答案是「event-centric」——将任务切分在真正有语义、有物理变化的「事件边界」上,如伸手、抓取、抬升、移位、放置等。这些事件可被语言表达、被视频记录、被动作轨迹承载,从而实现语言、画面与动作的真正串联。
三层架构:先预演,再执行
WALL-WM的核心链路分为三层。
第一层为事件指令入口,接收「抓起杯子」「放进篮子」等下一步任务描述。第二层为事件世界模型,围绕事件预演画面变化:物体如何移动、场景如何改变、机械臂如何参与。第三层为多视角时空融合,整合头部相机、腕部相机等不同位置信息,让模型在执行前获得更完整的现场观察。
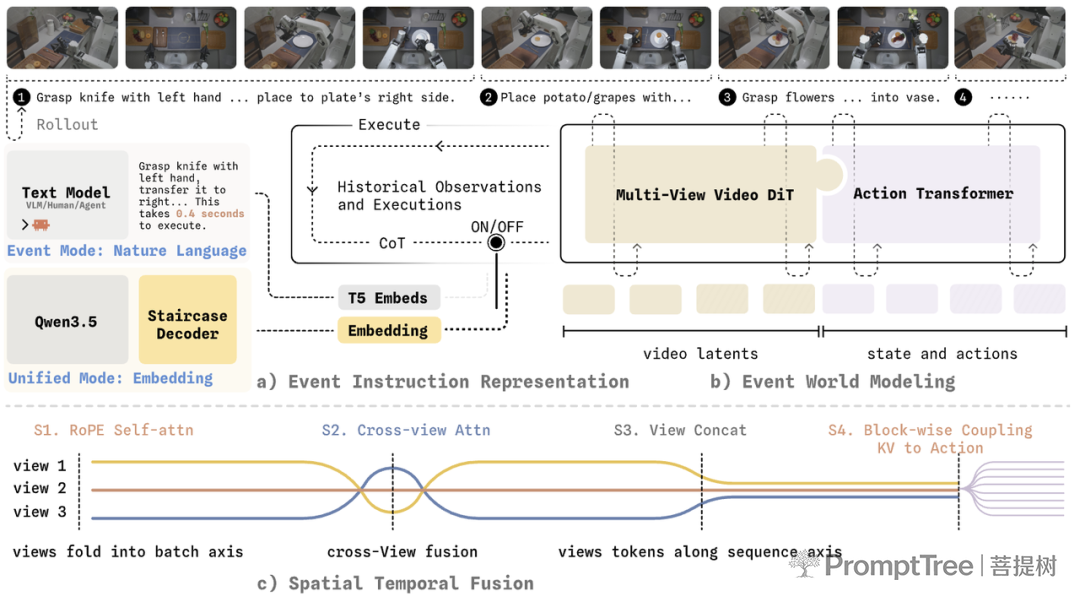
同一套模型权重支持两种推理模式。事件模式下,上层规划器拆好任务后,模型根据事件描述输出长度可变的动作,动作顺着语义事件自然展开。统一模式下,VLM结合当前视觉输入和任务指令,在线生成中间推理,再交由动作模型输出固定长度动作块,适合实时闭环控制。两种模式执行中可按动作块切换,无需为不同场景重新训练。
视频与动作模型「分工生长」
WALL-WM未直接将视频模型改造为动作模型,而是让两者「拆开生长」。视频模型承载互联网视频训练的动态先验,负责理解物体运动与场景变化;动作模型从零初始化,专门学习将视觉变化翻译为机器人轨迹。两者每层单向耦合:动作流读取视频流的视觉证据,视频流保留原有动态先验,避免被动作数据过早「带偏」。
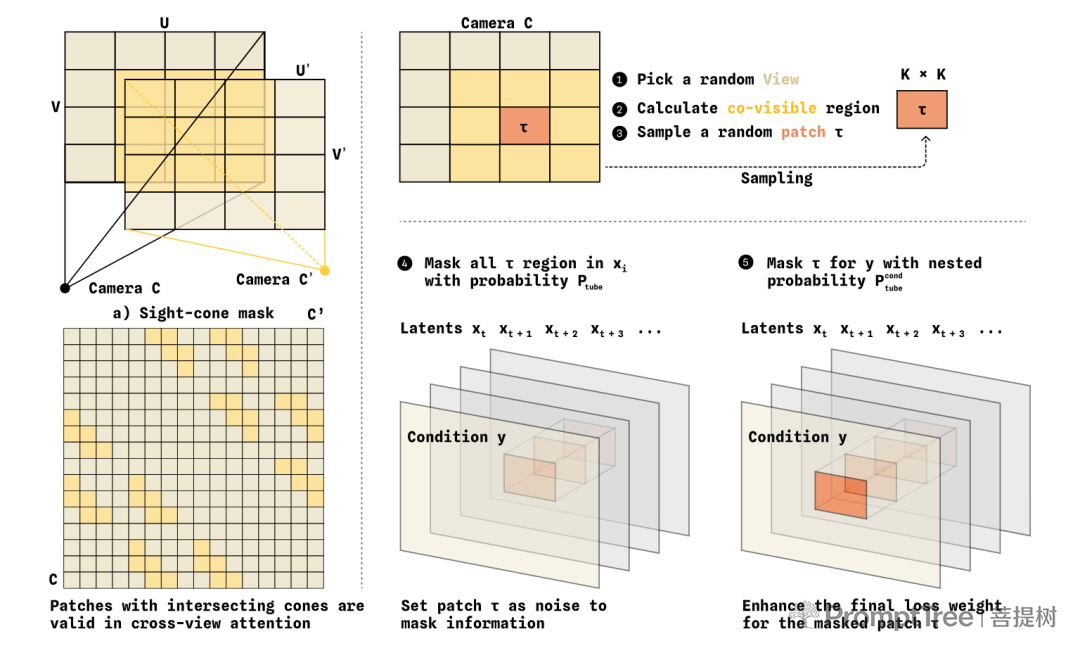
针对多视角融合的几何对齐问题,团队设计视锥掩码与管状掩码。视锥掩码根据相机标定信息,切断三维空间中物理上不可能对应的注意力连接;管状掩码随机遮掉某视角的连续时空区域,迫使模型从其他相机寻找线索。配合可学习的相机旋转位置编码,系统天然支持多本体、多视角的大规模混合训练。
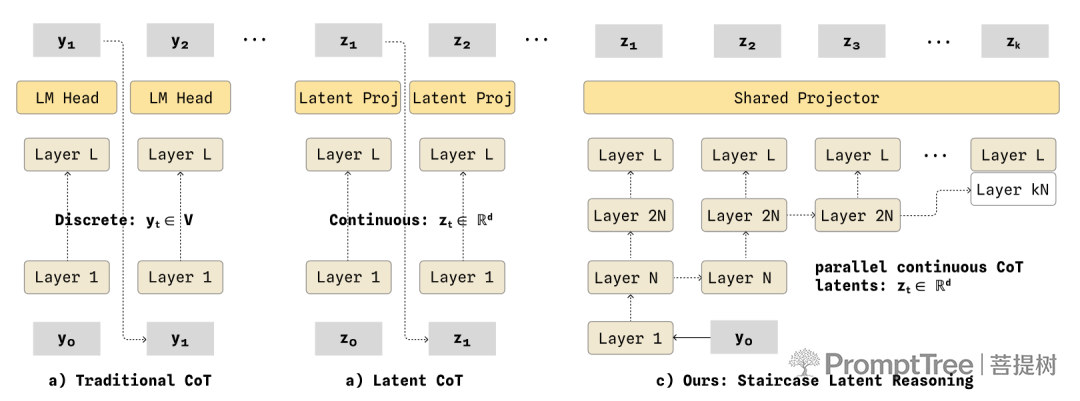
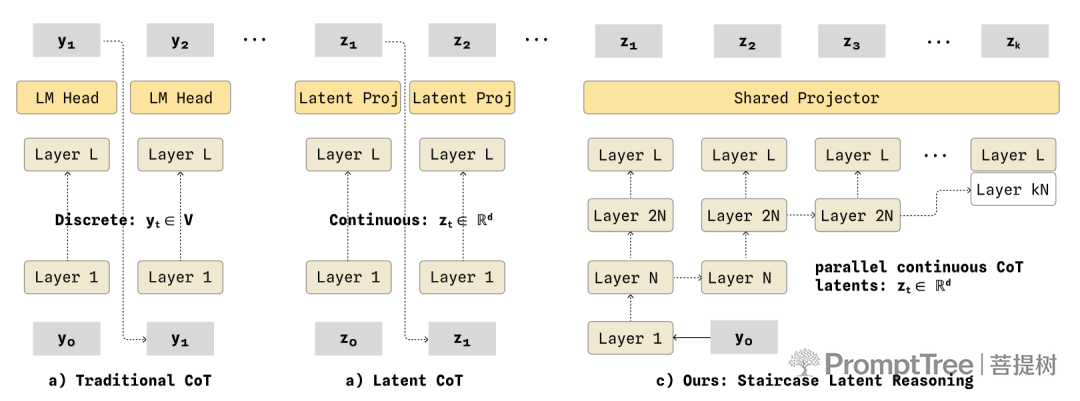
在复杂任务的推理效率上,WALL-WM采用「阶梯式思维链解码」(Staircase Layer-Relay CoT Decoding)。底层抽取共用推理状态,仅运行一次;多个思维token在高层并行完成。生成的连续CoT latent可通过冻结LLM还原为文本推理轨迹,保留可解释性的同时减少逐token解码延迟。
数据金字塔与四级层级标注
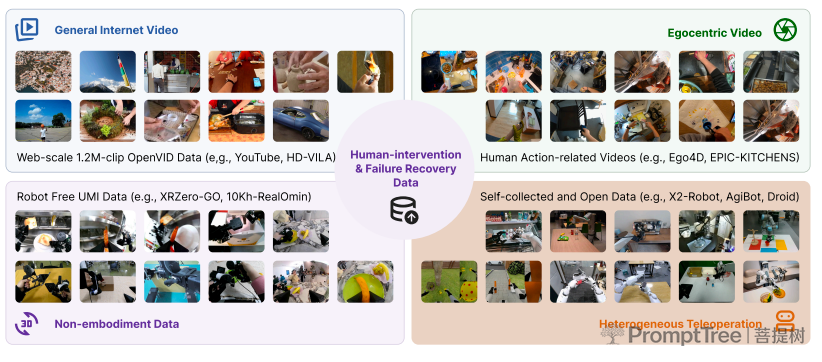
支撑模型能力的还有一套从数据采集到训练部署的系统工程。数据结构采用「数据金字塔」:底层为百万级网络通用视频,往上依次为人类动作视频、第一视角视频、公开机器人数据、自采视频-动作数据,顶端为真机接管、纠错和恢复数据。越往上越贴近真机部署,越往下越接近开放世界视觉先验。
训练阶段采用四级层级化标注(任务、子任务、动作、片段)加双聚类采样,将轨迹拆分为边界清晰的行为单元。论文发现,按动作边界切分文本描述后,语言分布与视觉-语言联合分布更趋均衡,长尾样本更易被训练覆盖。
训练系统方面,团队采用分布式「Muon」优化器(DMuon)提升收敛稳定性,通过多事件打包降低单条样本的计算浪费。部署阶段经蒸馏减少去噪步数,FP8量化降低显存与推理成本,使模型更接近实时控制所需的延迟。
真机泛化实验
实验环节重点验证大规模真机泛化能力。WALL-WM支持不同粒度的event-centric文本输入,可在新指令、新物体、新场景、新任务乃至新本体下完成动作推理与执行。
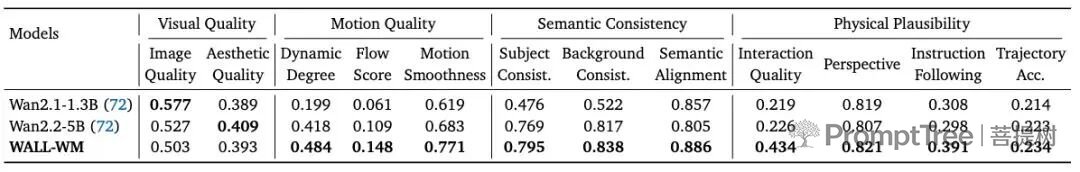
具身视频生成方面,相比Wan2.1/Wan2.2,WALL-WM在Motion Quality、Semantic Consistency、Physical Plausibility三个维度全面领先:
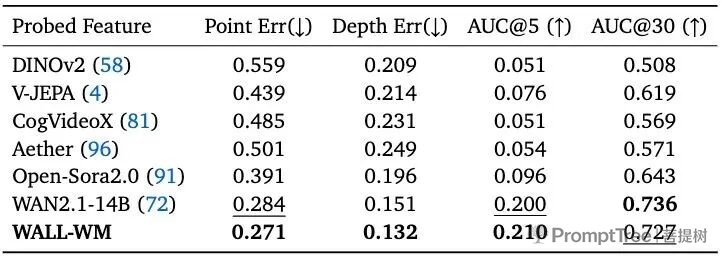
3D感知(CO3Dv2基准)方面,Point Error与Depth Error优于WAN2.1-14B、Open-Sora 2.0、V-JEPA、DINOv2:
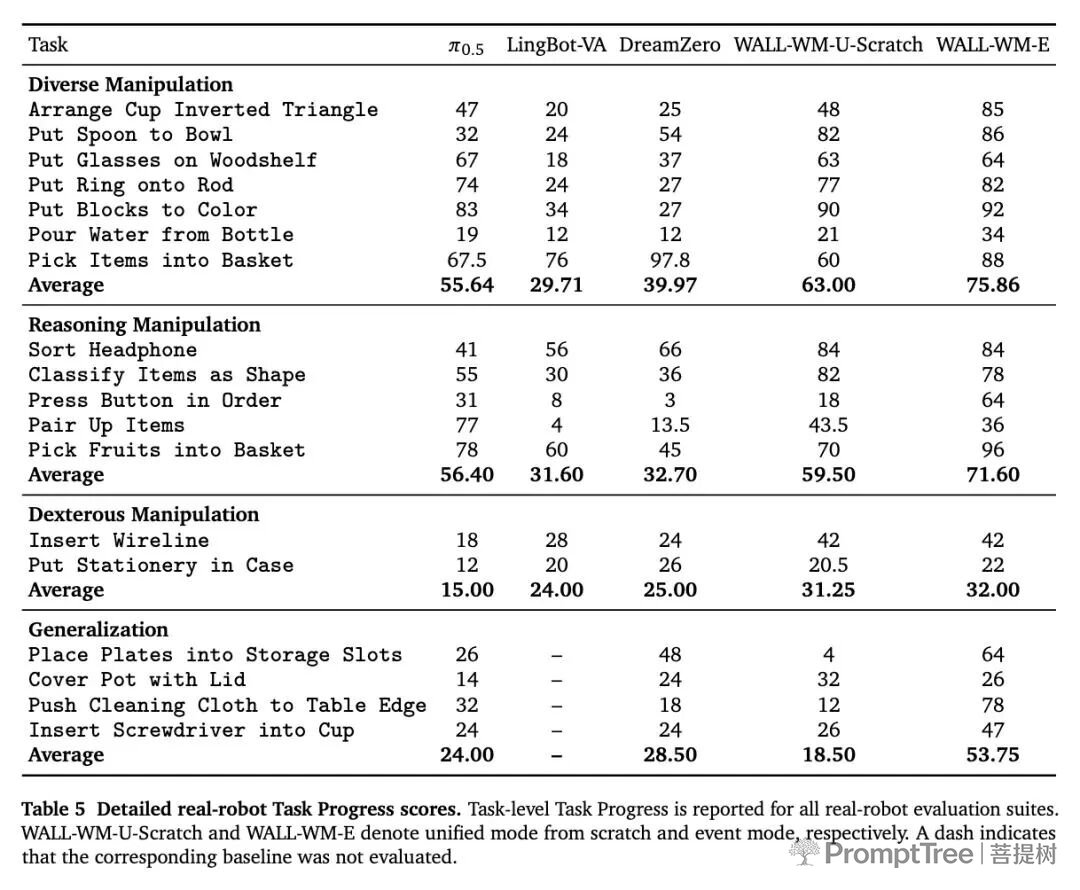
真机Core15 L1基准方面,基础任务、推理任务、灵巧操作、泛化场景的任务完成分数均超过π0.5、DreamZero,在抽象指令设定下为当前完成度最高的L1模型之一:
论文开篇引用柏拉图《斐德罗篇》中的「依乎天理,因其固然」。自变量团队以此概括WALL-WM的核心思路:物理世界的真实任务从不按固定时间窗口整齐发生,而是像一串自然衔接的事件,伸手、接触、抓取、移动、放下——每个关键变化对应动作里的「自然关节」。模型沿这些「事件关节」理解世界、预测变化、生成动作,即使语言、物体、场景、任务组合乃至本体发生变化,机器人仍能顺着事件边界判断进度、推演变化、落子动作。
目前具身智能行业的竞争正从跑分与Demo演示转向真实部署,比拼焦点从「看起来更会动」转向「更能理解变化、组织行动、稳定泛化」。自变量机器人通过WALL-WM将这一方向的工程化范式提前落地。