较主流方法提速500倍!自变量开源HOST框架,让机器人看一条数十秒视频学会新技能
声明:文档由AI根据原文生成。
自变量机器人开源HOST框架,单视频技能学习成功率达62%
8月3日,自变量机器人发布HOST框架并开源。该框架全称为Human-to-robot One-Shot Skill AcquisiTion(人类到机器人单样本技能获取),能够让机器人仅通过观察一段数十秒的人类视频学习新技能,同时保留已掌握的技能。
从"模仿动作"转向"想象结果"
传统机器人学习人类技能时,通常需要将人类动作翻译为机器人动作进行模仿。HOST采用了不同的思路:让机器人先想象执行动作后的结果,再从结果中反推需要执行的动作。
这一设计源于认知科学中的"观察学习"理论。人类面对陌生任务时,会以先验能力在大脑中模拟动作的预期效果,再执行相应动作。自变量研究人员据此将学习方案从"训练时微调循环"改为"推理时技能获取"。
机器人学习人类视频面临两个核心难点。一是任务进度对齐:同样10秒钟,视频中的人可能已切完菜开始炒菜,机器人还在切菜。HOST将视频每一帧和机器人操作每一步转化为同一向量空间的向量,利用"动态时间规整"算法自动对齐进度,将对齐时间误差降低一个数量级。
二是身体结构差异:机器人构型各异,无法简单"照着做"。HOST分三步解决:判断任务进度、将人类执行画面翻译为机器人视角画面、从画面推断并执行动作。这一"看到结果-想象结果-反推动作"的路径,绕开了动作映射难题。
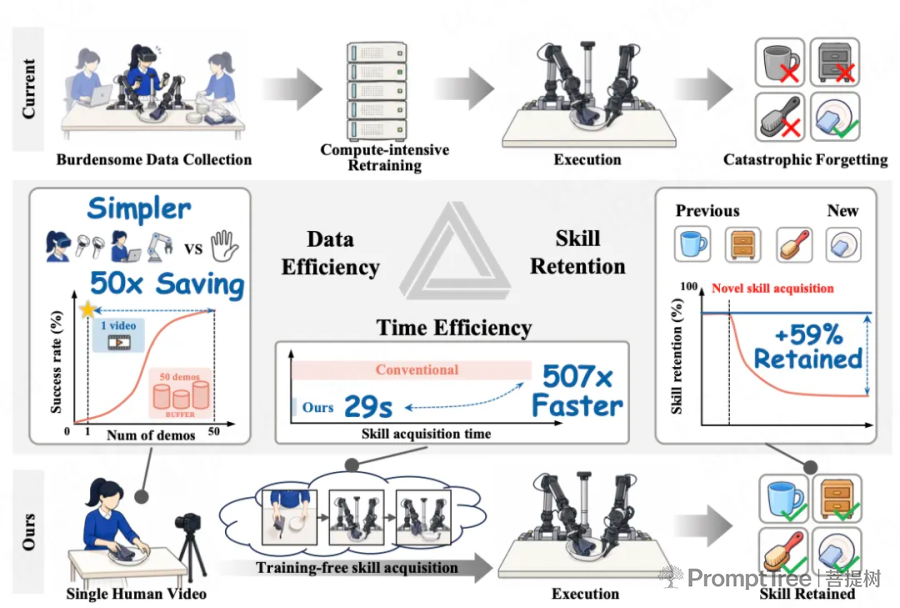
双专家架构与两步训练
HOST的核心是一个带有视觉预测功能的级联策略模型,采用双专家MoT(Mixture of Transformer)架构。"视觉大脑"(视频专家)处理画面、定位进度、预测未来图景;"动作大脑"(动作专家)将预测图景转化为执行动作。
训练分为两个阶段。同体预训练阶段,机器人通过自身执行任务的视频,学会预测完成状态并生成动作。人机视频训练阶段,机器人学习人类演示视频,将人类过程转化为机器人视角下的任务结果,再推理所需动作。这种设计利用了机器人视频数据易采集的特点,人与机器人匹配数据稀缺的问题被后置处理,大幅提升了训练效率。
数据需求降至1/50,学习速度提升500倍
模型权重训练完成后即冻结,仅在推理时观看视频复现技能。测试显示,仅观看一段平均29秒的人类视频,HOST复现技能成功率达62%。Vid2Robot/AWDA同等条件下成功率为19%;Pi-0.5经50个任务示范、4小时微调后成功率仅38%。
相比Pi-0.5+微调方案,HOST数据样本量缩减为1/50,学习时间缩短为1/500,成功率反提升24个百分点。
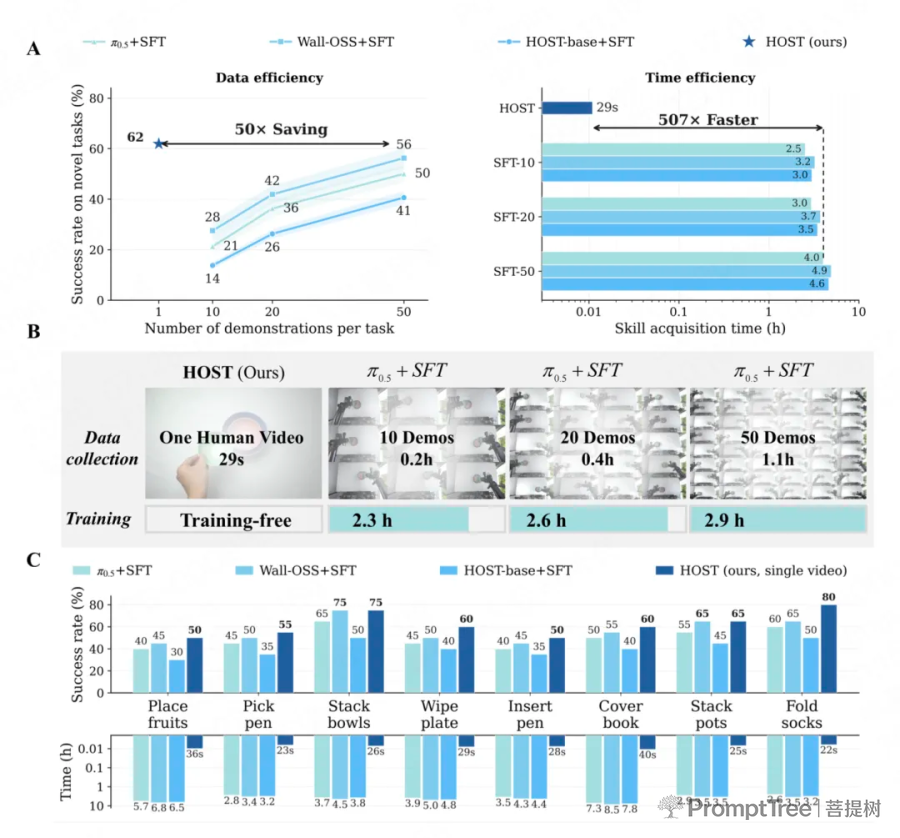
HOST还能最大限度保留已学技能。因其仅根据视频复现,视频如同"菜谱"可随时调取,实现技能持久化记忆。Pi-0.5+微调方案学习新技能后,旧技能保留率仅17%。
泛化性测试中,HOST在50个包含不同物体、工具和基本动作的任务上均学会新技能。鲁棒性方面,面对光照变化、物体替换、场景替换、物体移动等干扰,成功率均保持50%以上。即使物品中途被挪走,机器人也能调整回来继续任务,表明其真正理解任务而非死记动作序列。
研究论文与代码已开源
自变量机器人团队表示,具身智能走向家庭不应依赖专业人员反复训练,人与人之间通过示范传递技能更为自然高效。HOST将技能获取从专业流程转变为任何人用一段视频即可完成教学。
目前,HOST的研究论文和代码已全部开源。