智元发布GE-Act 2.0,首次验证原生世界—动作模型预训练与Scaling路径
声明:文档由AI根据原文生成。
300小时到3万小时:机器人模型能否随数据增长不断解锁新能力
智元最新发布的原生世界—动作模型GE-Act 2.0给出了肯定答案。与沿用现成视频生成模型的主流路线不同,该模型所有参数——包括视觉表征、未来生成、动作预测等核心组件——均从随机初始化开始,在具身操作数据上从头训练。训练完成后不做任何微调或示范,直接在陌生场景、陌生物体上接受真机零样本检验。

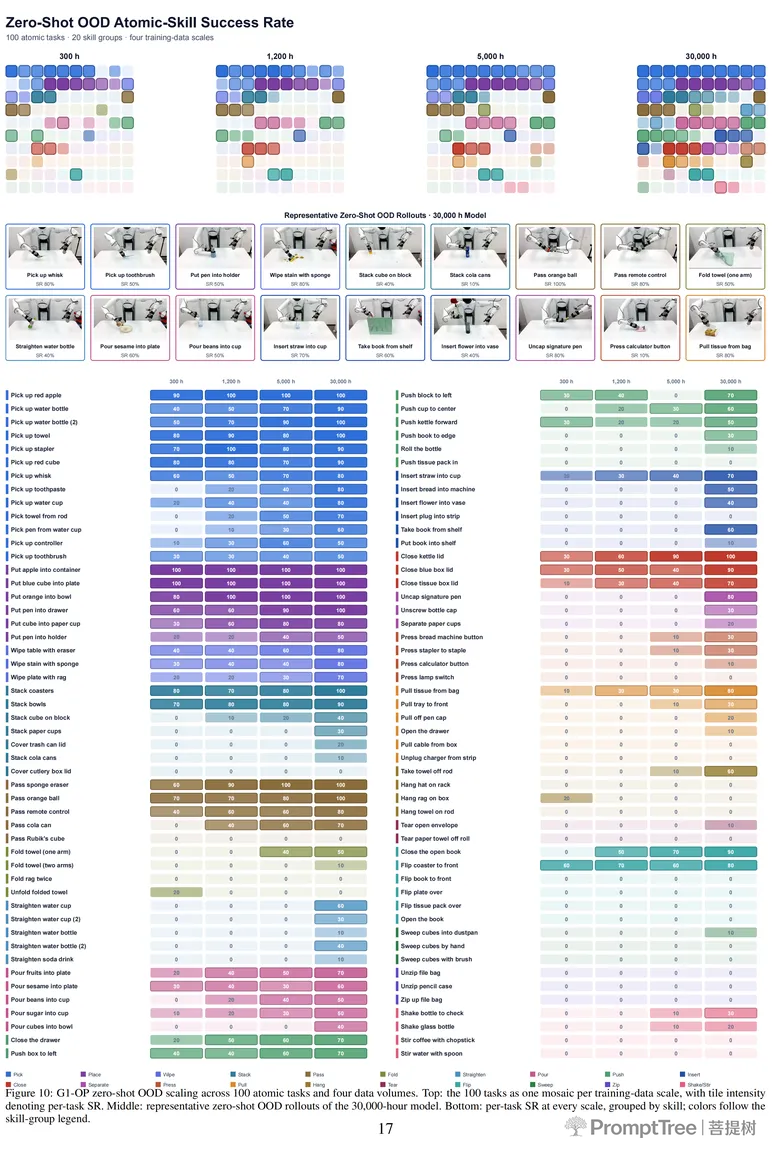
测试覆盖100项原子任务、20类技能、两种机器人本体。结果显示,数据规模扩大100倍后,模型不仅原有技能更稳定,还逐步解锁了此前完全无法完成的新任务,包括折叠毛巾、嵌套纸杯、拔插笔盖、插花等较精细动作。
01/ 用 Zero-shot 检验预训练
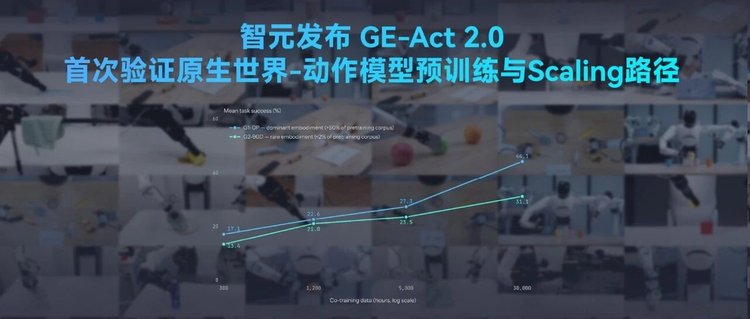
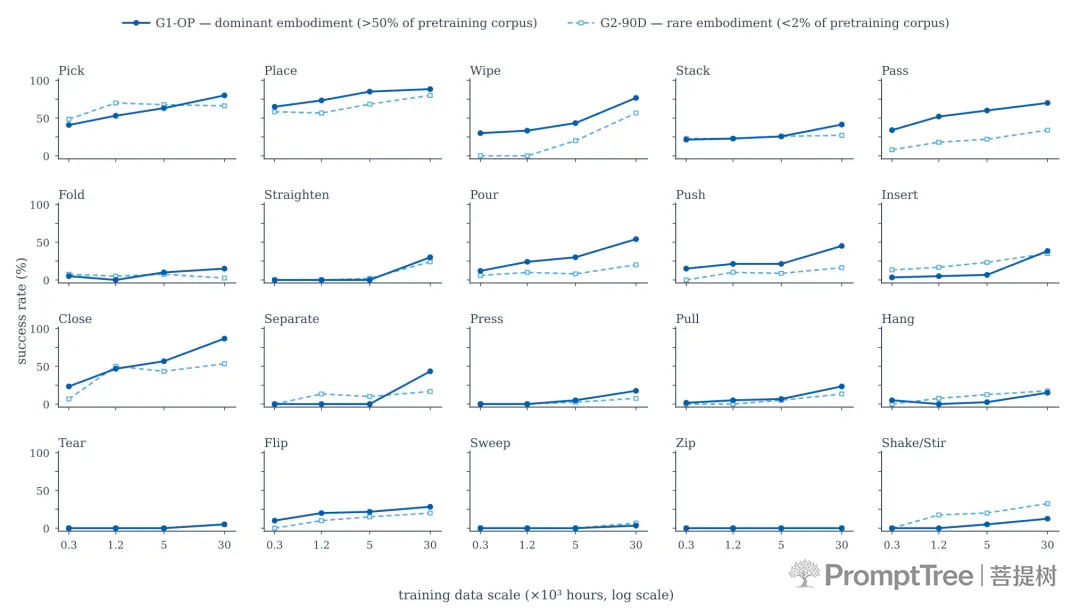
GE-Act 2.0将真机零样本表现作为核心标准:不微调、不示范、不换模型,测试中的场景、背景、光照和物体实例均未进入训练。在相同训练配方下,最后一阶段分别使用300、1200、5000、30000小时四档数据,三条Scaling线索清晰显现。
技能"逐格点亮":取得非零成功率的任务,在G1-OP机器人上从39项增至76项,在G2-90D机器人上从24项增至72项。折叠毛巾、嵌套纸杯等精细动作在小规模数据下无法理解,3万小时时出现显著的能力跃升。
任务成功率持续提升:G1-OP总体成功率从17.1%升至44.1%,G2-90D从13.4%升至31.1%,且5000到30000小时仍未见明显饱和。
"富本体"带动"稀缺本体":G1-OP贡献超50%训练数据,G2-90D占比不足2%,后者仍随共享数据扩大提升17.7个百分点,跨本体能力迁移真实发生。
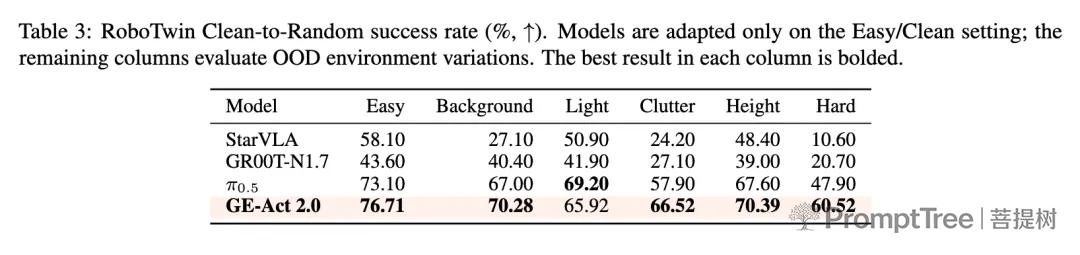
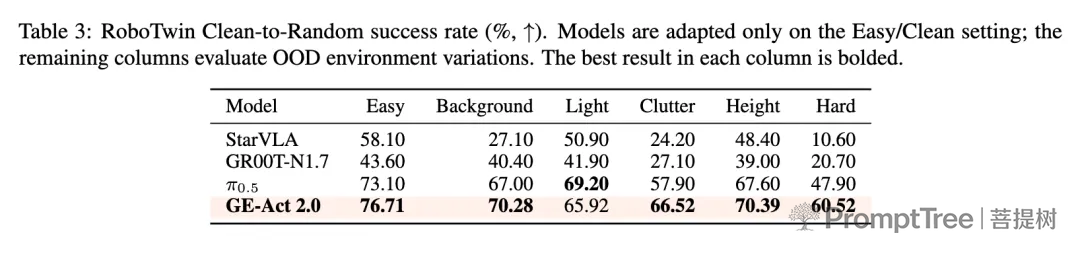
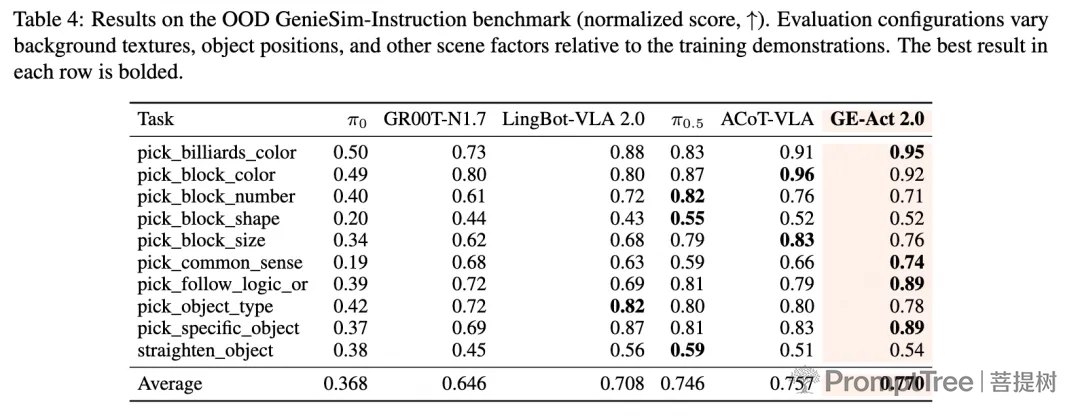
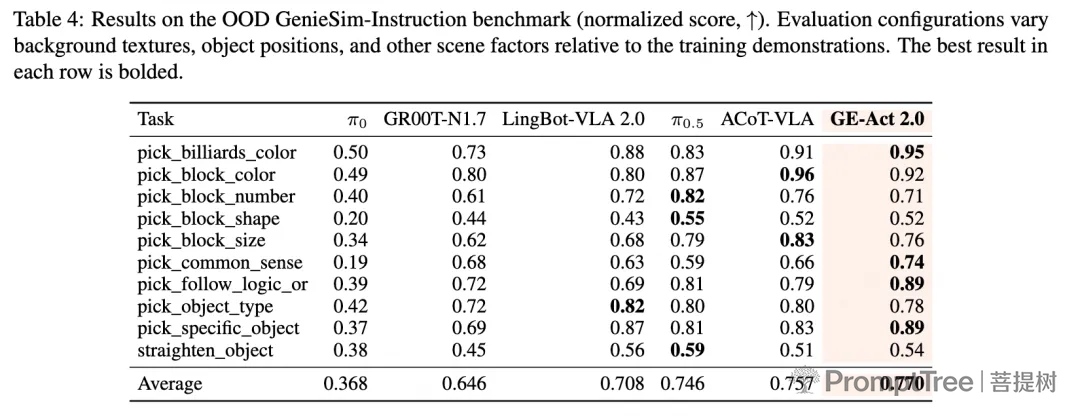
作为补充,微调后的GE-Act 2.0在RoboTwin陌生环境测试中取得60.52%成功率,在GenieSim指令遵循测试中获得0.770分,均超过π0.5、GR00T N1.7等对比模型。
02/ 原生World Action Model如何预训练
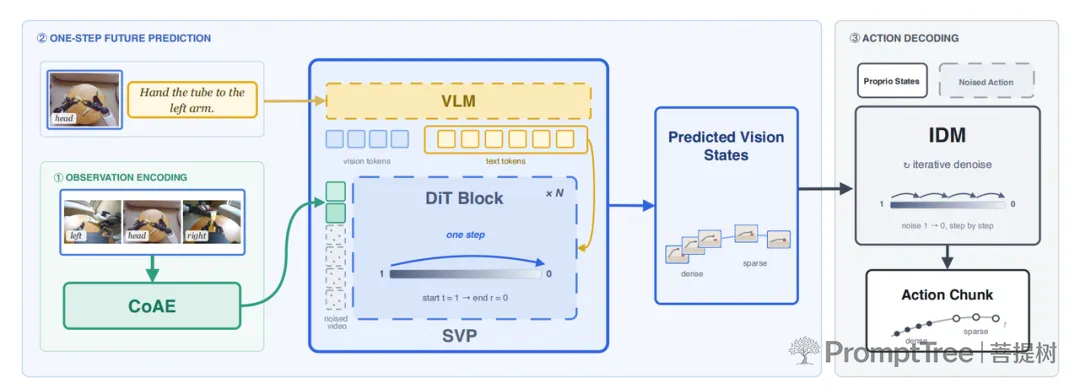
传统动作模型"看到什么就做什么";世界—动作模型多走一步:先预测"这样做下去,世界会变成什么样",再决定动作。但大多数同类模型从现有视频生成模型出发再接入动作模型,难以看清世界预测与动作能力究竟如何从具身数据中获得。GE-Act 2.0面向具身操作重新设计整套架构,给出了从头预训练的完整方法论。
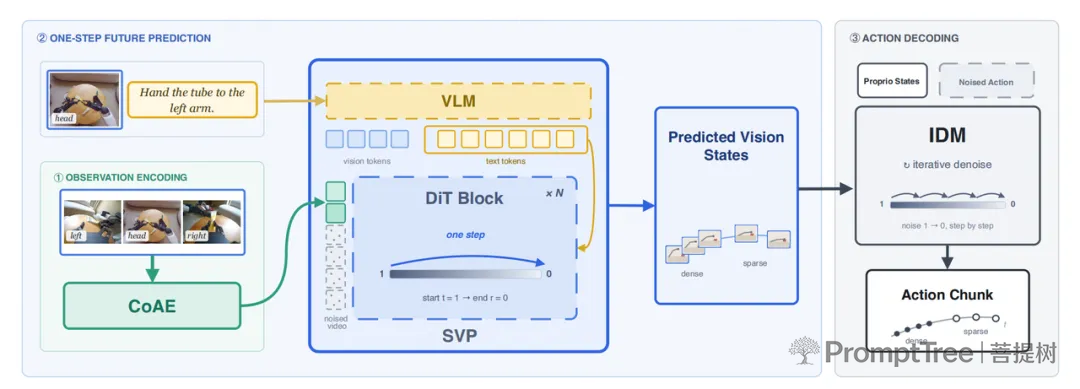
原生高效表征:一帧画面压缩为24个token
机器人既要看清物体和运动,又要控制计算成本。GE-Act 2.0设计视觉编码器CoAE,将一帧256×384画面压缩为24个视觉token,仅为DINOv3的十六分之一,同时保留语义、运动与局部结构。压缩后反推动作的精度与DINOv3、V-JEPA 2.1等高信息量表征接近,在4000条机器人操作数据的受控测试中,指令—画面匹配准确率达97.95%,为五种对照表征中最佳。
原生视觉规划器:让"想象"与"行动"共同优化
世界模型预测未来,逆动力学模型生成动作。传统方法需多轮计算生成未来,计算与显存占用极高,两个模型难以共同训练,推理速度也慢。GE-Act 2.0采用一步式视觉规划,一次生成完整未来,并让动作误差直接反馈给世界模型。配合高效视觉表征,模型在RTX 5090显卡上生成一个chunk连续动作仅需104毫秒。
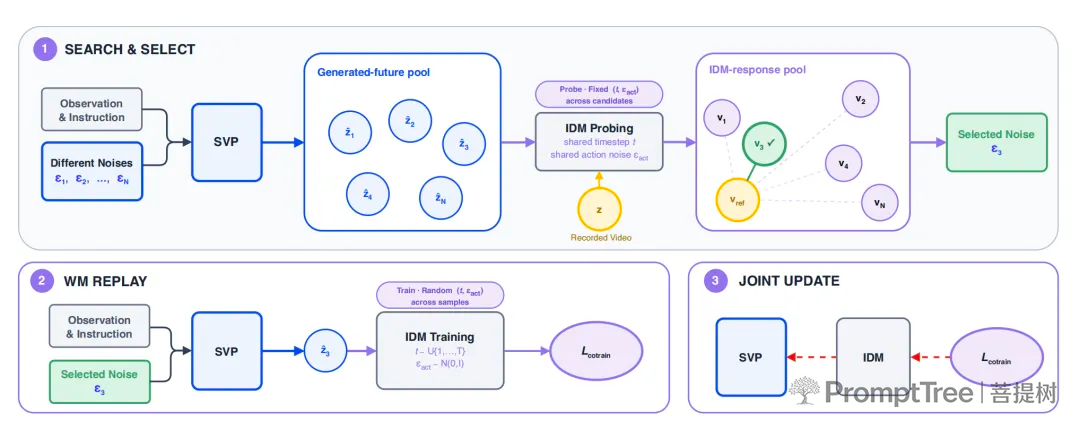
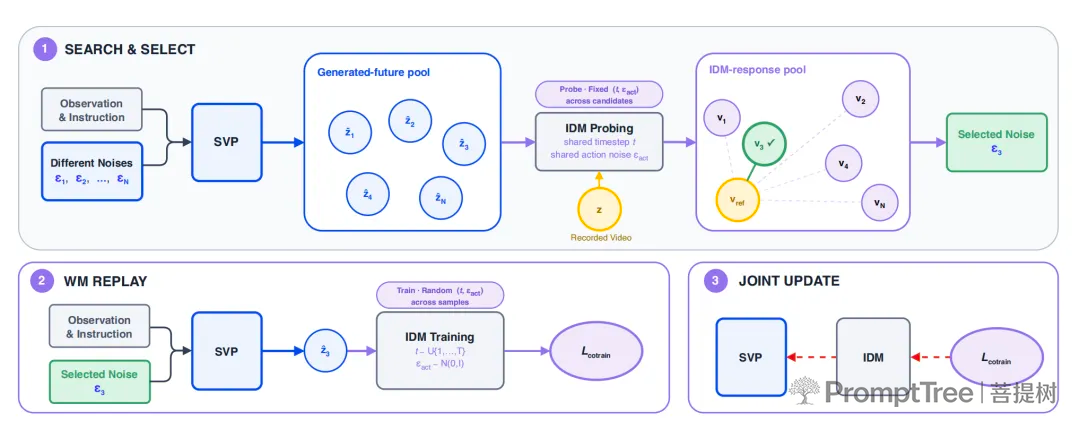
联合训练方案:KASO破解"预测和动作对不上"
同一任务常有多种正确做法:模型想象"左手抓取",数据记录的却是"右手",各自合理,合在一起就是错误信号。GE-Act 2.0以知识对齐选择性优化方法(KASO),一次生成多个可能的未来,只选择与真实动作最一致的结果参与训练。在陌生场景的分布外评测中,机器人选对指令目标的比例较基线提高7.5个百分点,最终抓取成功率提高10个百分点。
03/ 一套"吃进所有数据"的架构
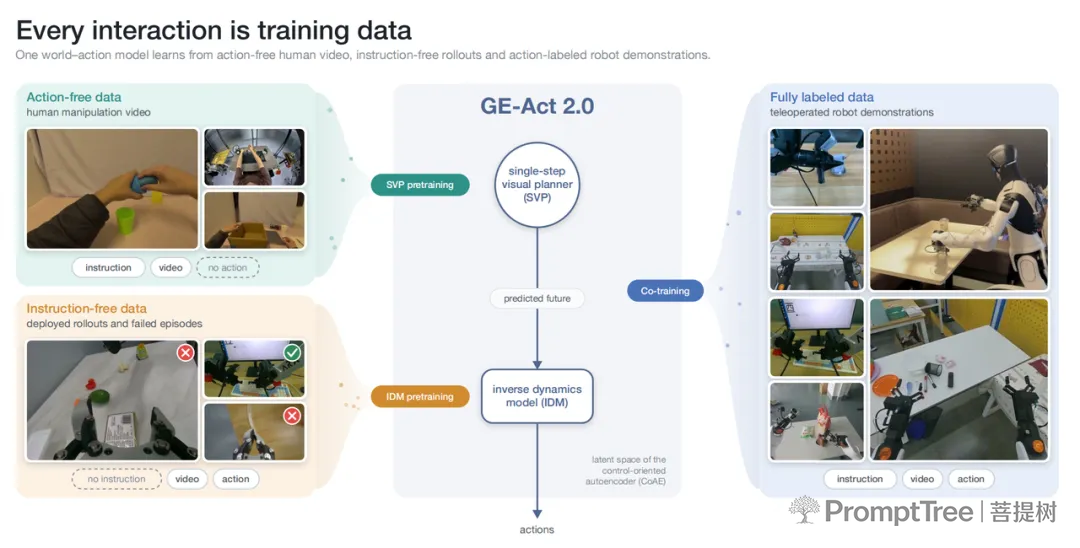
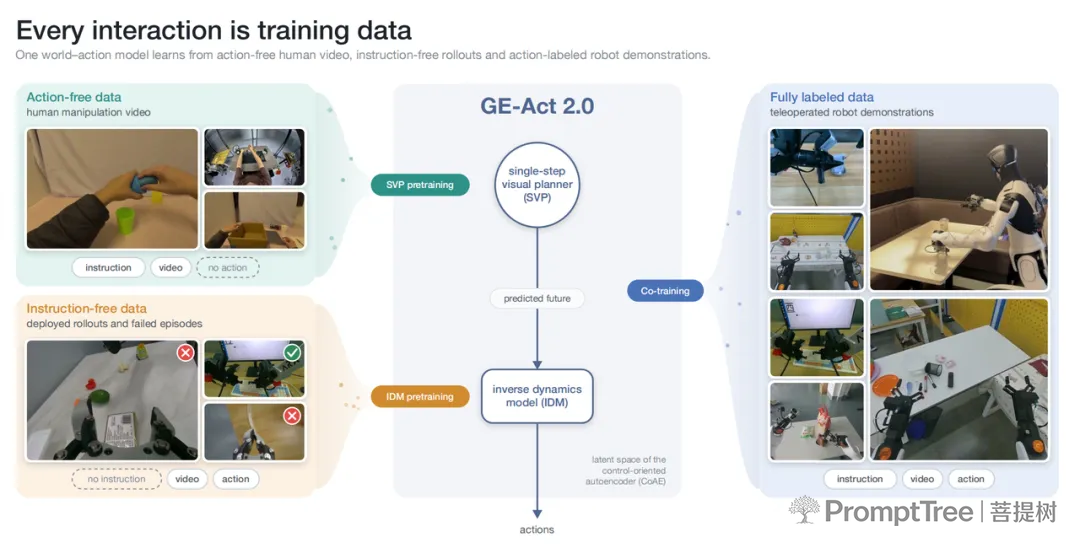
机器人训练与部署中产生的数据形态各异,传统模仿学习依赖完整的"指令—画面—动作"配对,大量数据因此被浪费。GE-Act 2.0提出的数据架构让每类数据承担合适任务:
3.9万小时"指令—视频"数据预训练世界模型,学习环境如何变化,其中含3000小时无本体数据(不带动作标注的第一视角与人类操作视频);3.2万小时机器人轨迹预训练逆动力学模型,学习"画面这样变化时机器人做了什么",其中含2000小时失败操作与真实场景部署回流数据,不要求成功标签;3万小时"指令—视频—动作"完整数据进行联合训练,把两种能力连接起来。
借助逆动力学模型,无指令、无成功标签、甚至失败的轨迹都能还原出动作监督信号——失败数据也能成为训练资产。
GE-Act 2.0验证了原生世界—动作模型可规模化的预训练路径。在智元GE世界模型体系中,GE-Sim面向策略评估与环境构建,GE-Act将未来预测转化为真实机器人的操作能力。项目主页与论文地址:https://ge-act-v2.github.io/