视觉语言动作模型如何让AI宠物机器人真正“活”起来
声明:文档由AI根据原文生成。
核心要点
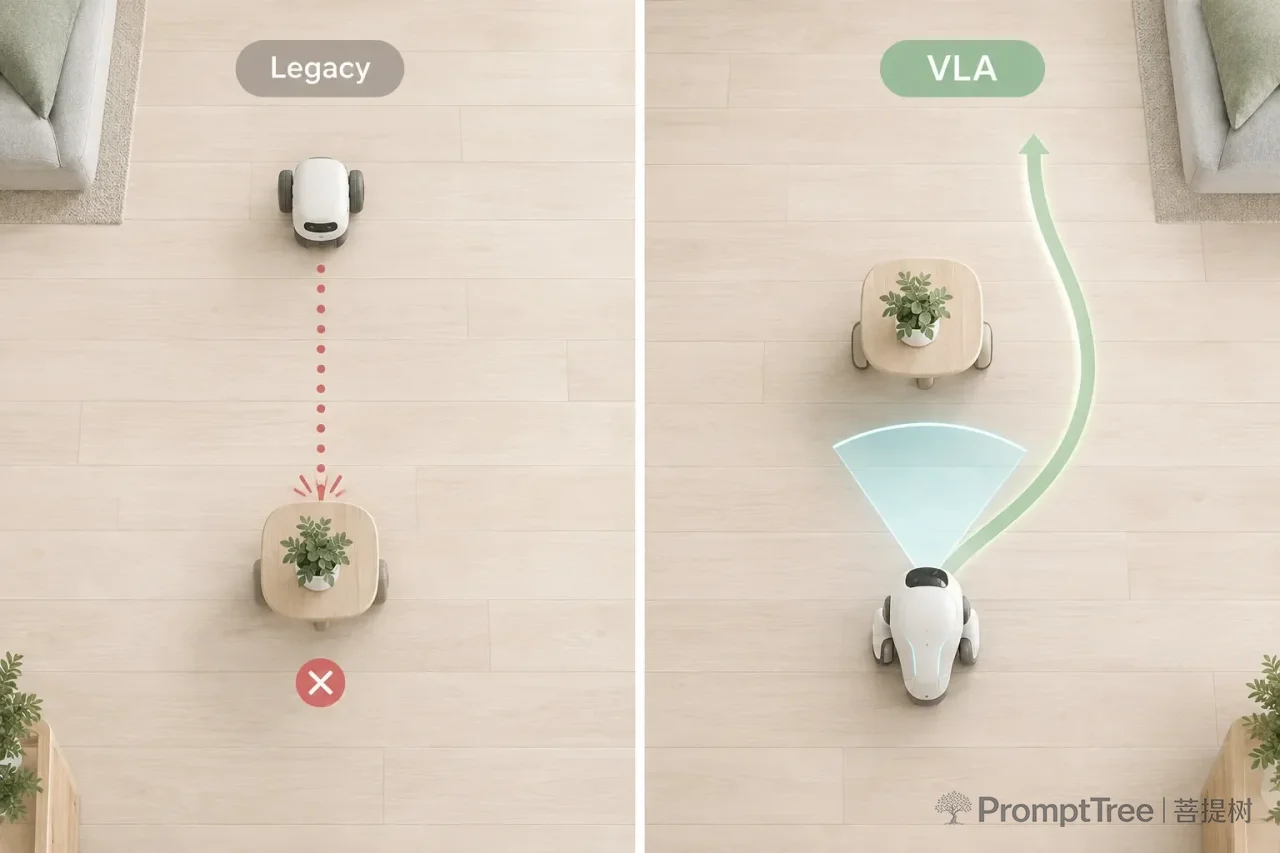
早期AI宠物之所以显得机械,根源在于反应时间与僵硬的动画。传统机器人遇到新障碍时,其软件栈会陷入混乱,试图将像素转化为脚本指令。
VLA模型改变了伴侣机器人的运动方式,它将实时视频与语音指令直接发送至电机速度控制器。
- 不再有冻结动作: 稳定运行10–20 Hz的循环,让机器人能够即时调整路径,而不是在地毯边缘戛然而止。
- 自然的微动作: 通过平滑调整电机速度而非跳转预设姿态,机器人可以做出自然的耳朵抖动、身体位移与头部倾斜。
- 本地反射保护: 深度语音对话在云端运行,而像SmolVLA这样的微型本地模型可在200毫秒内处理快速平衡与安全停止。
从脚本化玩具到非脚本化视觉语言动作模型伴侣的演进
早期电子宠物依赖基本的状态循环,当简单传感器被触发时,便播放预设音频片段并执行固定的电机动作。
架构转变:VLA与VLM
要实现真正的独立行为,现代机器人需要一套将视觉直接连接至物理运动的系统。标准的视觉语言模型仅处理图片与文本并输出文本,本质上像一个没有身体的“大脑”。
视觉语言动作模型的工作方式不同:动作解码器将平滑的关节运动转化为简单的标记——通常每个关节256个。这赋予非脚本化机器人宠物即时反应的快速灵活性。
多模态基础模型为何重要
多模态基础模型不再使用独立的软件模块将摄像头数据传递给规划系统,而是在单个Transformer内直接处理视觉输入与运动传感器。关键设计变化包括:
- 消除硬编码脚本: 轨迹动态生成,而非从固定动画库中回放。
- 直接感知映射: 摄像头画面直接告知轮子与关节速度,无需中间翻译层。
- 零样本适应性: 不熟悉的家庭障碍物触发实时轨迹调整,而非碰撞循环。
通过将物理运动与文本、视觉一同转化为标记,VLA设计提供了自然宠物互动所需的基础认知系统。
视觉语言动作模型如何在单次神经网络传递中处理视觉、语言与物理运动
你让桌面机器人宠物去取玩具。它却停在原地。你看着面部显示屏闪烁了三秒,内部软件一片混乱。摄像头画面传给物体检测器,物体检测器传给空间映射器,空间映射器传给路径规划器,路径规划器传给电机脚本。等它抽动一下腿,那个自然的瞬间已经消失,生命的幻觉也随之破灭。
这种尴尬的停顿,正是传统机器人不愿示人的秘密。
从破碎的装配线到统一策略
几十年来,工程师像设计数字装配线一样设计机器人。一个软件模块识别物体,另一个解析语音输入,第三个映射坐标,最后一个控制器驱动电机。在动作中途遮挡摄像头,整条脆弱的链条就会崩溃。
视觉语言动作模型将整套复杂流水线扔进垃圾桶。VLA不再连接四五个独立系统,而是运行在单个多模态Transformer上。摄像头画面、语音指令与实时关节位置全部流入一个统一网络,另一头直接流出连续动作标记。没有中间符号交接,没有翻译损失,只有原始的端到端电机控制。
| 对比维度 | 传统模块化架构 | 标准VLM架构 | 统一VLA模型(如SmolVLA) |
|---|---|---|---|
| 主要输入/输出 | 传感器 → 脚本/动作预设 | 视觉+文本 → 文本/语音 | 视觉+文本+本体感觉 → 关节电机速度 |
| 控制循环延迟 | 高延迟(500ms–3s交接) | 不适用(非物理输出) | 低延迟(<100ms闭环) |
| 适应性与安全性 | 刚性规则;遇到新杂物即崩溃 | 仅文本推理;无物理碰撞感知 | 零样本空间调整;优雅的轨迹修正 |
| 运动表现力 | 阶梯式、生硬的机械运动 | 静态/与物理运动脱节 | 有机连续动作标记(微表现力) |
超越被动视觉:主动空间智能
这种架构转变正是人们常将基础“机器人视觉”与物理AI混淆之处。传统计算机视觉是被动的。它在网球周围画上整齐的方框,以高置信度标注,然后就此停止。然而,在平坦的像素网格上找到球,并不能告诉机器人如何平衡重量、处理地板摩擦,或轻柔地将球推过地毯。
VLA模型用端到端视觉运动控制取代静态场景标注。以10–20 Hz闭环运行,网络持续协调摄像头帧与电机输出,从而针对未建模的物理障碍实现动态轨迹调整。这种流畅、非脚本化的反应,正是让合成金属与硅胶终于感觉像活生生伴侣的原因。
让AI宠物机器人真正鲜活的三大核心VLA能力
你买了一只智能机器狗,给它看一个新网球,然后说:“把红色球推到咖啡桌下面。”宠物没有玩耍,而是僵坐不动,因为“咖啡桌下的网球”从未被编程进它的系统。
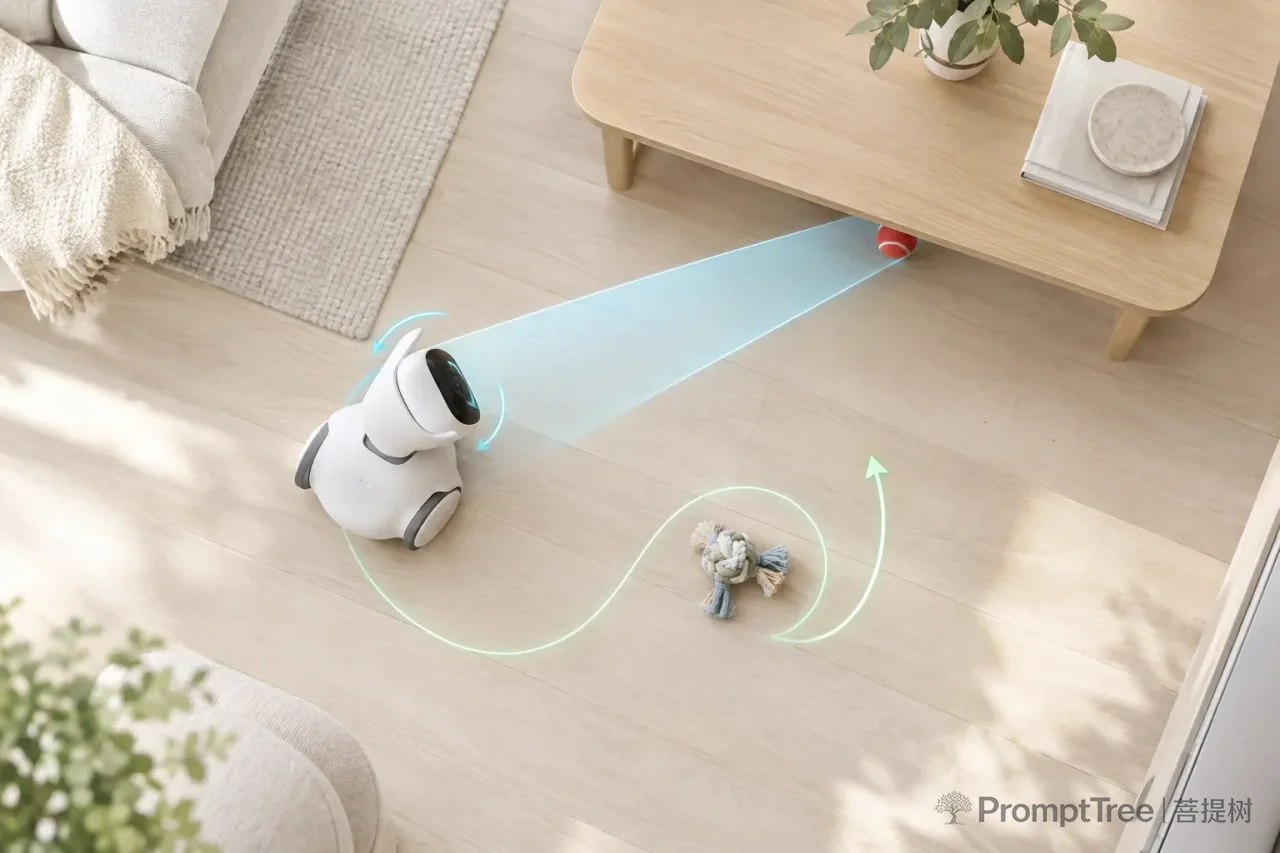
从功能性电器过渡到互动伴侣,需要三项结构性进步:
1. 零样本理解与空间推理
传统机器人宠物依赖刚性的硬编码脚本——从预先映射的环境到固定的语音触发。一旦出现代码之外的情况,系统便直接停摆。
VLA模型通过真正的零样本迁移克服这些限制。系统能在新情境中理解开放式指令,因为空间语义在多模态嵌入内部原生处理。在SpatialVLA基准测试中,这些策略在完全陌生的物理任务上达到79%的成功率——无需额外脚本或微调。
2. 动态家居中的闭环空间适应
客厅是混乱的空间。孩子们把玩具留在地毯上,家具会移动,家庭宠物会毫无预警地冲过走廊。
传统机器人依赖预先脚本化的开环运动,而VLA系统在20 Hz闭环中实现实时空间适应。这使网络能够持续更新关节角度,并无缝绕过动态障碍物。
3. 连续动作标记与微表现力
离散化、阶梯式的电机指令让动作看起来生硬且不自然。早期机器人控制循环将运动量化为粗糙的位置步进,造成僵硬的头部转动,向人脑传递“机器”信号。
VLA模型在每个自由度上输出连续的关节速度值。这种实时微表现力实现了细微、有机的物理线索:
- 对意外背景声音的轻微耳朵抖动。
- 聆听人声时轻柔的头部倾斜。
- 模仿自然姿态的平滑身体重心转移。
协调的电机控制将原始空间追踪提升为有机运动,为社交机器人奠定所需的行为基础。
克服消费级VLA硬件的边缘延迟与实时安全问题
云端引发的网络延迟直接损害伴侣机器人的感知自主性。有效的人机交互要求物理响应延迟低于200–300毫秒;超过这一阈值,平台就会被视为延迟的远程客户端,而非自主智能体。
平衡延迟:边缘与云端VLA分工
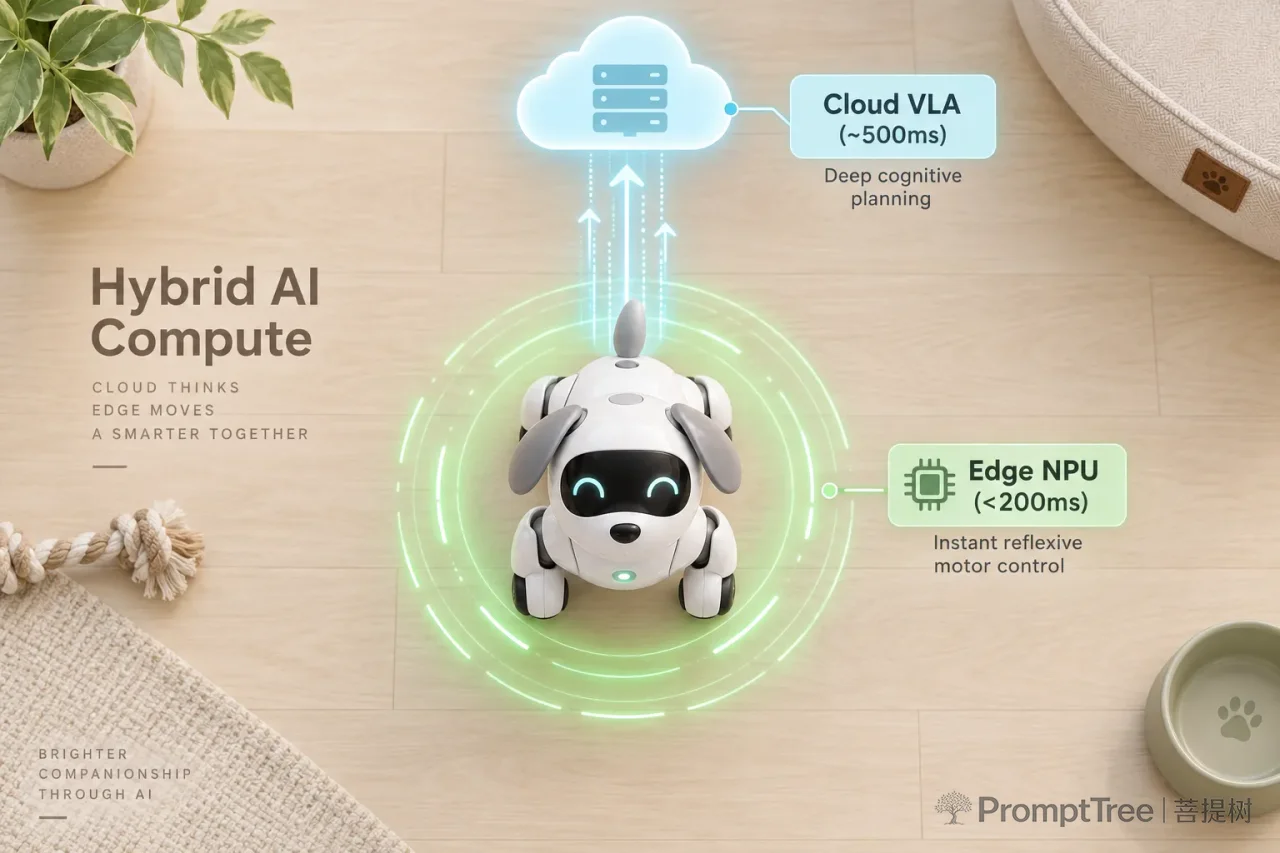
由于芯片热限制与功耗约束,在小型消费级硬件上完全运行一个庞大的数十亿参数视觉语言动作模型是不可能的。为解决这一问题,像Loona Petbot这样的物理伴侣依赖混合AI计算架构。
这种设计将高层认知推理与即时低层电机执行分离。在边缘与云端VLA流水线中,执行责任根据任务紧迫性划分:
- 云端VLA处理: 处理繁重的语义推理、多轮对话记忆与多步任务规划,500毫秒的处理窗口可以接受。
- 设备端边缘策略: 在本地神经处理单元上直接运行量化VLA模型,以保证物理运动的低于200毫秒响应时间。
实时延迟与安全控制循环
对于消费级机器人安全而言,物理控制循环不能依赖活跃的互联网连接。如果孩子踏入机器人路径,或机器人到达桌边,等待云服务器响应会导致物理跌落或碰撞。
针对SmolVLA等轻量级架构的开源机器人研究表明,8位与4位量化VLA模型如何压缩视觉动作Transformer,使其在低功耗芯片上本地运行。这使本地推理循环保持低实时延迟,将物理反应时间控制在100毫秒以内。
| 执行层 | 处理位置 | 模型架构 | 主要操作功能 | 响应延迟目标 |
|---|---|---|---|---|
| 认知规划 | 远程云服务器 | 大规模VLA Transformer | 深度指令解析、上下文意图 | 300ms至800ms |
| 反射动作 | 本地边缘处理器 | 量化VLA模型(如SmolVLA) | 即时避障、姿态平衡 | 低于200ms响应时间 |
| 安全拦截 | 板载硬件NPU | 本地确定性电机防护 | 防跌落、紧急停止 | 低于20ms |
本地反射循环让伴侣保持响应
边缘推理确保即使Wi-Fi中断,机器人宠物也能保持平衡、视线追踪与安全制动。这是一种清晰的混合分工:云端处理复杂对话AI,设备端芯片驱动瞬间物理反射。
技术评估基准:识别真正的VLA驱动机器人
在选购下一代AI宠物机器人时,买家必须区分表面级语音助手与真正的物理智能。在购买前,使用以下技术清单验证真正的VLA能力:
| 功能基准 | 传统桌面玩具 | VLA空间推理伴侣 |
|---|---|---|
| 指令处理 | 限于精确关键词触发 | 灵活、非脚本化的自然语言 |
| 表面导航 | 遇到桌面杂物即停止或碰撞 | 动态、实时空间路径规划 |
| 行为更新 | 静态、固定固件版本 | 持续的云端VLA模型训练 |
三项必备智能检查
- 多模态指令处理: 检查机器人是否能理解随意请求中的房间布局,如“把便利贴推到我的键盘那边”,而不是依赖预设语音命令。
- 环境适应性: 确保智能伴侣以10至20 Hz持续扫描视频流,绕过桌面杂物而不冻结。
- 持续OTA模型成长: 验证设备是否获得活跃更新系统支持,提供基于不断增长的真实世界交互数据训练的无线升级。
通过在低功耗芯片上实现本地推理,模型量化将桌面机器人提升为情境感知的物理智能体。基于空间感知、自适应记忆与本地处理能力评估平台,为选择长期可行的VLA硬件提供了实用框架。