产品展示
声明:文档由AI生成,仅作参考,最终产品规格及服务标准以官方为准。
一、企业概述
北京机科未来科技有限公司(RoboScience机器科学)是北京市一家具身智能技术研发企业,主营跨本体通用具身大模型研发及自主操作机器人开发,主要产品包括Visics通用具身大模型与REX G1轮式仿人形通用操作机器人,成立于2024年12月。
二、关于我们
北京机科未来科技有限公司(RoboScience机器科学)注册成立于2024年12月,2025年3月正式运营,总部位于北京市海淀区。公司由前苹果公司AI Platform技术负责人田野与新加坡国立大学计算机系助理教授邵林共同创立,联合创始人还包括前科沃斯集团副总裁刘朋海及前商汤国香资本募资负责人汪涛。
公司主营业务为跨实体通用具身智能技术研发,核心产品为自研端到端VLOA(Vision-Language-Object-Action)通用具身大模型,并基于该模型开发机器人软硬一体智能模块与整机系统。技术路线采用以物体3D点云轨迹(Object Trajectory)为中间接口的VLOA架构,将任务规划与物理执行解耦,以支持跨任务、跨物体、跨本体的泛化操作。训练数据体系依托自研高精度仿真引擎RoboMirage与全自动视频数据管线,构建“仿真+视频”双数据飞轮。
团队方面,创始人兼CEO田野本科毕业于中国科学技术大学物理学院,硕士毕业于斯坦福大学AI Lab,曾任苹果公司AI Platform技术负责人,在苹果任职期间主导开发端云协同大模型推理系统等技术平台。创始人兼首席科学家邵林为新加坡国立大学计算机系助理教授,博士毕业于斯坦福大学AI Lab,其提出的UniGrasp深度神经网络架构已成为数据驱动灵巧手抓取的基准方法之一,D(R,O) Grasp跨实体灵巧抓取框架获ICRA 2025机器人操作与运动最佳论文奖。联合创始人刘朋海曾任科沃斯集团副总裁,具有20余年新产品开发与导入经验,曾管理3000余人团队,实现50余款机器人产品量产。公司在北京、深圳、苏州、杭州设有研发和生产中心。
发展历程:
- 2024年12月:RoboScience注册成立
- 2025年3月:公司正式运营
- 2025年4月:完成数千万种子轮融资,由零一创投独家投资
- 2025年7月:完成近2亿元天使轮融资,由京东领投,招商局创投、商汤国香资本跟投
- 2025年9月:新增京东云计算关联公司等股东,注册资本增至约202.18万元
- 2026年2月:完成数亿元Pre-A轮融资,由普华资本领投,达晨财智、长石资本、香港慧科科创、天启资本跟投,老股东招商局创投、零一创投持续加码
- 2026年6月:发布Visics通用具身大模型,首次完整披露VLOA双引擎架构
- 2026年8月:发布REX G1轮式仿人形通用操作机器人
三、产品中心
| 产品名称 | 产品类别 | 核心功能/用途 | 主要规格参数 |
|---|---|---|---|
| Visics通用具身大模型 | 具身智能软件系统 | 融合具身世界模型与通用操作模型,以物体3D点云轨迹为中间接口,实现跨任务、跨物体、跨本体的机器人操作泛化能力 | 技术架构VLOA;具身世界模型基于互联网视频预训练,累积超100万小时以物体为中心的多模态操作数据集;通用操作模型基于自研物理引擎,累积10B(100亿次)全空间物体操作数据集;支持刚体、铰链体、1D/2D/3D可形变体操作;支持跨本体、闭环操作、视觉/触觉/力觉多模态感知 |
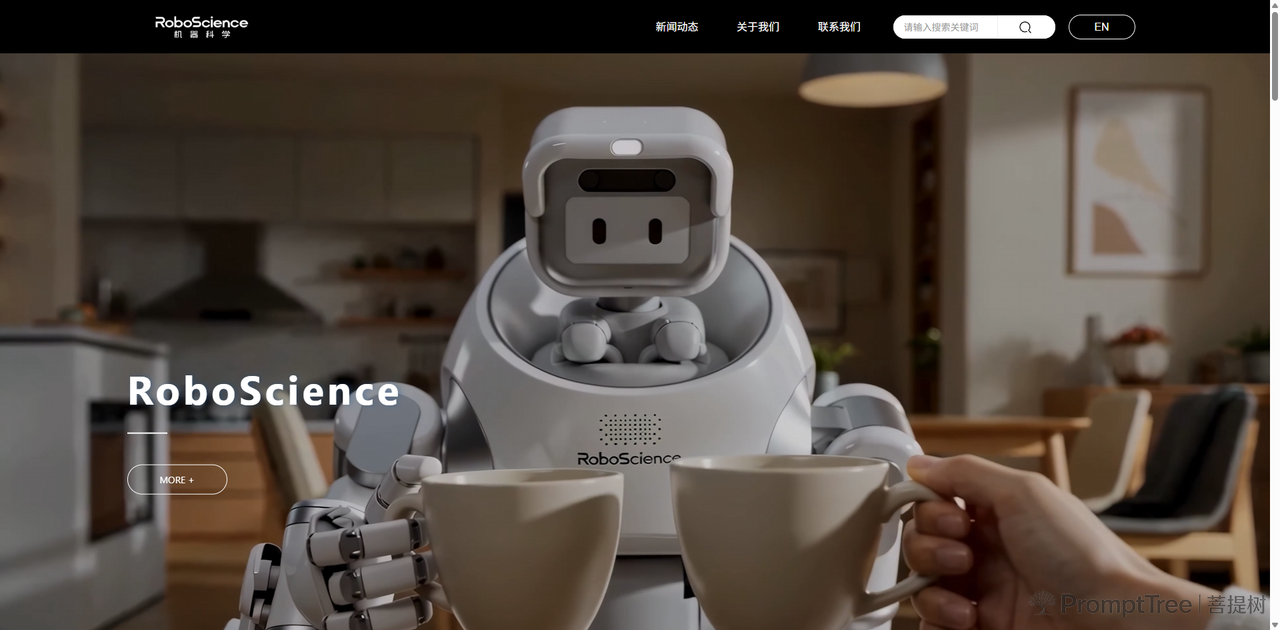
| REX G1 | 轮式仿人形通用操作机器人 | 搭载Visics大模型的通用操作机器人整机产品 | 官网未公示详细规格参数 |
重点产品说明
Visics通用具身大模型
Visics是由RoboScience机器科学自研的端到端通用具身大模型,其名称取自Vision与Physics的组合,技术架构为VLOA(Vision-Language-Object-Action)。该模型由两大核心引擎构成:
具身世界模型:接收自然语言指令与视觉图像输入,输出物体未来运动路径的3D点云轨迹。该模型具备三项核心能力:确保任务规划满足真实世界物理约束;生成多解的概率分布及对应预测置信度;实现复杂长周期任务中轨迹预测的时序与空间全局一致性。
通用操作模型:将物体轨迹转化为不同机器人本体的物理控制信号(接触点、接触力、关节控制指令),通过“物理引擎-仿真数据-端到端训练”闭环实现操作泛化与灵巧操作。支持刚体、铰链体、1D/2D/3D可形变体的操作任务,支持跨本体、闭环操作及视觉/触觉/力觉多模态感知。
数据体系:公司自研高精度仿真引擎RoboMirage,结合全自动视频数据标注与清洗管线,构建“仿真+视频”双数据飞轮,单条数据获取成本降至传统真机采集方案的1/20~1/200。截至公开发布信息,具身世界模型预训练数据集累积超100万小时以物体为中心的高维多模态操作数据,通用操作模型数据集累积10B(100亿次)全空间物体操作数据。