AI 资讯
跟踪国内外 AI 产品、模型与技术动态,按时间整理,便于快速掌握行业变化。
安徽农大|发布大豆垂直大模型「丰菽」2.0:多模型协同育种
8月16日安徽农业大学在南宁全国大豆研讨会上发布「丰菽」2.0:整合种质、组学、病害与试验等多源数据,新增多模型协同与总结模块,面向大豆数据辅助育种。
openJiuwen|蜂群升级WorkSwarm:多Agent办公协同上架鸿蒙PC
openJiuwen将蜂群智能体升级为WorkSwarm并上架鸿蒙PC应用市场,支持Windows与Mac;主打单Agent与集群双模式、共享上下文与成果接力,演示覆盖音乐创作与人机共写等场景。
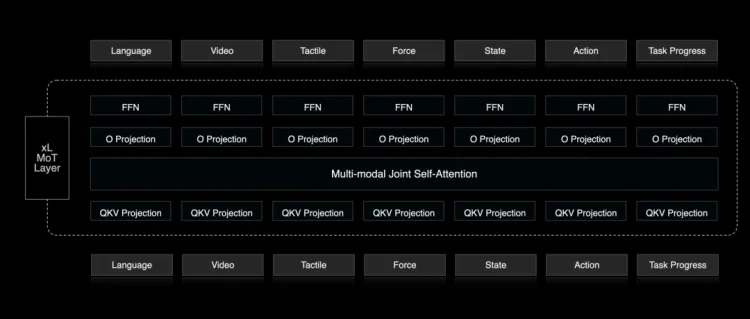
章鱼动力 SYNWorld V0.5 基模发布:一条极致 Scaling 的通用世界模型路线
2026年8月17日,章鱼动力发布面向具身智能的通用世界模型 SYNWorld V0.5,参数规模10+B,训练数据30+万小时,并公布从V0.5到V2.0的Scaling演进路线。
研究|OmniScientist:全模态AI科学家端到端论文
新国大等提出OmniScientist:感知层加构思/实验/写作三智能体,直接从异构原始证据做多学科研究;三十六例全流程出稿,均分约六点三,相对盲测变体在七个维度全面提升且八成五对照胜出。
产业观察|评估Harness揭示模型「最自信时最错」
VentureBeat刊发企业实践:定性抽检易漏「听起来对、其实错」的失败;用合成真值与排序评分的评估Harness发现,多信号重叠场景错误率最高,且模型自信与准确率可不相关。
Meta|开源Muse Glimmer-30B:面向本机Agent的多模态权重
Meta在Hugging Face发布Muse Glimmer-30B:约296亿参数稠密模型加约18亿视觉编码器,Apache 2.0可商用,面向本机Agent与工具调用;提供约四比特量化与DFlash投机解码,RTX 5090上公开测速约三点一倍加速。
Anthropic|官方详解Claude文本水印机制
Anthropic于8月14日官网详解Claude文本水印:基于SynthID-Text思路改变近义词随机源,不影响可读质量、不绑用户身份、不加价;事实与精确代码处更稀疏,并将配套C2PA与检测API。
音潮|V4.0上线并开放API,正面挑战Suno
音潮官宣音乐大模型V4.0于8月14日全平台上线,强化指令理解与场景适配,覆盖十大主流语种并向会员开放纯音乐;同步推出API平台且限时免费试用,收费规则以后续公告为准。
至知研究院|提出SWD稀疏权重分解:机制可解释性新路线
至知创新研究院等提出SWD:直接分解预训练稠密权重为稀疏因子以抽取可干预回路,匹配保真度时数据成本不到训练型基线的百分之一,并在GPT-2至Qwen3.5-27B上验证;代码与权重已开源。
通义千问|开源权重近半年全球下载超三十亿次
阿里通义称Qwen开源权重近半年全球下载超三十亿次,开源模型超四百六十个、衍生超三十万个;Hugging Face报告口径下Google约四点一八亿、Meta约二点二七亿次。叙事从单型号开源切到生态占位。