↑
Lambda采用NVIDIA硅光技术提升AI工厂的可靠性与效率
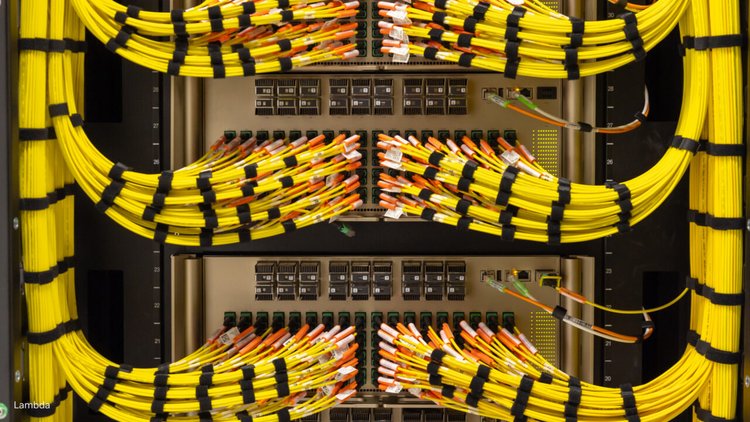
Lambda为满足大规模AI训练的网络需求,采用NVIDIA光电一体封装交换机连接超一万块GPU的机架,测试显示网络延迟降低,能效、可靠性显著提升,为AI工厂构建高效支撑。
声明:文档由AI根据原文生成。
规模化AI系统的网络需求
训练AI模型需成千上万块GPU协同工作,这就需要快速、高效且可靠的网络。Lambda作为云服务提供商,正面临大规模AI训练的网络瓶颈。
Lambda采用NVIDIA光电一体封装(CPO)交换机,将由超过一万块GPU组成的机架连接起来,为大规模AI工厂提供支撑。Lambda云服务总裁Dave Ward表示:“网络必须跟上日趋庞大的AI集群所带来的增长需求。将光电一体封装技术应用到如此规模的部署中,是构建支持新一代AI基础设施的重要一步。”
测试验证的网络性能表现
在Lambda使用这些交换机开展的测试中,机架级网络延迟降低约二十五分之一,Pod级最高降低约十分之一;机架级、扩展单元级和Pod级配置中,网络带宽性能均保持与传统可插拔光模块相同。
高能效与可靠性的技术实现
网络是AI工厂生产力的核心,大型训练任务中链路中断会导致数千块GPU停滞,推理场景的中断会引发连锁延迟,网络功耗也会占用计算资源。 NVIDIA硅光技术通过将光引擎与交换机一体封装,取代可插拔光模块,与传统模块相比,能效最高可提升5倍,可靠性最高可提升15倍,激光器数量减至四分之一,故障组件更少。
低损耗与可维护性的优化特性
Lambda部署的NVIDIA硅光交换机每台有144个端口,每端口运行速度800Gb/s,采用液冷散热;光引擎温度中值为36℃,传统可插拔光模块为51℃,信号完整性更稳定。 该技术将电气路径从数英寸缩短至数毫米,大幅减少信号损耗,省去retimer芯片,降低功耗;技术人员可现场更换光源模块,无需更换整个模块。