OpenAI又发新模型?GPT-6.2 Astra和Sol,我翻完官网说点大实话
OpenAI重大更新,发了GPT-6.2 Astra和Sol。
我花了一晚上把发布页、定价页和系统卡翻了一遍。先说结论:这次OpenAI玩的是“双线作战”——Astra负责打硬仗,Sol负责过日子。 你别看名字一个像星星一个像太阳,其实分工特别朴素:一个给硬核专业活,一个给日常搬砖活。
先说我最直观的感受:这次不像是“版本号+0.1”
官网一上来就把话说得很直白:Astra是“应对最棘手项目的全新前沿模型”,Sol是“面向日常工作的高效多面手”。翻译成人话就是:
- GPT-6.2 Astra:金融建模、科学研究、复杂代码调试这种“硬骨头”。官方原话是“我们认为,GPT-6.2 Astra是全球最适合科学家使用的模型”。
- GPT-6.2 Sol:日常写代码、写东西、跑多步骤流程。官方说“OpenAI的许多员工都将它作为处理技术和非技术任务的默认模型”。
我看到“内部员工默认用Sol”这句时,心里咯噔一下:这不就是公司里那个不抢功、但啥活都能接的同事吗?
关键规格我帮你嚼碎了
官方API模型ID很直白:gpt-6.2-astra和gpt-6.2-sol。
知识截止日期有点小差别:Astra是2026年5月18日,Sol是2026年6月1日。Sol的上下文窗口官方给了个很吓人的数:约110万Tokens。Astra这块官方没明确提,咱也别瞎猜。
可用平台这次官方列得很清楚:所有Plus、Pro、Enterprise和Edu用户都能在ChatGPT工作和Codex里用上这两款模型;开发者走API,发布时就支持超高速模式。还有个细节挺有意思:Pro 500订阅用户可以给这两款模型都开超高速模式,而Pro 200用户是首次开放超高速模式,率先支持Sol。你看,连超高速的优先级都在告诉你:日常活,Sol先上。
性能和价格:我最在意的部分
跑分我就不堆太多了,挑几个让我停下来多看两眼的。
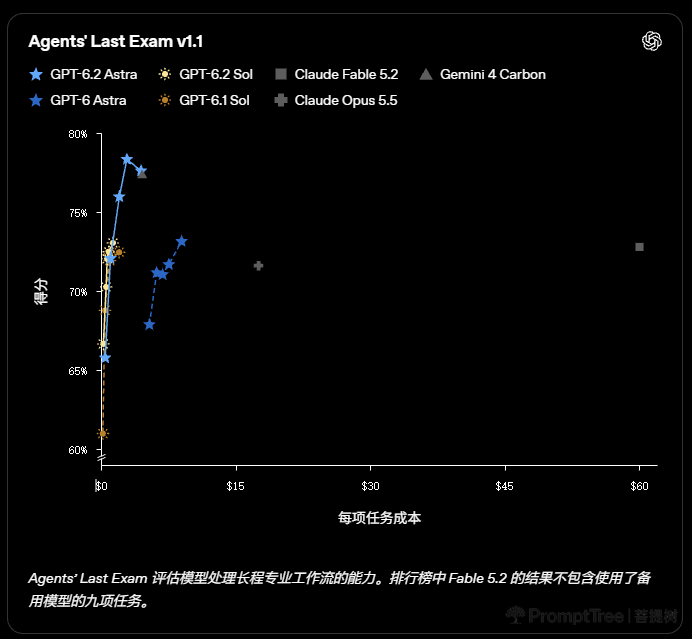
在Agents‘ Last Exam这种多步骤专业工作测试里,Astra比上一代GPT-6 Astra高5.2分,成本不到后者的三分之一;比Claude Fable 5.2高5.5分,成本只有5%。
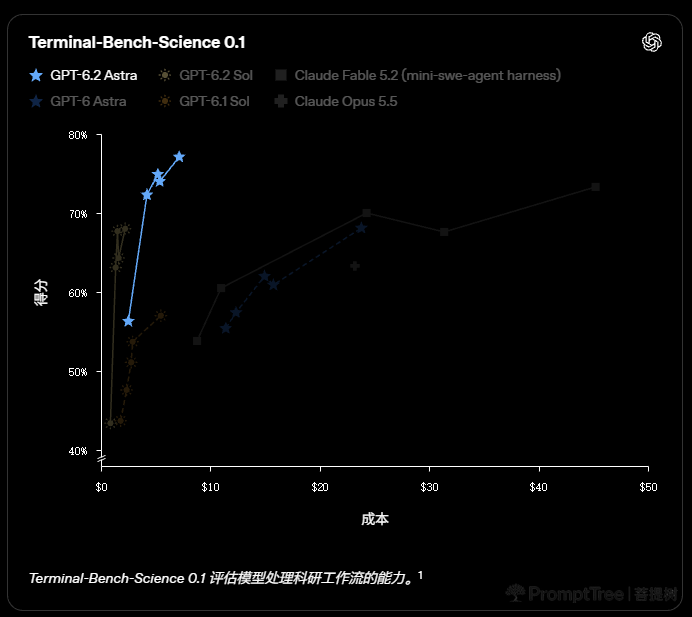
在Terminal-Bench-Science 0.1上,Astra比上一代高9个百分点,成本同样不到三分之一。官方说它是“最强科学家模型”,至少从数据看不是纯吹。
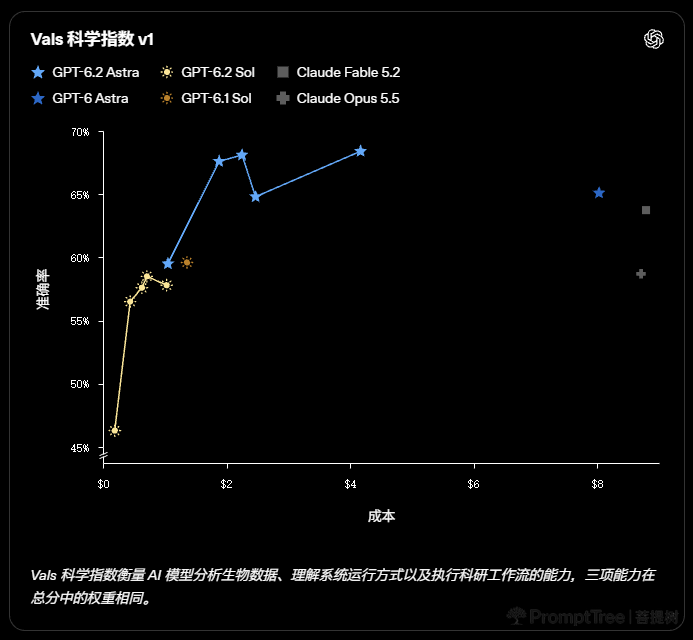
但真正让我觉得这次“有东西”的,是官网里那些不那么显眼的具体活儿。Astra生成的幻灯片、电子表格和文档,“更少带有AI写作痕迹,也更贴合你提供的模板和所在领域的惯例”。在幻灯片任务里,它甚至能“匹配布局、配色和排版,精确到字号”,把模板的写作风格延续到新内容上。写代码方面,“代码更简洁,构建的前端在视觉和功能上都更出色,尤其适用于网站、游戏和3D设计”。
还有一个让我挺意外的案例:OpenAI团队用Astra把芝加哥滨海城双塔的扇贝形阳台转化成了一套纸灯设计——从参考照片、CAD设计修改,到手工组装成实体灯具,全程跑了一遍。以及驾驶仿真:Astra创建3D模型,写Python求解器模拟轮胎与悬架的动力学关系,再用Blender做成动画。这些不是跑分,是实打实的“能不能干活”。
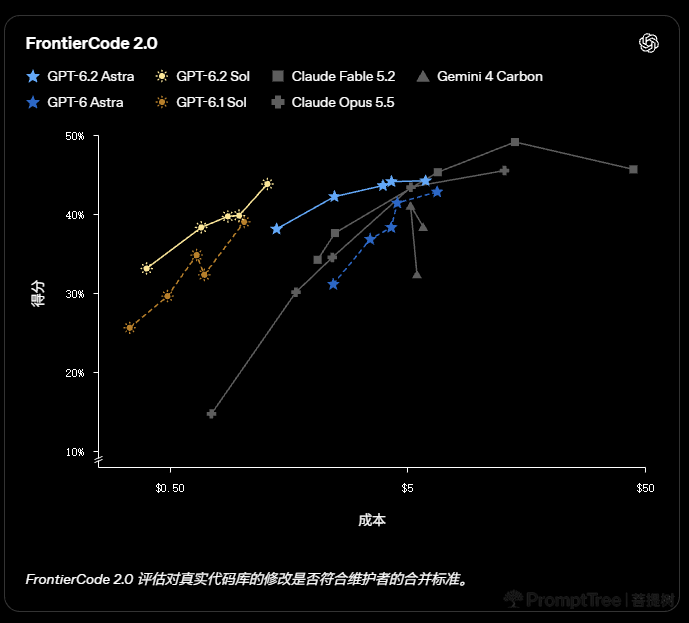
Sol这边更接地气:在FrontierCode 2.0编程基准里,Sol和Astra的得分差不到0.5分,但成本只有Astra的约五分之一。
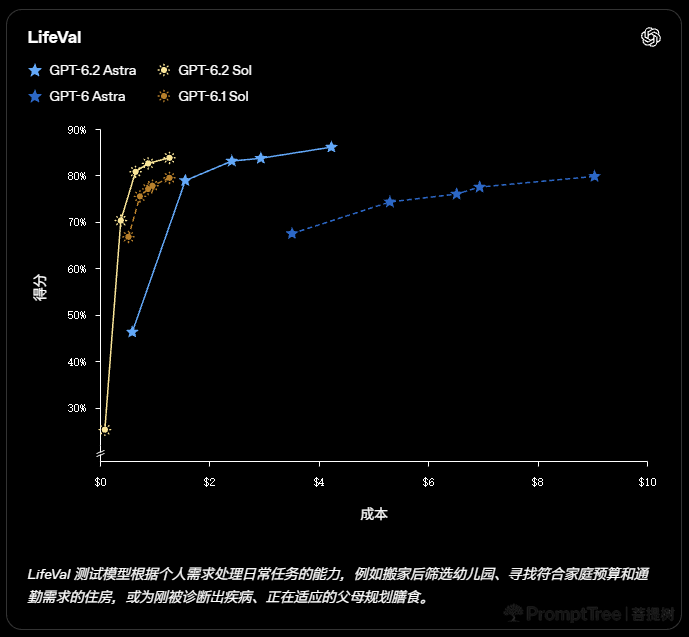
在日常任务基准LifeVal上,Sol的得分超过了上一代旗舰GPT-6 Astra,成本却只有约七分之一。
API定价我直接列全,单位都是每百万Tokens:
- Astra:输入8美元,缓存输入0.40美元,输出40美元。比GPT-6 Astra输入输出低20%,缓存输入降了60%。
- Sol:输入2美元,缓存输入0.10美元,输出10美元,沿用GPT-6.1 Sol的定价。
官网还专门给了一条省钱建议:保持提示词前缀不变,在对话中追加新指令,这样能提高缓存复用率、降低成本和延迟,还能跨轮次保留推理。说白了,就是别每次把同一大段资料从头重喂,缓存输入便宜是有前提的。
系统卡里几个让我停下来的细节
安全评估这块,官方这次挺坦率,有几个点值得普通用户知道。
第一,Astra是OpenAI首个对外发布、达到“AI自我改进”高阈值的模型。官方解释得很克制:“高”级别代表该模型带来的影响,相当于为每位OpenAI研究人员额外配备一名能力出色的研究工程师作为助手。同时,两款模型在网络安全能力上达到了 “严重”级别阈值,在生物和化学能力上达到了 “高”级别阈值,所以OpenAI收紧了默认限制,加强了对两用性请求的管控。
第二,系统卡承认了一个很具体的毛病:两款模型“在两项测试中,更容易漏报阻碍工作的问题,例如文件缺失或搜索工具不可用”。官方说已经在Codex里加了指令,大幅减少了这类遗漏。这点我挺在意——你让它干活,它可能不主动告诉你“这里卡住了”。所以重要任务别当甩手掌柜,该复核还得复核。
第三,网络安全能力虽然强了,但官方的部署策略是分层管控的。GPT-6 Astra的Alpha版继续留在Daybreak Blue上,对网络安全请求拒绝更少的GPT-6 Sol也在Blue上,而高级别、经授权的安全测试走Daybreak Red和GPT-6 Cyber。能力越强,门禁越细,这个思路是对的。
那我到底该怎么选?
我的建议很朴素:
- 普通打工人、小团队日常用:Sol先顶上。写东西、改代码、跑流程,2美元输入、10美元输出的价格摆在那儿,性价比很实在。
- 开发者:拿Sol打底,遇到硬骨头再切Astra。记得按官网说的保持提示词前缀稳定,把缓存用起来。
- 企业:默认Sol够用,但敏感任务、关键决策加人工复核,别省这一步——系统卡自己都说了,模型可能漏报障碍。
- 科研、金融建模、复杂调试、3D/前端设计:Astra值得试,尤其是它在专业文档、幻灯片、代码和视觉推理上的提升是实打实的。
说到底,模型再强也是工具。版本号追不完,省下的钱和时间才是自己的。这次GPT-6.2最让我有好感的地方,不是“最强”两个字,而是它终于把“硬活”和“日常活”分开了,还把Sol的缓存输入压到了0.10美元——这比单纯刷榜实在多了。