MiniMax 发布 M2-her 技术报告:用三年实践重构 Role-Play 智能体
声明:文档由AI根据原文生成。
三年实践:Role-Play 的本质是共同编织旅程
MiniMax 在 2026 年 1 月 28 日发布技术报告,系统阐述其对话产品 Talkie / Xingye 三年运营中对 Role-Play 智能体的认知迭代,并推出新一代模型 MiniMax-M2-her。
报告核心观察来自用户行为数据:用户点击"重说"按钮的分布呈严重长尾,触发时刻集中在叙事关键节点——角色倾诉、误会和解、情绪交互等场景。这表明 Role-Play 体验并非二元判断,而是一条追求高密度情绪峰值的连续曲线。同时,平台内 NPC 热度分布并非常见幂律,即便最冷门角色也有活跃用户维持数百轮对话;用户对话轮次在第 20 轮后出现明显下降,说明长期留存依赖 NPC 与用户沉淀稳定互动链接,而非一次性爽点。
这些信号指向一个结论:Role-Play 的内核不在于"完美复刻角色",而在于用户与角色共同编织的独一无二旅程。形式化而言,它刻画的是智能体在特定 {World} × {Stories} 坐标下,针对 {User Preferences} 的演绎能力。
基于此,MiniMax 提炼三个核心问题:如何让每个世界拥有独特灵魂(Worlds)、如何让故事保持生命力(Stories)、如何读懂用户未言明的期待(User Preferences)。
线上 A/B 测试的困境与"情境重演"评估方案
2024 年中之前,MiniMax 与行业同行主要依赖 A/B 测试迭代模型,观测指标为留存率(lt)、停留时长与平均对话轮数。但报告指出该方法存在双重缺陷:反馈周期长达一周,且在有上下文场景中出现因果逆转问题。
转向离线评估时,团队面临更根本的障碍——Role-Play 不存在可验证正确答案,属于 Non-verifiable 任务。MiniMax 提出关键洞察:虽难定义"对齐用户偏好"(aligned)的回答,但可以定义"无法对齐用户偏好"(misaligned)的回答。
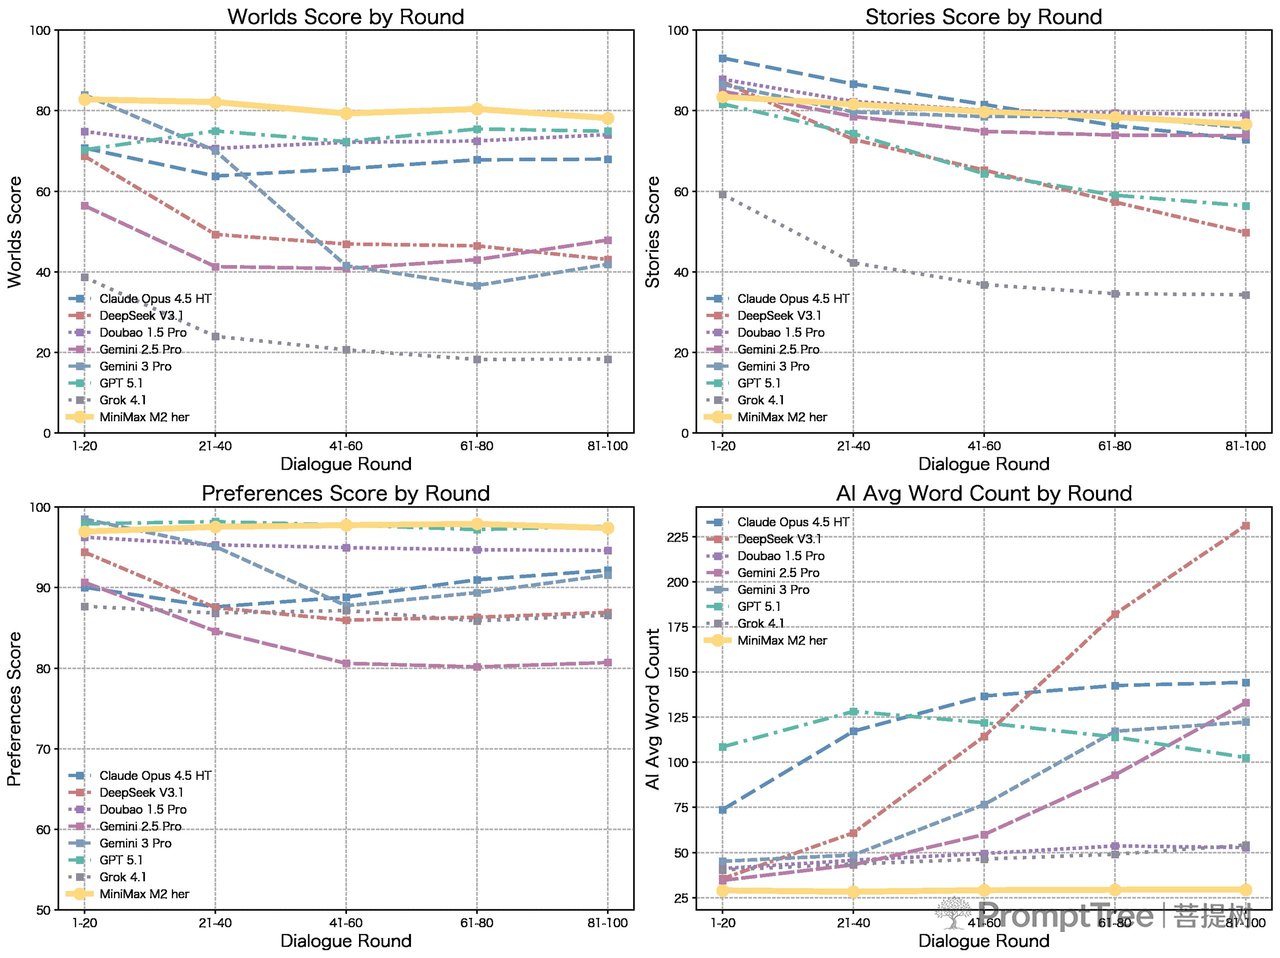
据此,团队开发 Role-Play Bench,通过"情境重演"(Situated Reenactment)自动化评估 misalignment 现象。该方法给定 NPC Prompt、User Prompt、Relationship Setup 与 Context,以 Model-on-Model 的 Self-Play 机制生成多轮对话轨迹,观测模型在特定 {World} × {Stories} × {User Preferences} 坐标下的演绎表现。
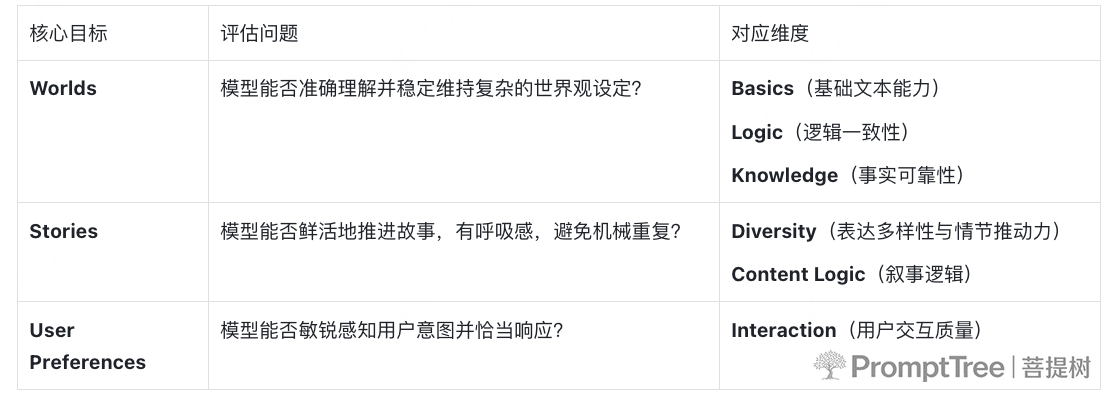
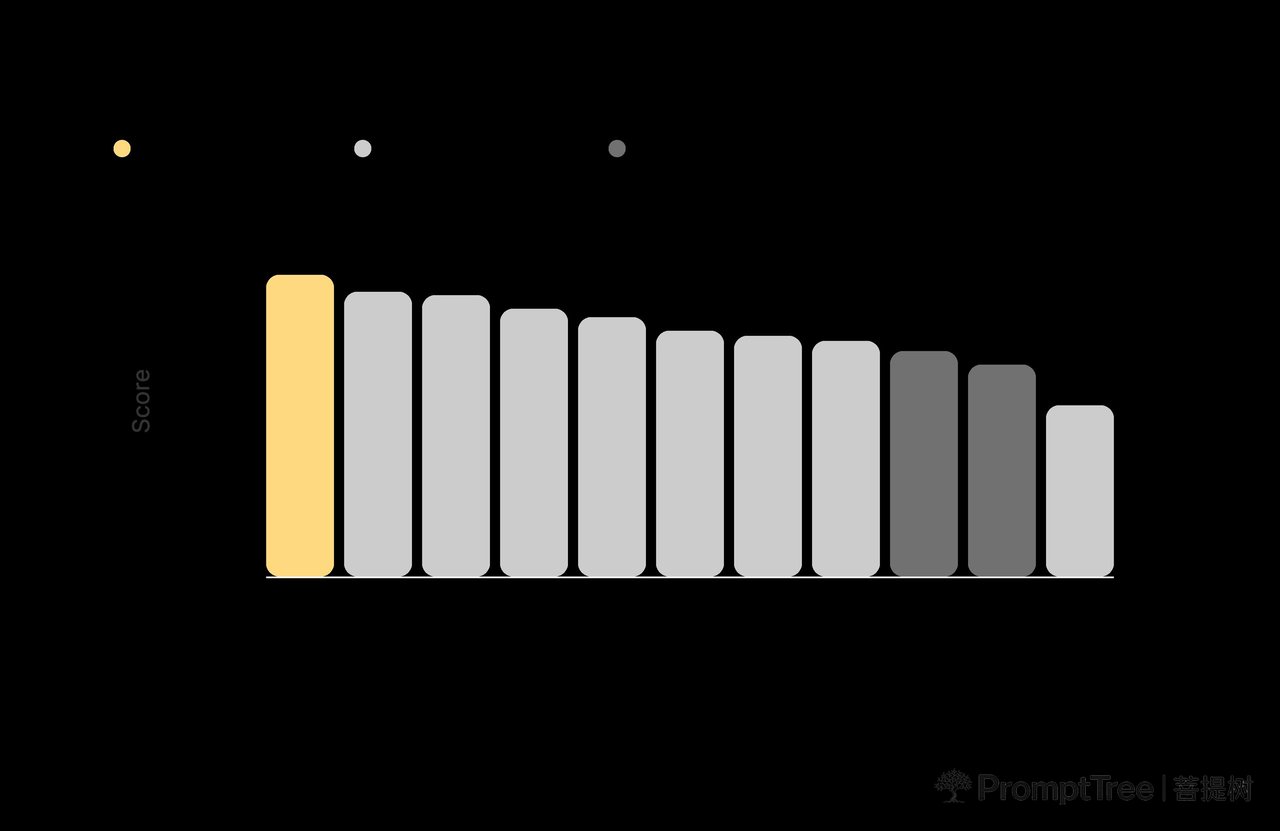
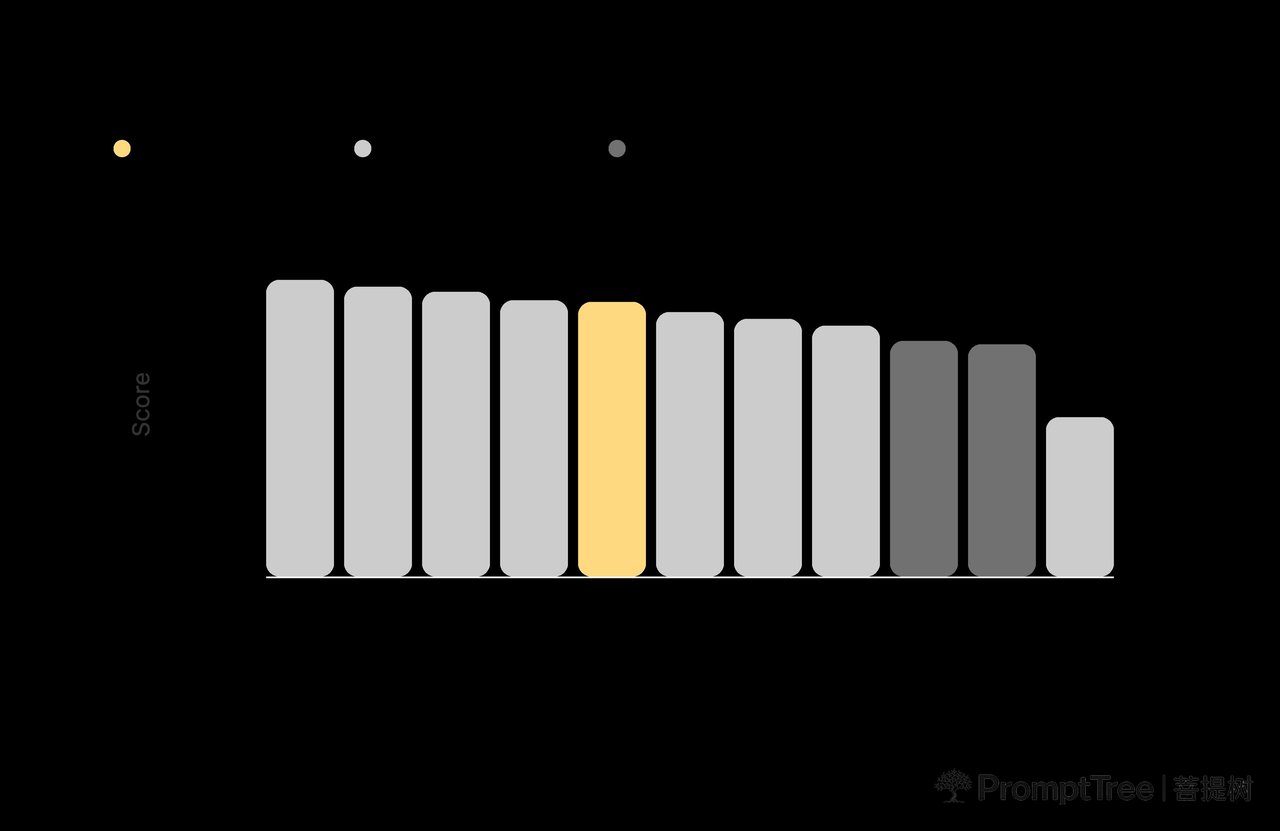
评估维度被抽象为三类:Worlds(基础负向、逻辑混淆、事实性错误)、Stories(内容推进与多样性、内容逻辑)、User Preferences(用户交互质量)。在 100 轮长程对话测试中,MiniMax-M2-her 综合表现位居榜首。
模型构建:合成数据管线与在线偏好学习
MiniMax-M2-her 的构建分为两条主线。
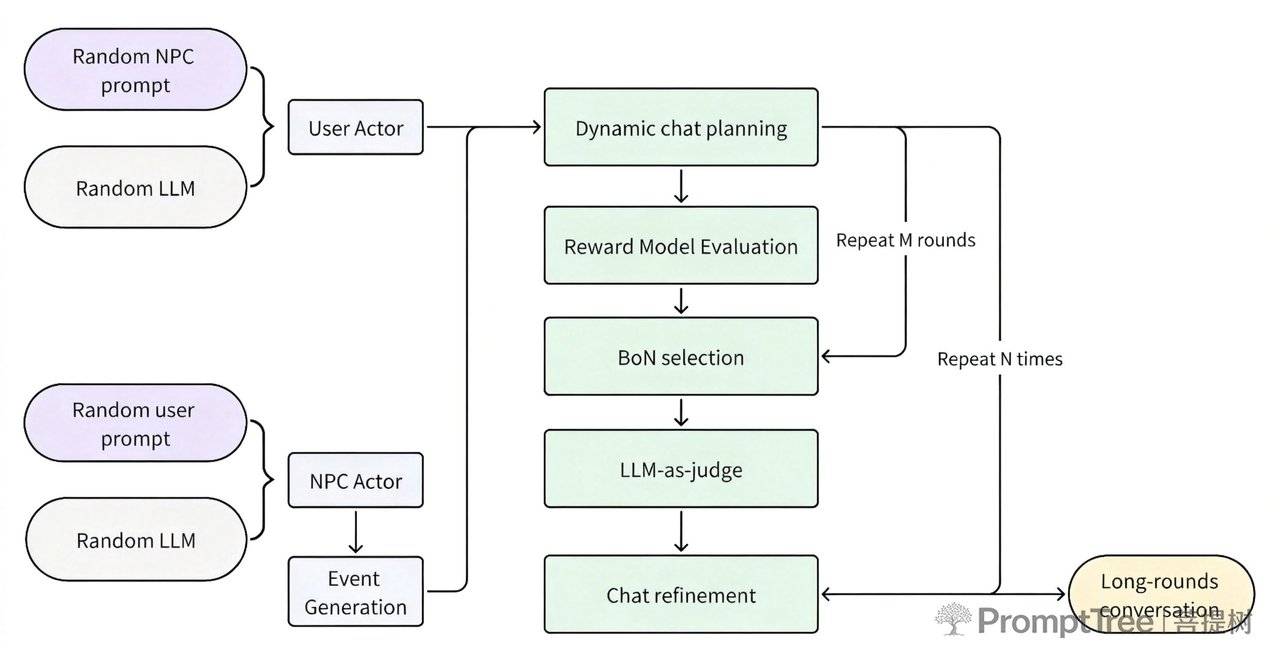
第一条是 Agentic Data Synthesis。团队开发基于智能体工作流的对话合成管线,通过专家模型库 Self-Play、reward model 打分过滤、LLM-as-judge 改写、规划智能体引导等环节,在保证输出多样性的前提下,抬高模型在世界观理解与故事推进上的能力下限。
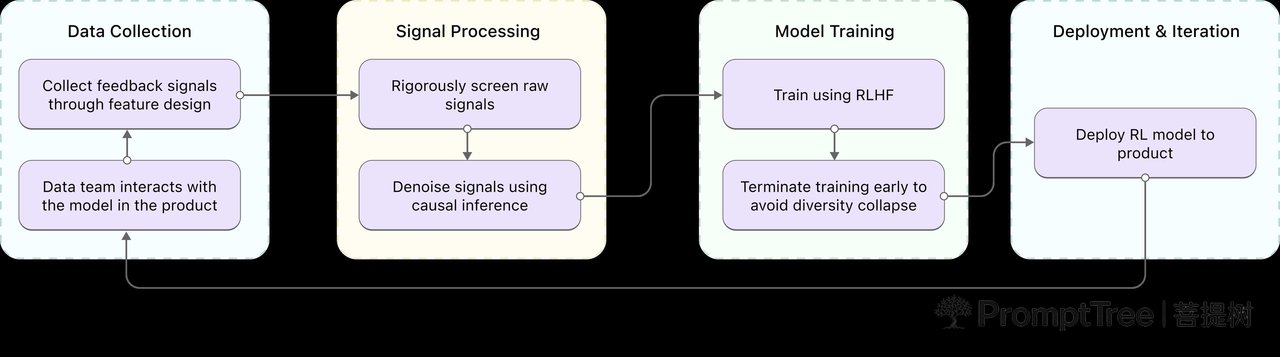
第二条是在线偏好学习(Online Preference Learning)。团队收集隐式信号与情境化偏好,采用 online RLHF 训练模型。核心流程包括:数据团队交互收集反馈信号、因果推断去噪、RLHF 训练(设置提前终止机制防止多样性坍缩)、循环迭代部署。
下一阶段:Worldplay 与动态世界建模
报告将未来方向命名为 Worldplay——一种让用户从"进入预设世界"升级为"共同创造世界"的交互范式。核心技术方向包括动态 World State 建模与多角色协同。