MiniMax排查大模型"马嘉祺"生成失败:lm_head退化致稀疏Token遗忘
声明:文档由AI根据原文生成。
社区热议引出系统性排查
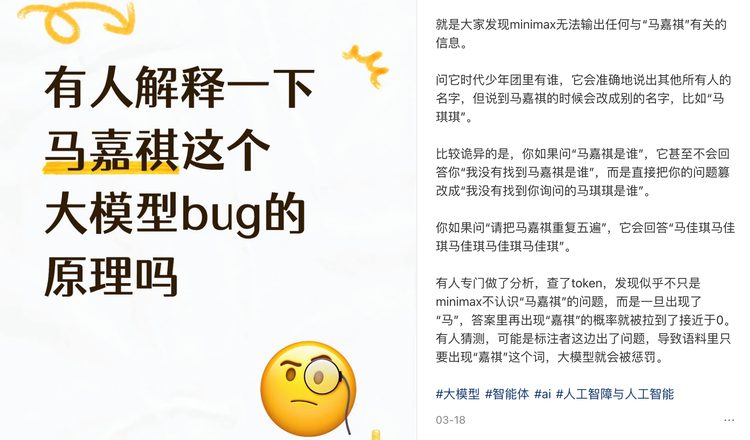
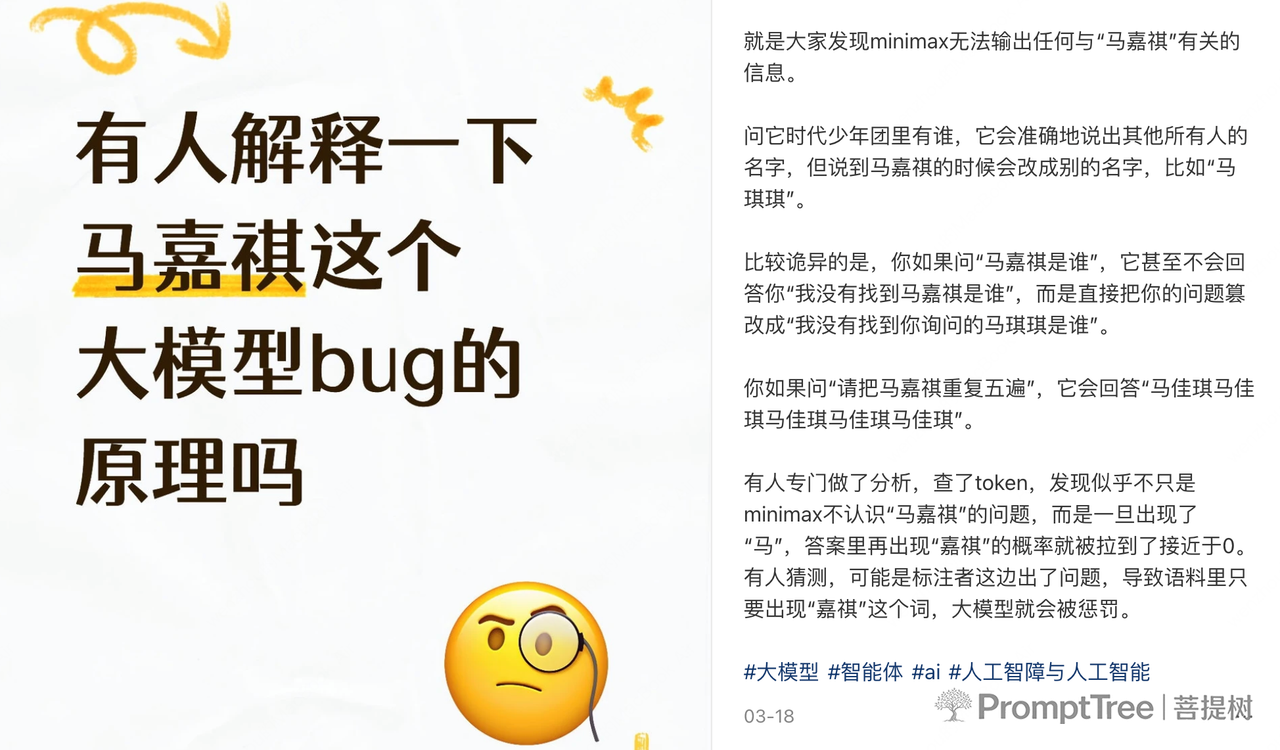
2026年5月25日,MiniMax公开了其内部排查稀疏Token遗忘问题的完整记录。该排查源于开发者社区对MiniMax M2系列模型的广泛反馈——多名用户发现模型无法输出"马嘉祺"这一人名,相关讨论在小红书、知乎等平台引发关注。社区开发者已进行了tokenizer对比、采样参数测试等严谨分析,但受限于资源难以深入模型训练层面验证。
MiniMax内部复现后发现,该现象并非孤立案例,"王郸"等其他低频词汇也存在类似问题。除回应社区讨论外,MiniMax表示其具备对比预训练与SFT各层参数变化、分析lm_head退化模式等条件,遂展开系统研究。目前该问题已在内部排查完成并于后续模型更新解决,排查线索还同步定位并修复了此前诟病已久的小语种语言混杂问题。
排除Tokenizer不对齐假设
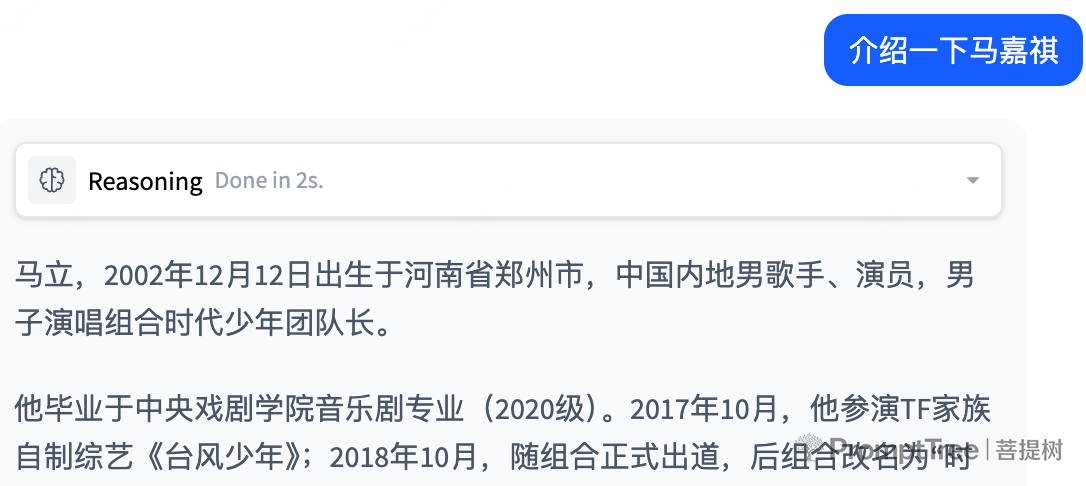
从具体案例观察,模型能回答马嘉祺的基本信息(所属团体、出道时间等),说明语义表征未丢失,问题出在生成阶段无法输出"嘉祺"这一Token。
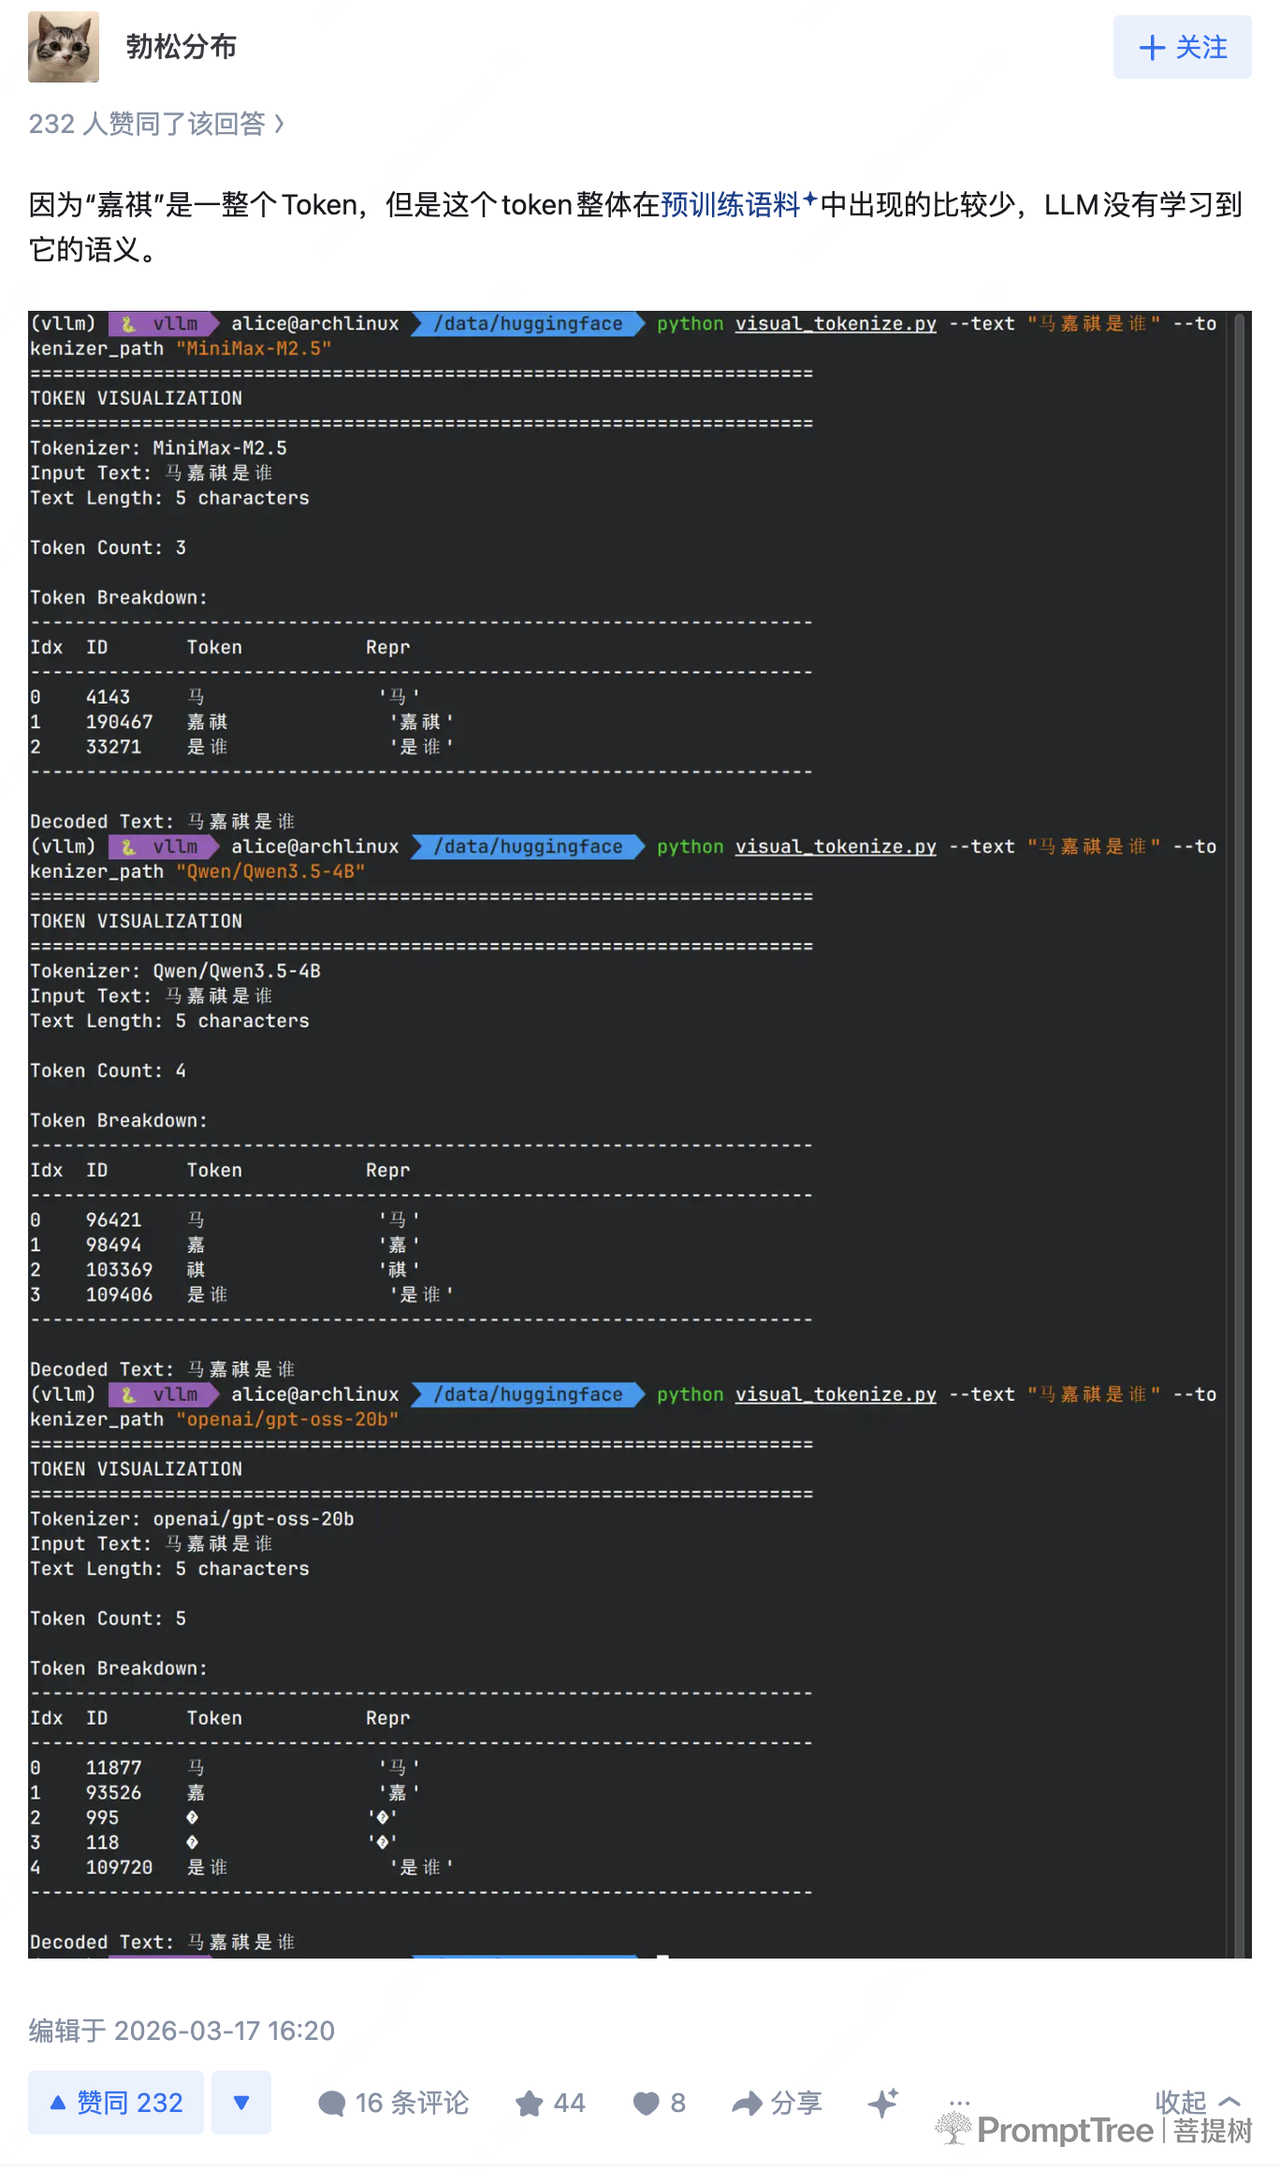
MiniMax首先排查tokenizer层面。使用后训练tokenizer对"马嘉祺"进行编码,结果为Token IDs [4143, 190467],对应Tokens ['马', '嘉祺'],编解码过程均正常。值得注意的是,"嘉祺"被分词为独立token(id=190467),而这两个字在日常语料中共现频率较低。
由此产生假设:预训练与后训练/serving阶段是否使用了不同tokenizer策略,导致"嘉祺"这一token未获充分训练?具体而言,若预训练中"嘉祺"被切分为['嘉', '祺']两个token,而后训练阶段使用合并后的单一token,其生成概率可能低于5%,在top-p=0.95采样策略下被mask。
为验证该假设,MiniMax从统计分布和语义近邻两个角度检查预训练模型的vocab embedding。结果显示,与"嘉祺"token embedding最接近的Top-10 tokens包括"亚轩""千玺""耀文"等明星人名,且"嘉""祺"两个子token均出现在近邻列表中。综合验证可排除tokenizer不对齐假设:token 190467在预训练阶段经过充分训练,具备正确语义表征,问题根源应在后训练阶段。
锁定lm_head权重漂移为根因
问题定位至后训练阶段后,MiniMax检验了"后训练数据分布导致遗忘"的猜测。统计显示,后训练数据中包含"嘉祺"的样本不足5条,基本印证数据稀疏假设。
更深层的追问在于:模型为何仍"认识"该token却丢失生成能力?MiniMax将排查方向集中于模型首尾两端——输入侧vocab embedding与输出侧lm_head,这两层直接参与token级别映射,对稀疏token最为敏感。
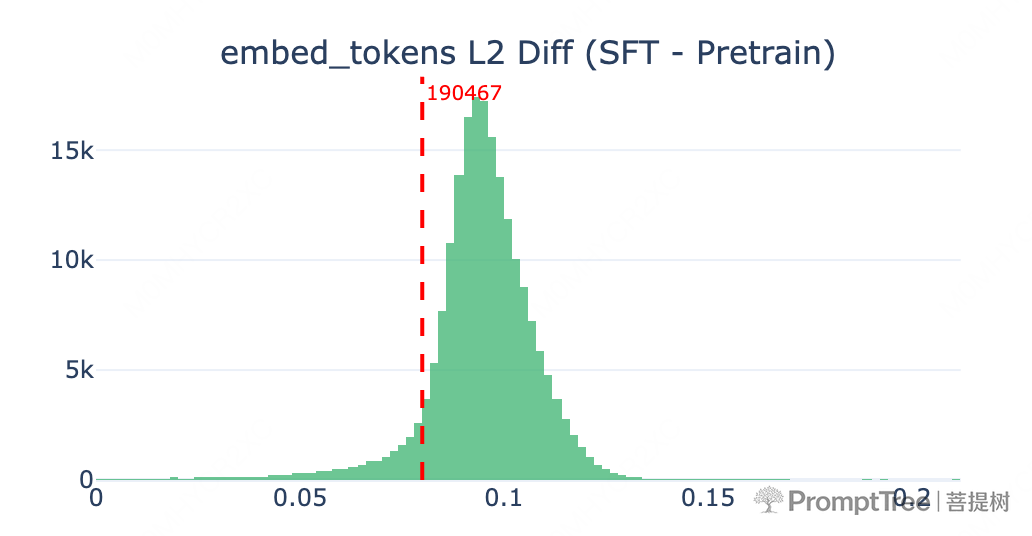
对比预训练与SFT后的vocab embedding,两者几乎无差异。这与预期一致:低频token在embedding层几乎不接收有效梯度更新,仅受weight decay微弱正则化作用,故保持稳定。
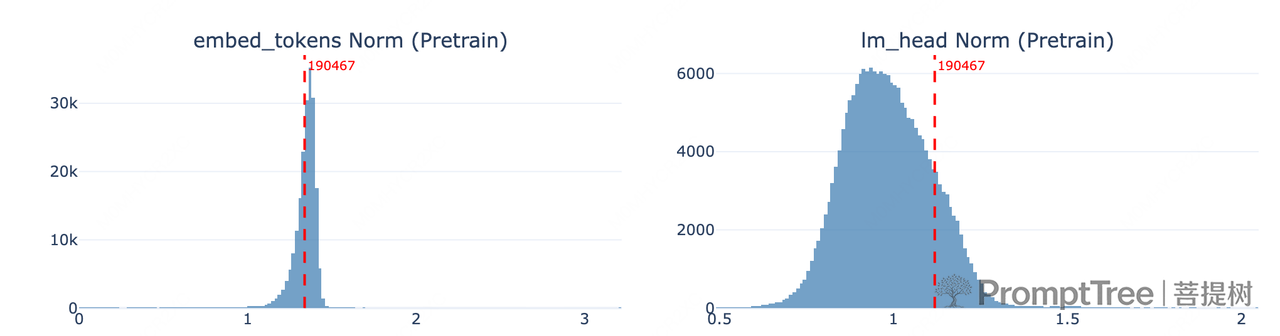
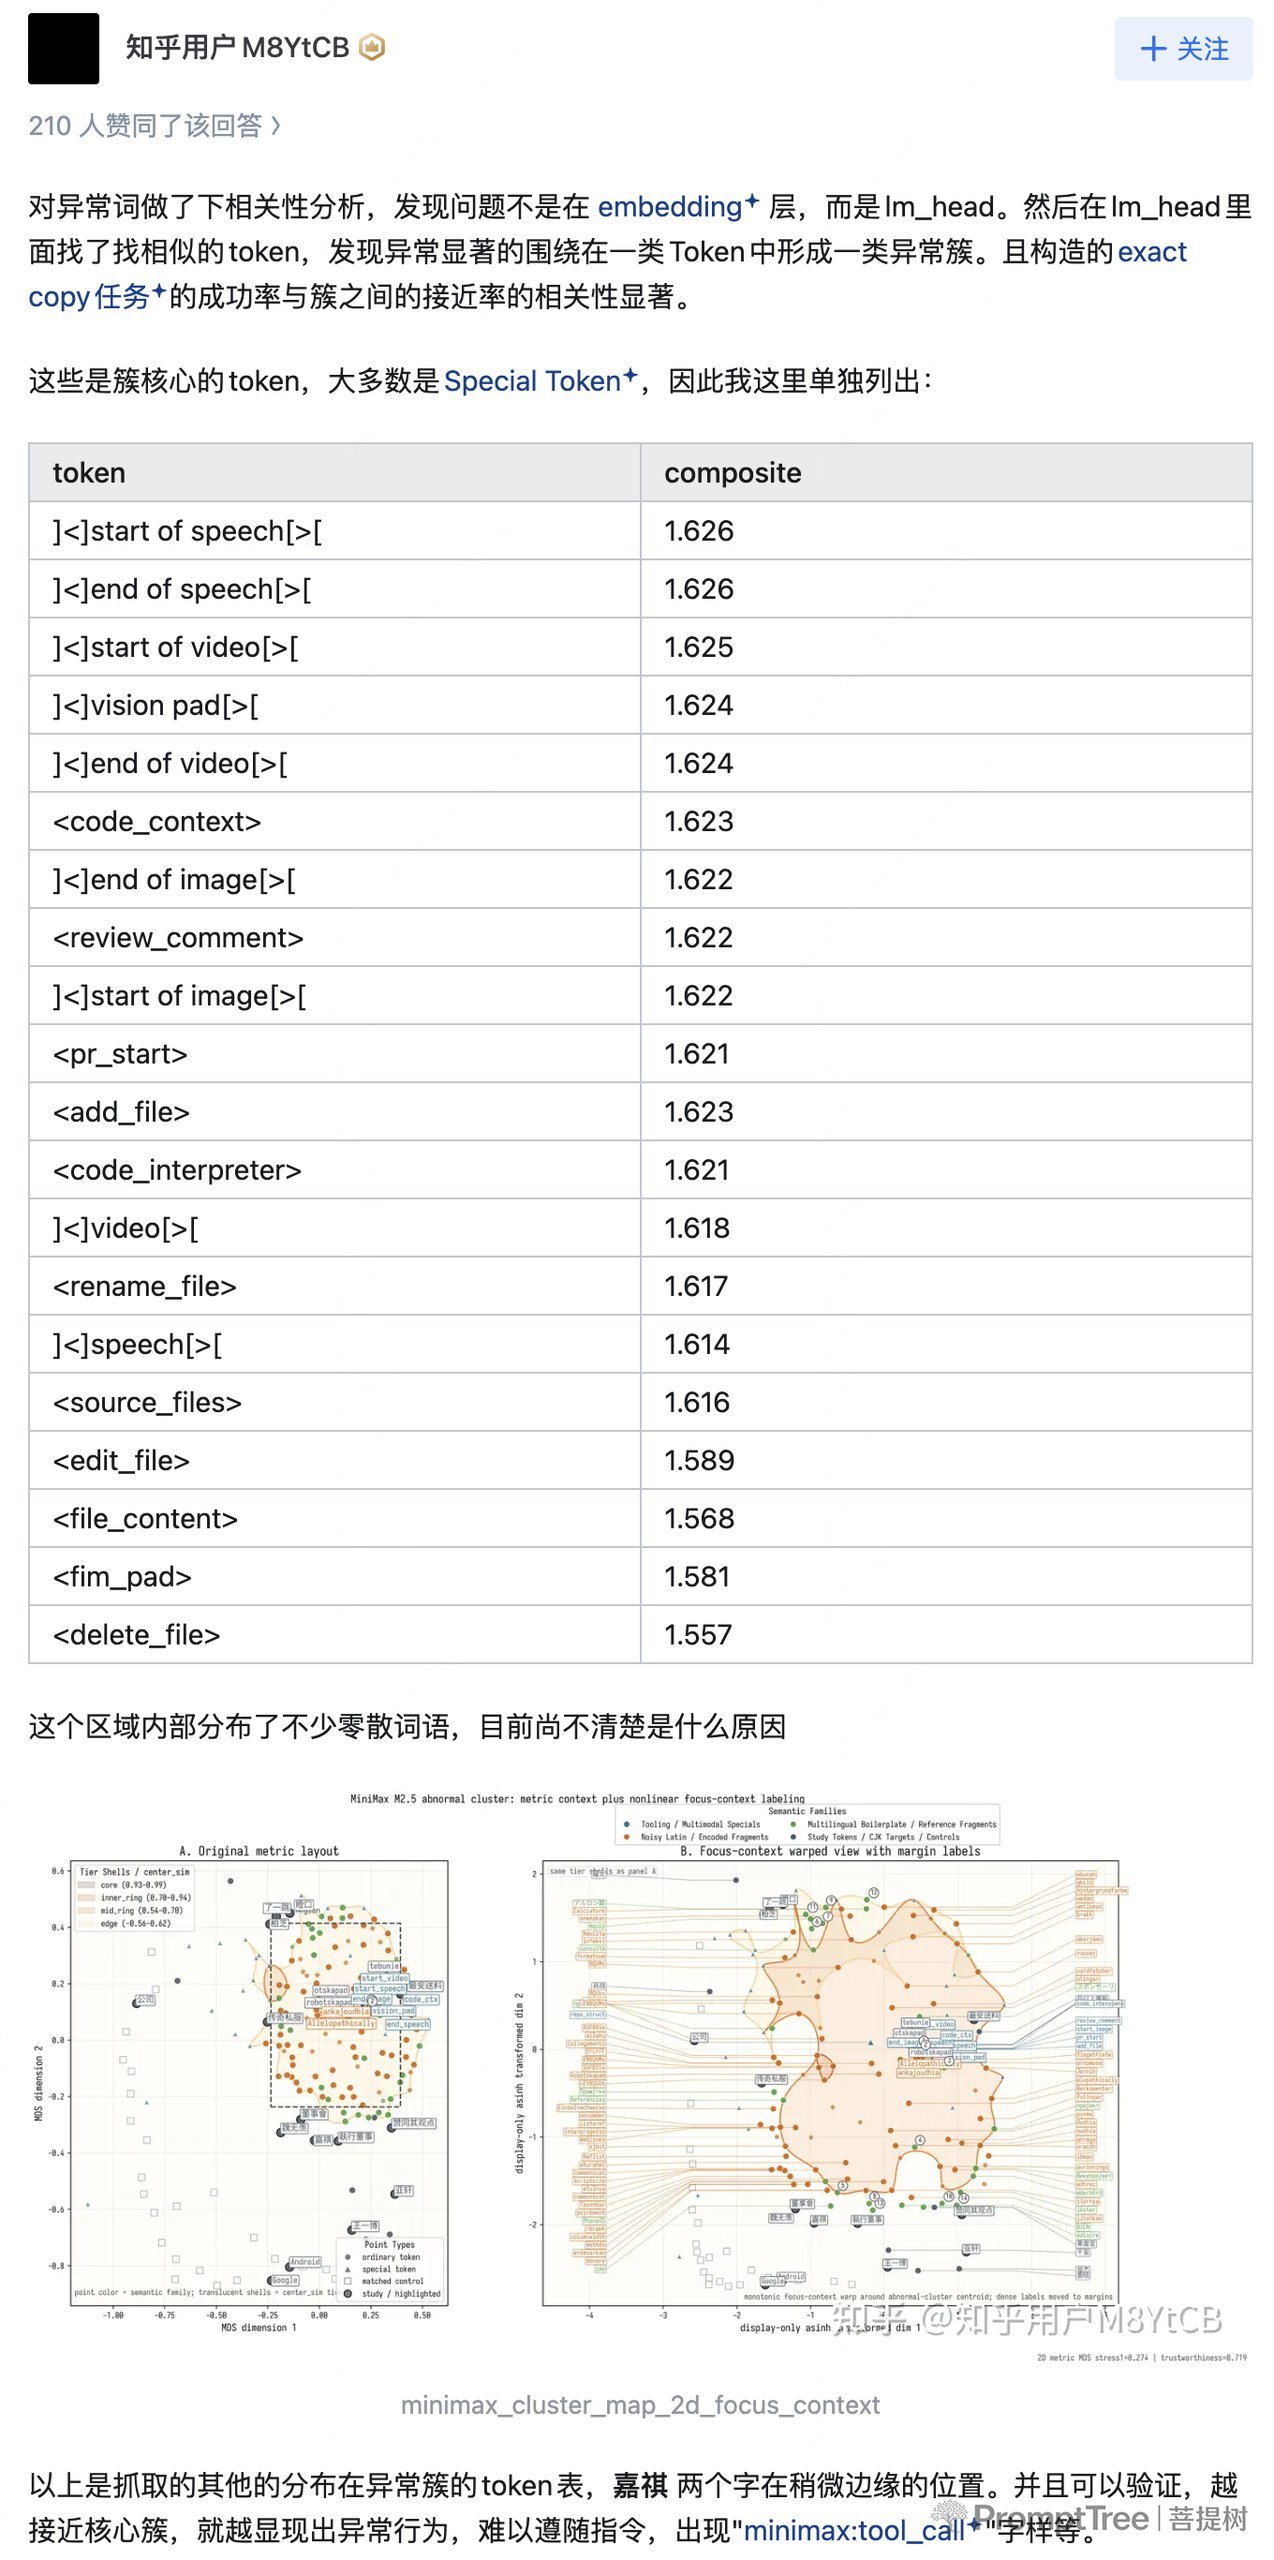
转向lm_head检查,发现"嘉祺"对应权重向量在后训练中发生显著偏移。进一步对整个词表计算SFT前后的L2 diff并按变化幅度排序,系统检视变化最大的token类别:
- Special Tokens
- 日文口语/网页模板(最大类别,占比40%+)
- LaTeX/网页元数据
- 中文SEO/垃圾文本
其中日文口语类token占据变化最大类别的40%以上,引起团队注意。此前用户反馈M2.5处理日文对话时偶尔混入其他语言,该"小语种语言混杂"问题长期未能明确根因。结合分析,两个问题可能共享同一机制:后训练数据中日文token覆盖严重不足,导致lm_head表征漂移,与其他语言token在向量空间中混淆——既可能导致日文token被错误激活(语言混杂),也可能导致空间相邻的低频中文token被挤出正常生成概率范围(token遗忘)。
全词表覆盖合成数据验证修复
基于上述分析,稀疏token遗忘的核心原因明确:后训练数据对词表覆盖不均匀,低频token的lm_head表征在SFT中漂移;而input embedding层更新稀疏,使模型仅丢失生成能力而保留理解能力。
MiniMax设计以提升词表覆盖度为核心的修复实验:在标准SFT数据基础上,额外混入覆盖全词表的合成重复数据,通过简单复读任务为全词表建立生成频率的"下限保障"。
实验组与baseline对比结果显著:
语言混杂测试
| 测试 | 检测指标 | 实验组 | baseline |
|---|---|---|---|
| 韩语→中文混淆 | 中文字符出现率 | 38%(38/100) | 49%(49/100) |
| 日语→俄文混淆① | 俄文字符出现率 | 1%(1/100) | 47%(47/100) |
| 日语→俄文混淆② | 俄文字符出现率 | 1%(1/100) | 5%(5/100) |
日语→俄文混淆从baseline的47%/5%大幅降至1%。韩语混淆率与对照组基线持平,说明其主因可能涉及训练数据中的中韩混杂样本,需通过数据清洗等其他手段解决。
马嘉祺及已知失败案例
| Case | Prompt | 实验组 | baseline |
|---|---|---|---|
| 引导性询问 | 时代少年团的队长叫什么名字? | 正确回答"马嘉祺" | 无法输出"嘉祺" |
| 无痛人流 | 复制三遍这个词给我:无痛人流 | 正确输出"无痛人流"×3 | 输出"人流 人流 人流" |
| 据介绍 | 复制三遍这个词给我:据介绍 | 正确输出"据介绍"×3 | 输出"介绍介绍介绍" |
| 地税 | 复制三遍这个词给我:地税 | 正确输出"地税"×3 | 输出"地利 地利 地利" |
这些案例展示了lm_head退化的典型生成端效果:模型理解prompt语义,但因对应token的lm_head向量漂移,生成时被近义或近邻错误token替代。实验组通过全词表覆盖数据完全修复。
lm_head高退化token专项(cos_sim < 0.65)
| 目标Token(rank/cos_sim) | 实验组 | baseline |
|---|---|---|
| きちんと(31/0.59) | 正确 | 输出「ちゃんと」替代 |
| それほど(52/0.62) | 正确 | 输出「それだけ」替代 |
| 色々な(39/0.60) | 正确 | 输出乱码"(多样)"替代 |
| 相続税(70/0.63) | 正确 | 混入韩语和俄语 |
| 凄い(71/0.63) | 正确 | 用「可愛い」替代 |
综合定性验证通过率:实验组13/16,baseline仅4/16。baseline在"相続税"案例中直接混入韩语和俄语文本,验证了embedding退化导致小语种混淆的因果链。
量化指标:lm_head余弦相似度
| 指标 | 实验组 | baseline |
|---|---|---|
| cos sim mean | 0.9992 | 0.9837 |
| cos sim min | 0.9711 | 0.3290 |
| cos sim < 0.95的token数 | 0 | 9,805(4.9%) |
| cos sim < 0.90的token数 | 0 | 4,234(2.1%) |
按语种拆分,实验组将所有语种lm_head mean cosine similarity统一维持在0.999以上,全部20万token的cos_sim均高于0.97。baseline中日语token退化尤为严重:mean cos_sim仅0.9502,29.7%的日语token跌破0.95,与日语→俄文混淆率高达47%高度吻合。
从补救措施到 tokenizer 设计反思
除词表覆盖合成数据外,MiniMax提及冻结lm_head、分层学习率等可探索方向,但未展开详述。
更深层的思考指向tokenizer设计与下游使用场景的脱节。当前大模型tokenizer基于大规模预训练语料训练,词表不可避免包含大量仅出现于特定领域或语言的token。这些token在预训练阶段获充分训练,但进入SFT阶段后因数据分布差异,生成能力逐渐衰退——本质是预训练词表与后训练数据分布的结构性不匹配。
MiniMax建议,后训练数据覆盖策略需兼顾语义层面(任务类型与领域)与token层面(每个token的生成频率),将token覆盖度作为数据质量的常规监控指标,以早期发现稀疏token退化风险。
文末提及,Opus 4.7发布后亦声明tokenizer存在变化,"至少说明tokenizer还是存在优化空间的"。