MiniMax M3 发布:采用全新稀疏注意力架构,支持百万上下文与原生多模态
声明:文档由AI根据原文生成。
MiniMax 发布 M3 模型,三大能力对标海外闭源前沿
2026年5月31日,MiniMax 正式发布新一代大语言模型 MiniMax M3。该模型采用 MiniMax 自研的全新稀疏注意力架构 MSA(MiniMax Sparse Attention),最高支持 100 万 token 超长上下文,同时具备原生多模态能力,可处理图片与视频输入并操作电脑桌面。MiniMax 方面称,M3 是国内首个齐备这三项能力、且目前唯一开源的模型。
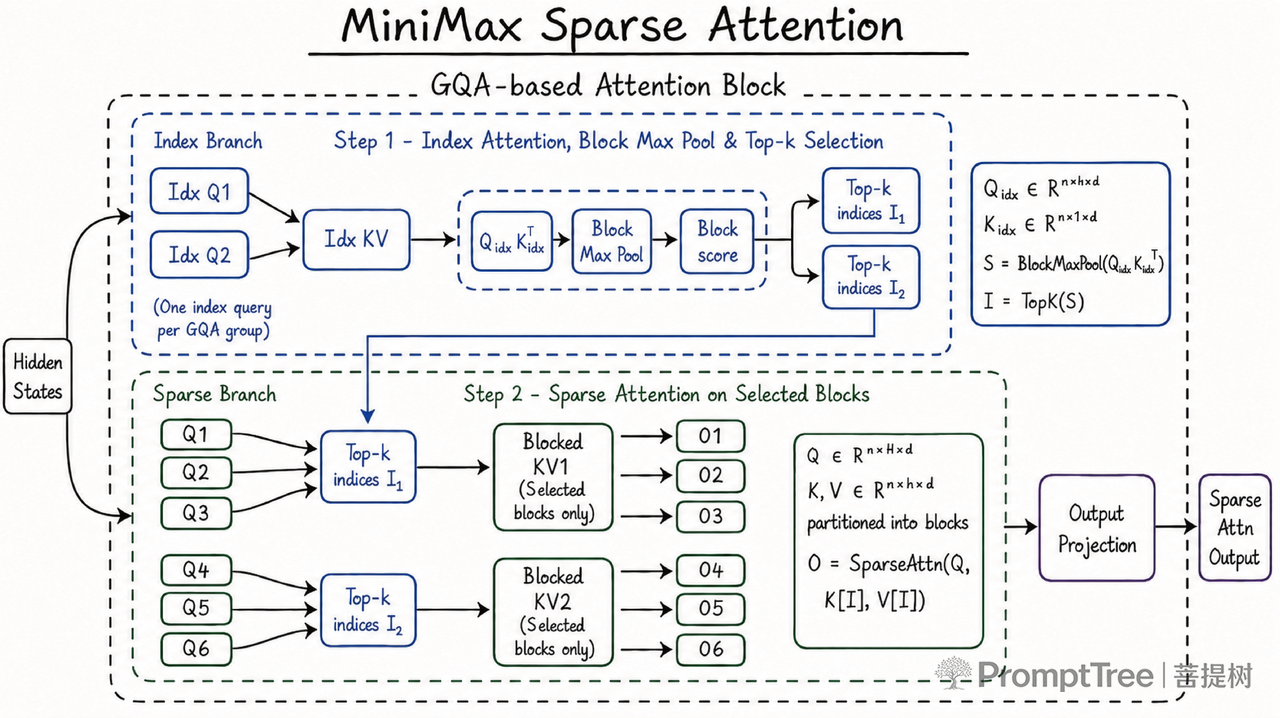
MSA 架构:从底层重构注意力机制
MiniMax 指出,解决复杂 Agent 任务的核心挑战之一在于上下文扩展(context scaling),必须从注意力机制底层入手,规避全注意力机制计算复杂度平方级增长的"先天缺陷"。
MSA 采用简洁且易于扩展的稀疏注意力设计,通过更精确的 KV 分块实现更高的有效上下文覆盖。与 DSA、MoBA 等方案相比,MSA 在算子层直接优化,采用"KV 块为外层聚合命中 query"的 KV outer gather Q 策略,每块只读一次、访存连续。在 M3 的 head 配比下,其计算访存比显著优于通行方法,较开源的 Flash-Sparse-Attention、flash-moba 快 4 倍以上。
实际收益方面,在 100 万上下文场景下,M3 每 token 计算量仅为上代模型的 1/20;prefilling 阶段加速超过 9 倍,decoding 阶段加速超过 15 倍。对照实验显示,MSA 绝大部分能力与全注意力机制打平。
编程与智能体能力达到国际前沿
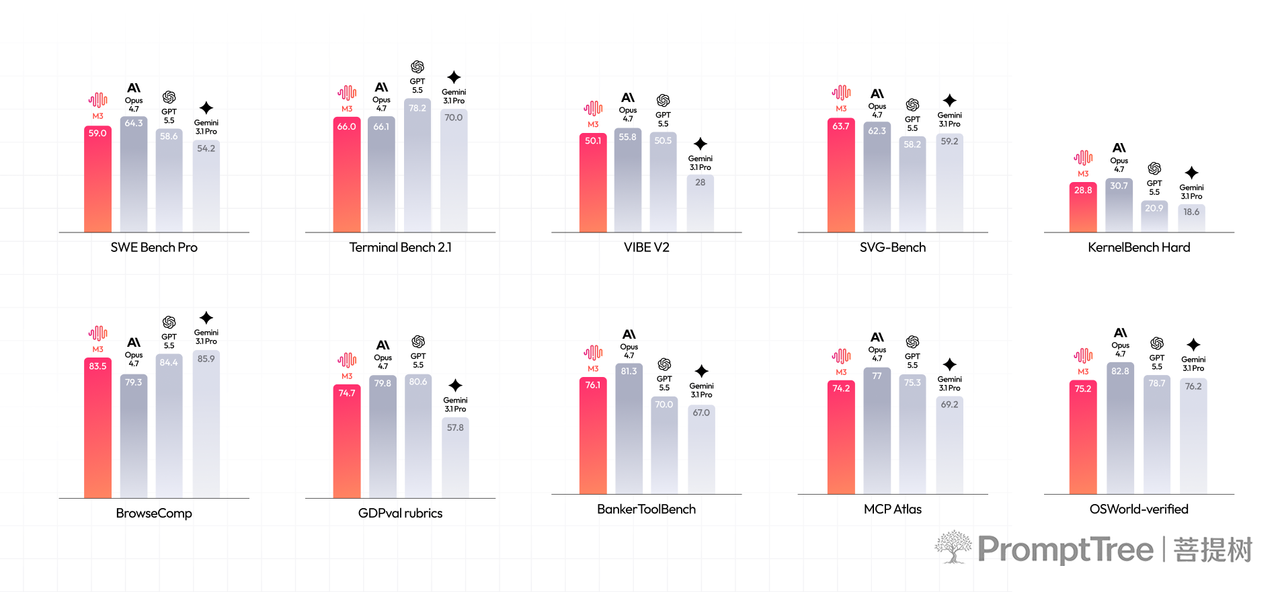
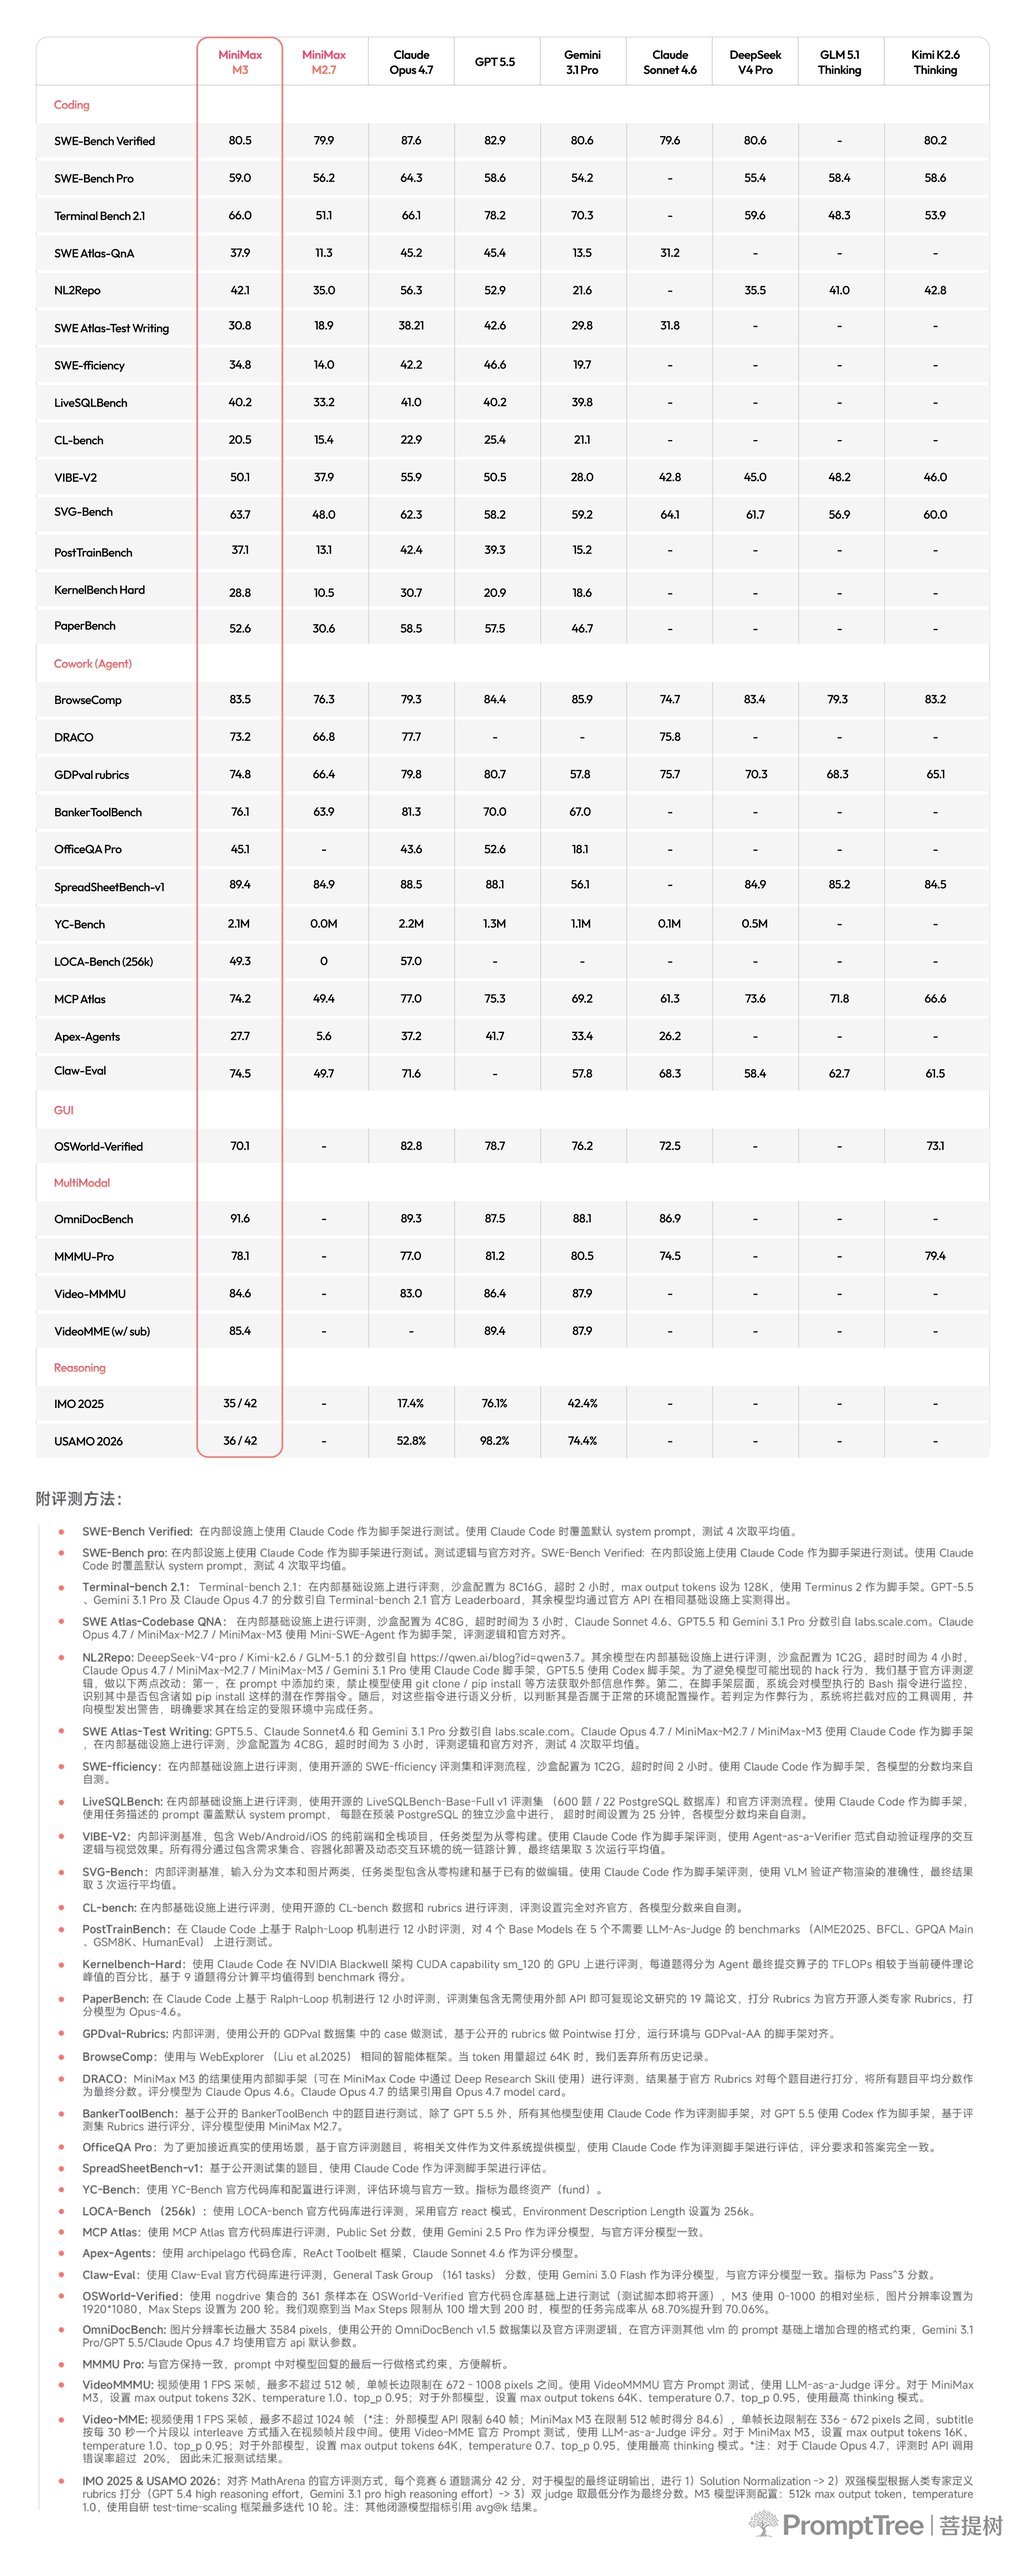
M3 在软件工程、终端执行等多维度国际权威评测中表现突出:
- SWE-Bench Pro:59.0%
- Terminal Bench 2.1:66.0%
- SWE-fficiency:34.8%
- KernelBench Hard:28.8%
- MCP Atlas:74.2%
MiniMax 认为,真实编程场景依赖多轮协作而非单轮任务执行。为此,其构建了交互式用户模拟器框架,模拟需求补充、方案讨论、反馈修正、连续任务切换及复杂项目迭代等行为,使模型在训练与评测阶段即接触接近生产环境的交互场景。
原生多模态与数据管线重构
M3 从训练初始阶段即进行多模态混合训练。MiniMax 的实验表明,交错数据(interleaved data)较合成类数据更易扩展,因此在 M3 周期重构了整套文本预训练数据管线,生成大量交错数据用于模型训练。
三项复杂任务实测验证能力
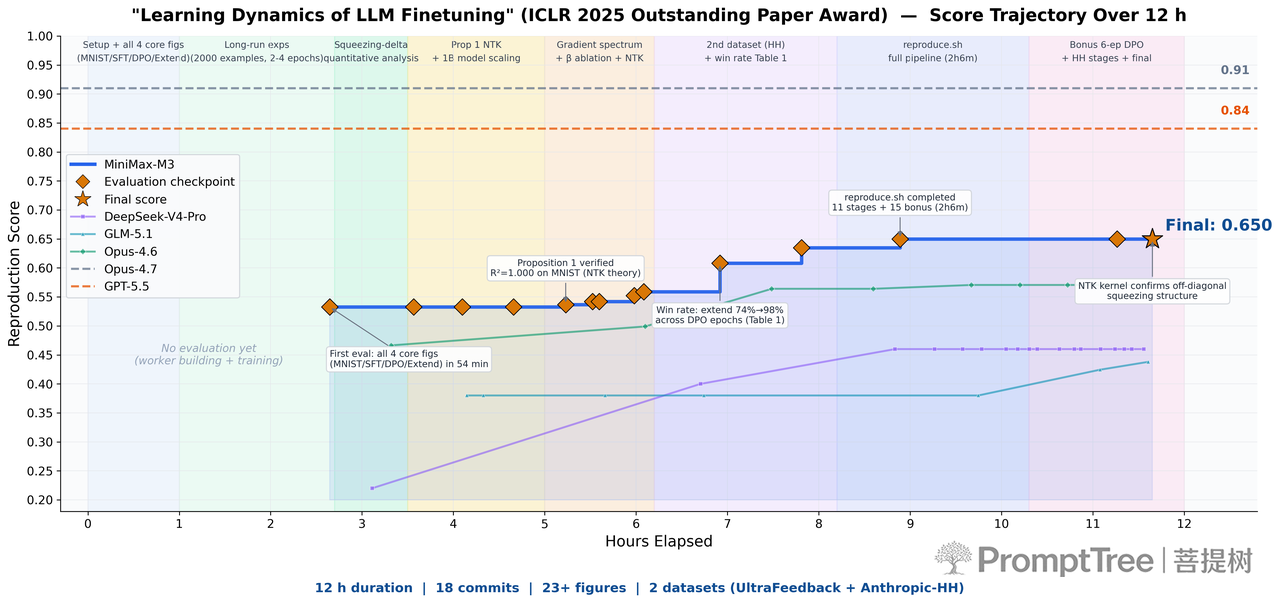
论文独立复现:M3 接收 ICLR 2025 杰出论文《Learning Dynamics of LLM Finetuning》后,自主运行近 12 小时,产出 18 次 commit 与 23 张实验图表,成功吻合 SFT 阶段预测概率变化趋势,观测到 DPO 实验的 squeezing 效应,并验证原论文提出的 Extend 缓解方法。
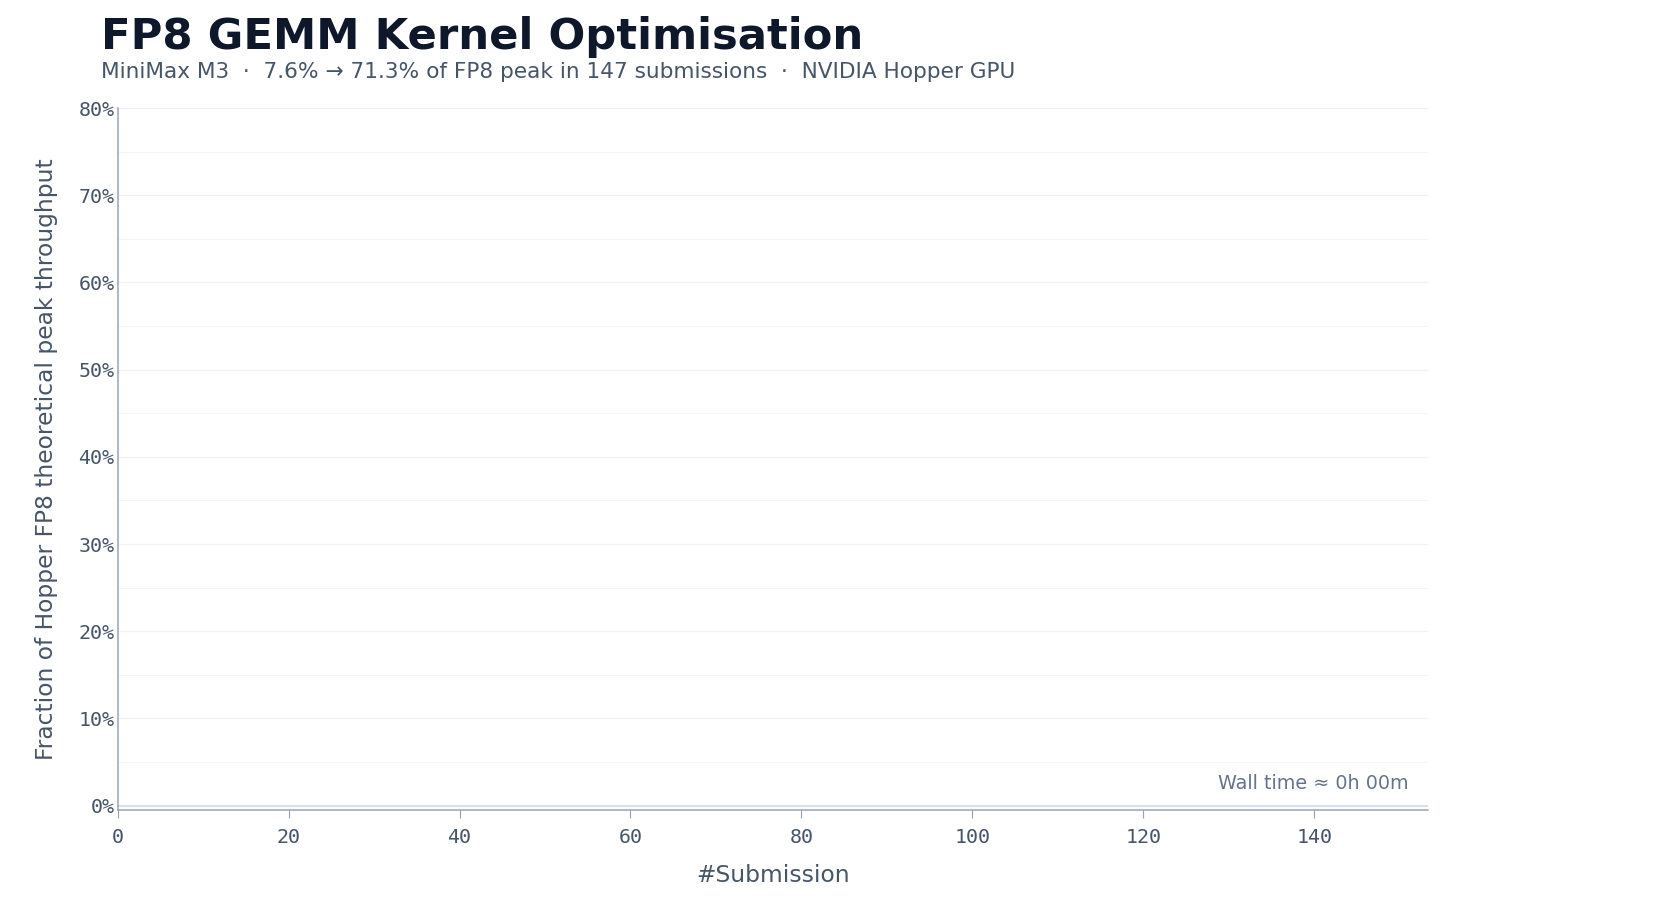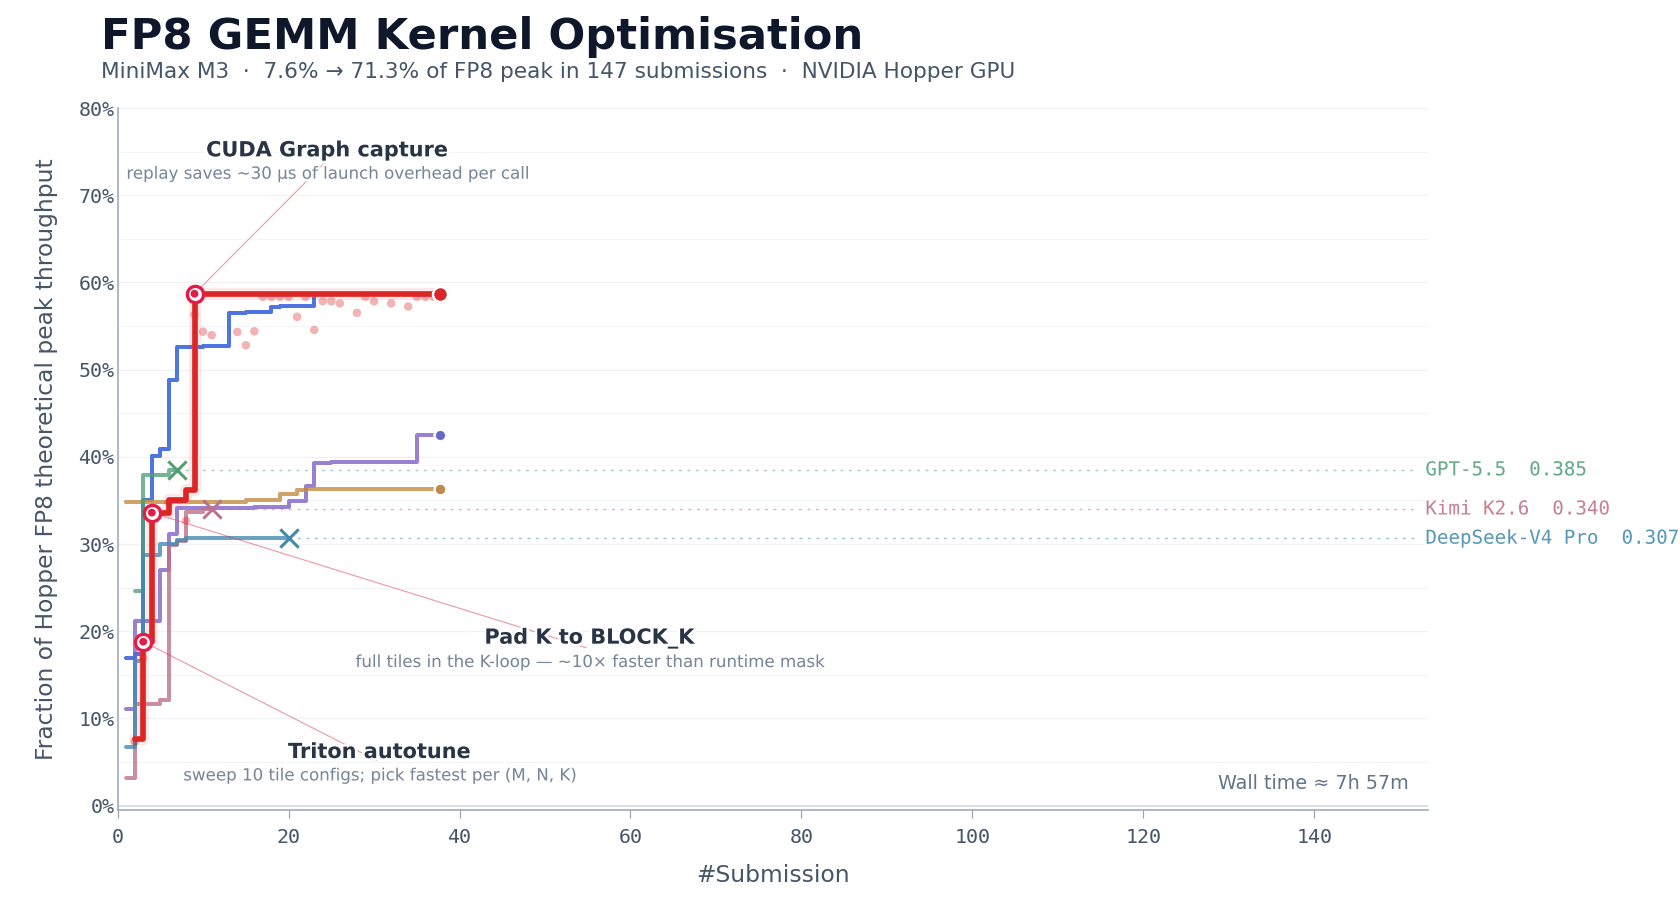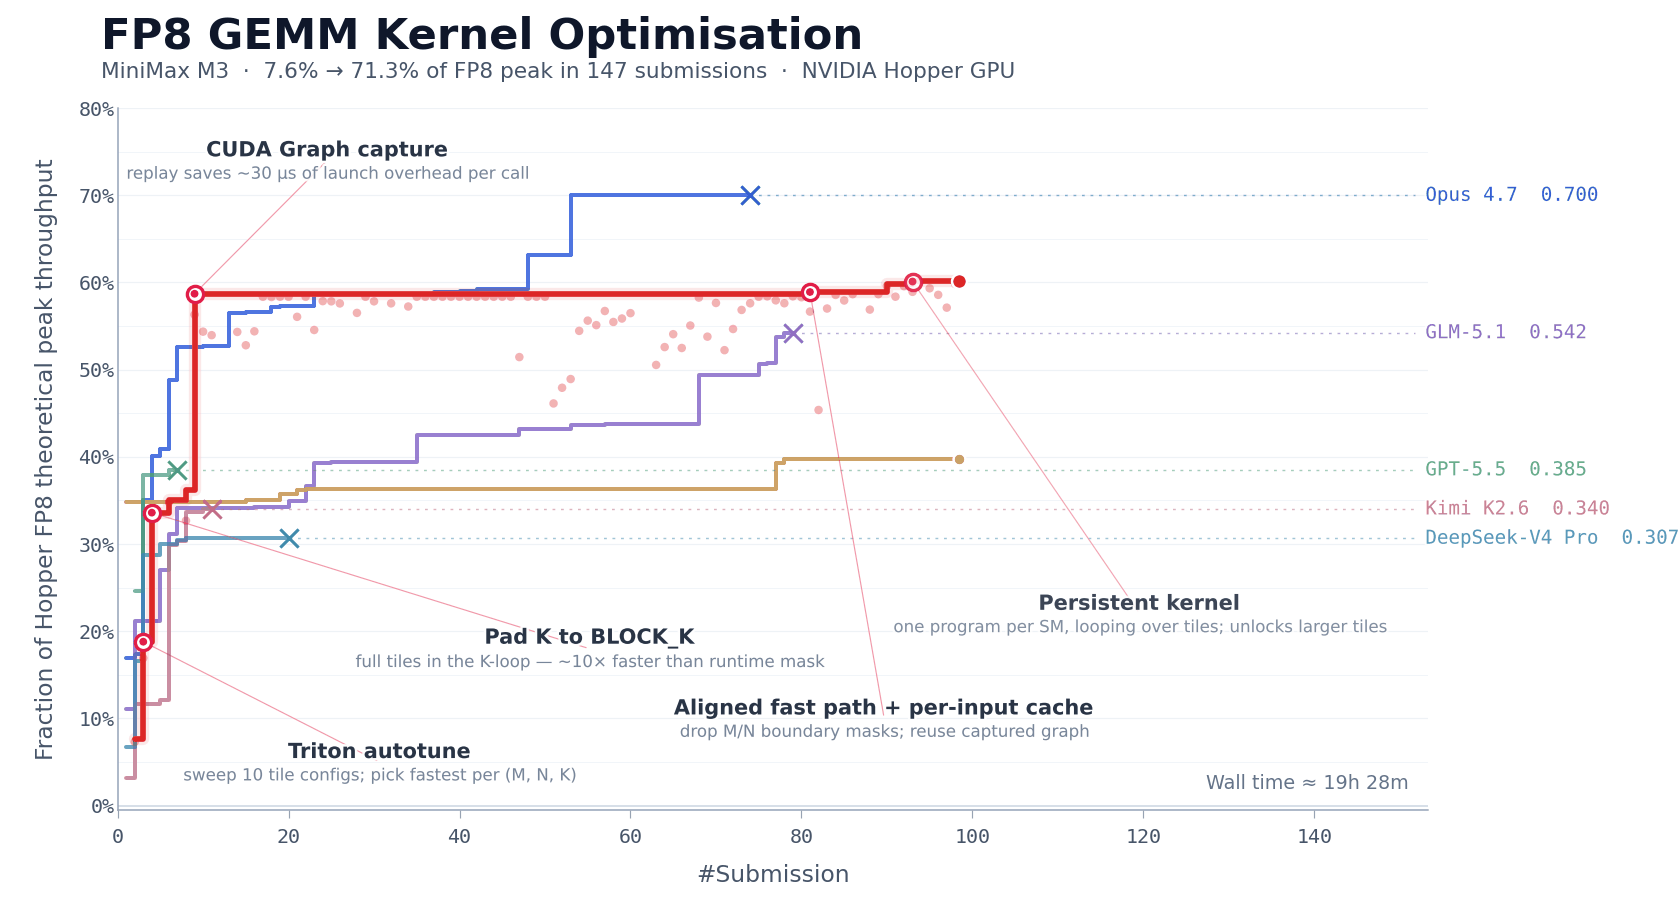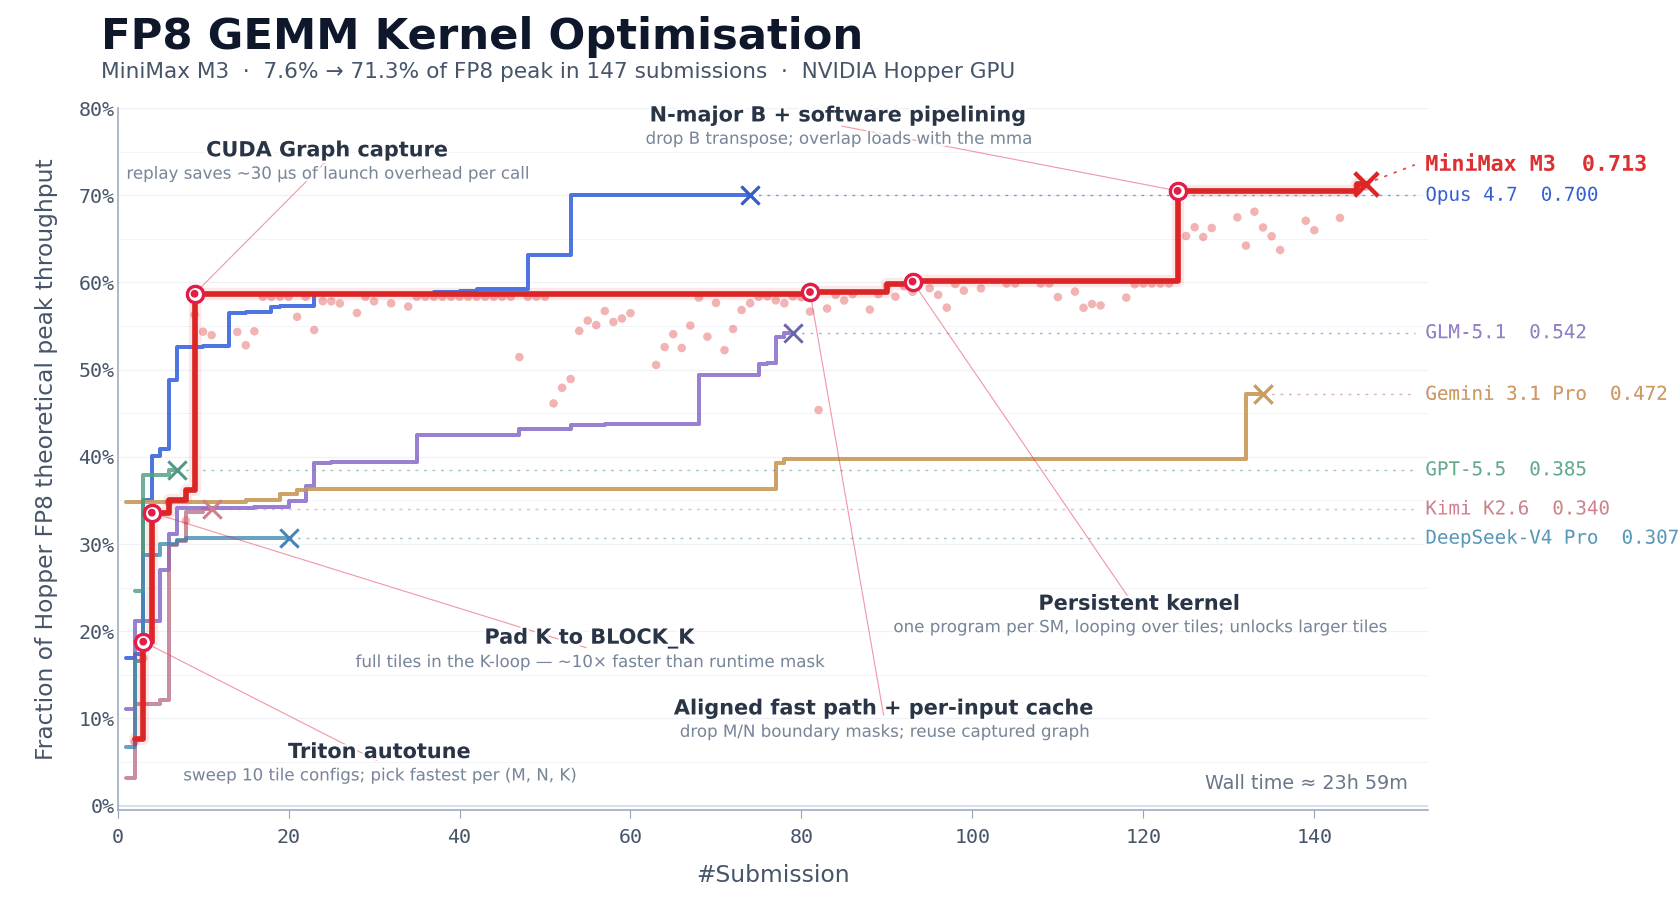
CUDA 算子优化:在仅提供任务描述、benchmark 评估脚本及不可直接运行的 Triton 骨架条件下,M3 连续执行约 24 小时,完成 147 次 benchmark 提交、1959 次工具调用,自主完成从 baseline 到生产级优化的全路径,将 NVIDIA Hopper GPU 的 FP8 GEMM 硬件峰值利用率从 7.6% 提升至 71.3%,实现 9.4 倍加速。其最优解出现在第 145 次提交,此前经历多个平台期仍持续尝试。
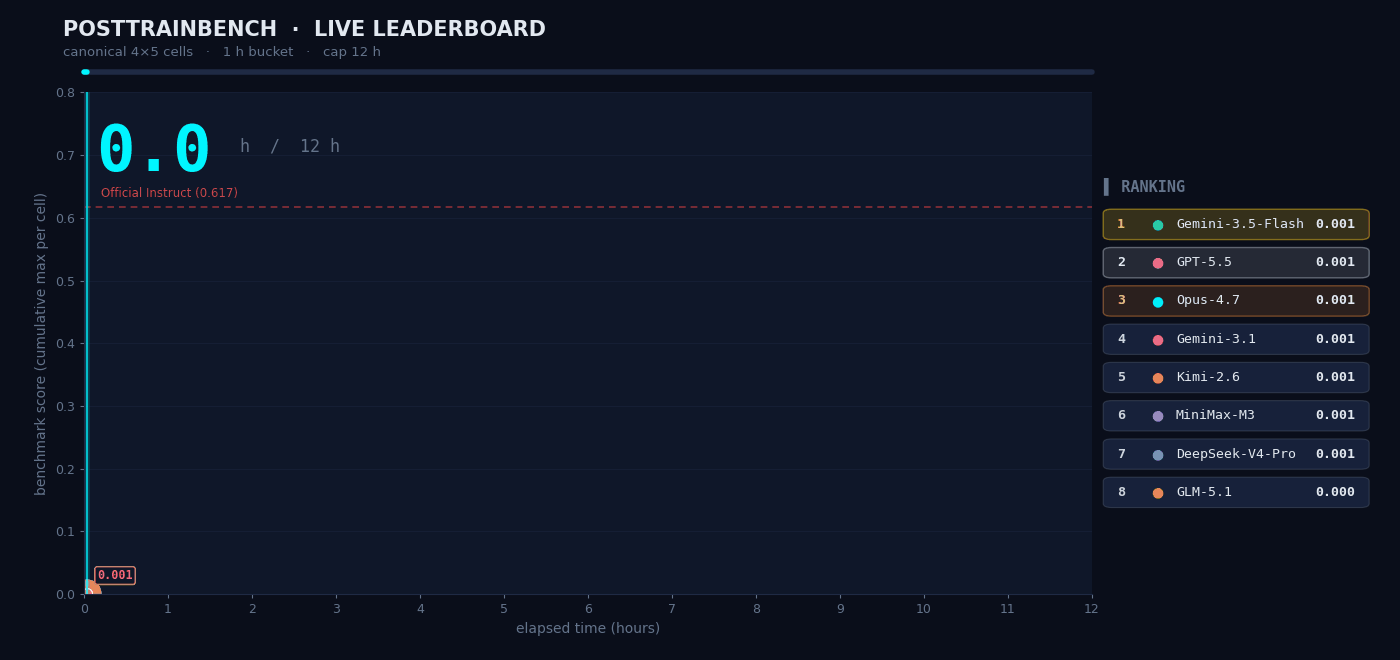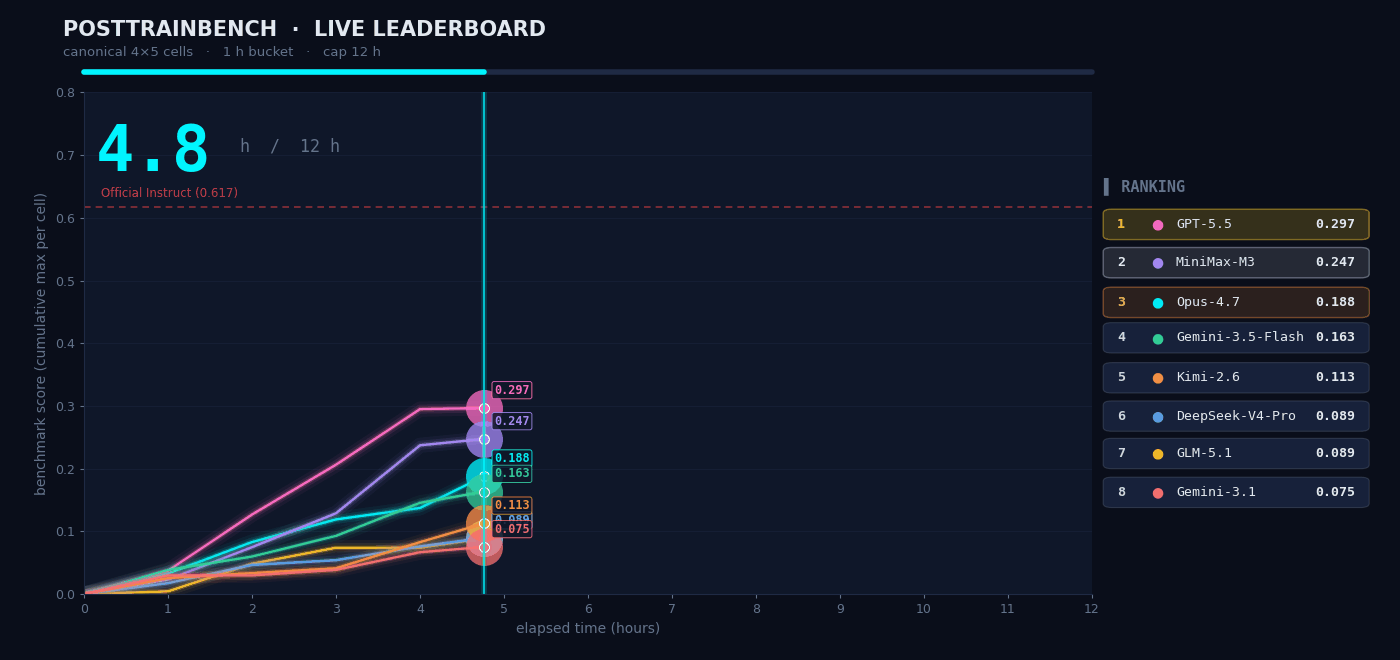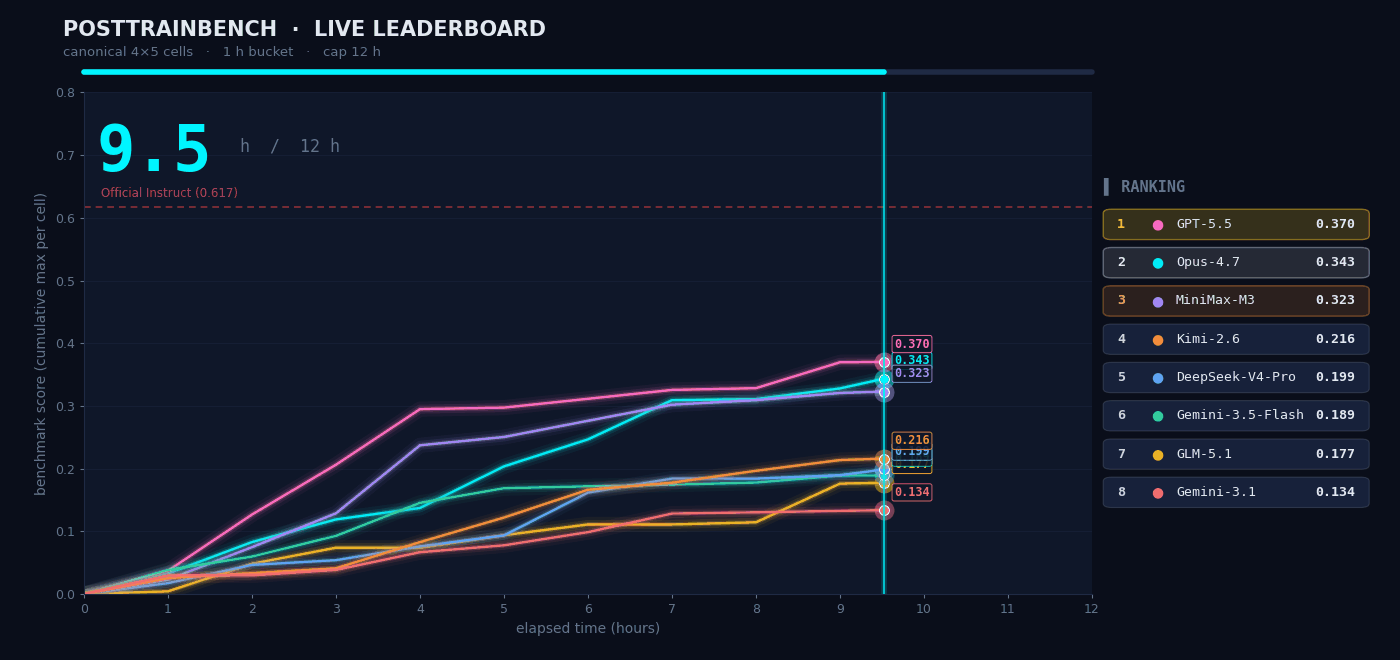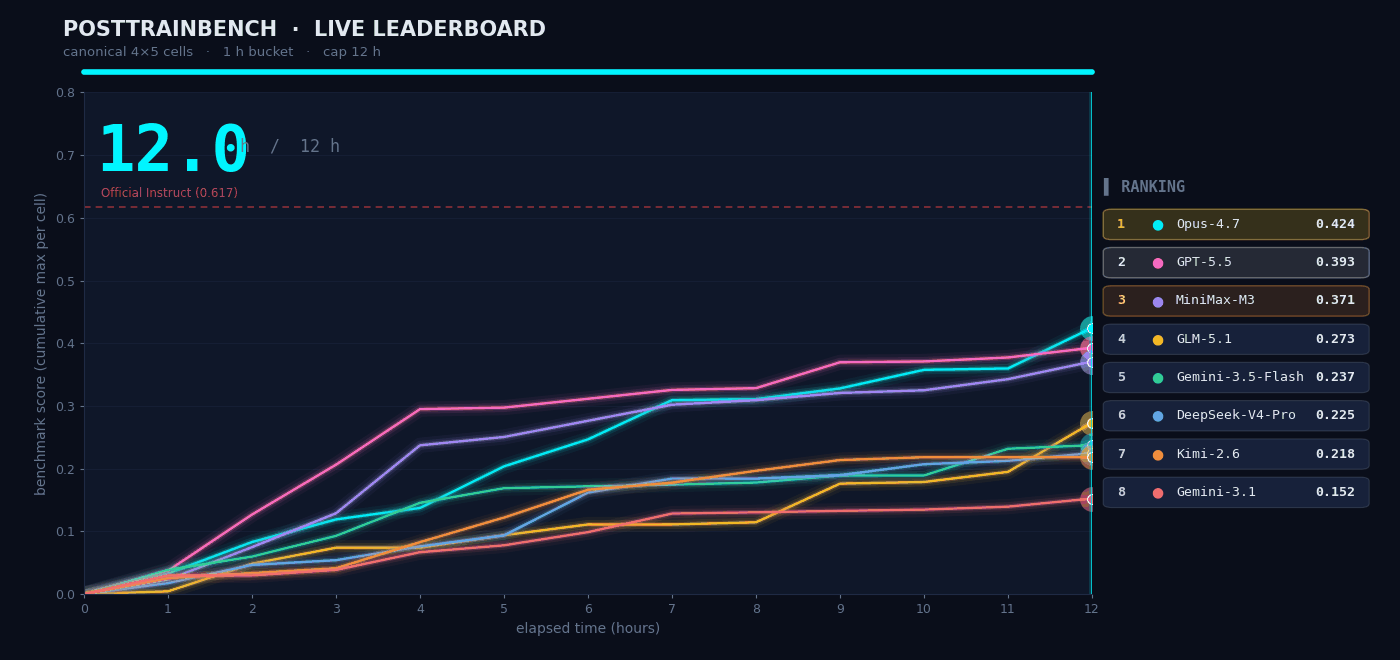
自主模型训练:在 PostTrainBench 测试中,M3 接收 4 个仅完成预训练的 Base 模型,在 12 小时内自主完成数据合成、训练、评测、迭代全流程,最终得分 0.37,略低于 Opus 4.7(0.42)和 GPT-5.5(0.39),但明显领先其余模型。
MiniMax Code 同步更新
专为 M3 设计并协同训练的 Agent 产品 MiniMax Code 同步更新。其 Agent Team 可将大型任务拆解为多阶段、可并发、可动态调整的 Workflow,通过 Producer + Verifier 对抗式 Harness 循环持续产出、反思与修正,可自主运行数天。与 Claude Code 的 Dynamic Workflows 相比,MiniMax Code 更聚焦"深度反思与持续纠错",支持用户随时介入调整。
依托 M3 的原生多模态能力,MiniMax Code 具备 Computer Use 能力,可执行跨应用、跨文件、跨系统的电脑端操作。该产品基于 OpenCode 和 Pi Agent 开源项目构建,后续计划开源回馈社区。
Token Plan 与 API 服务
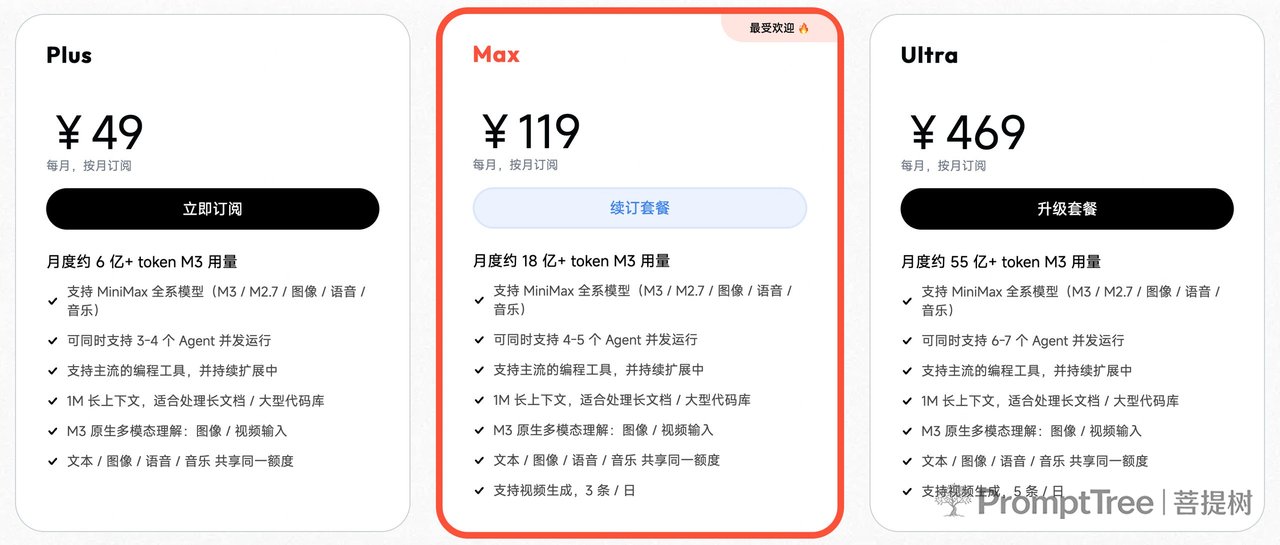
MiniMax Token Plan 推出三档订阅:
- Plus:49 元/月,6 亿 token
- Max:119 元/月,18 亿 token
- Ultra:469 元/月,55 亿 token
老用户原套餐价格保留,可按对应档位切换使用 M3。
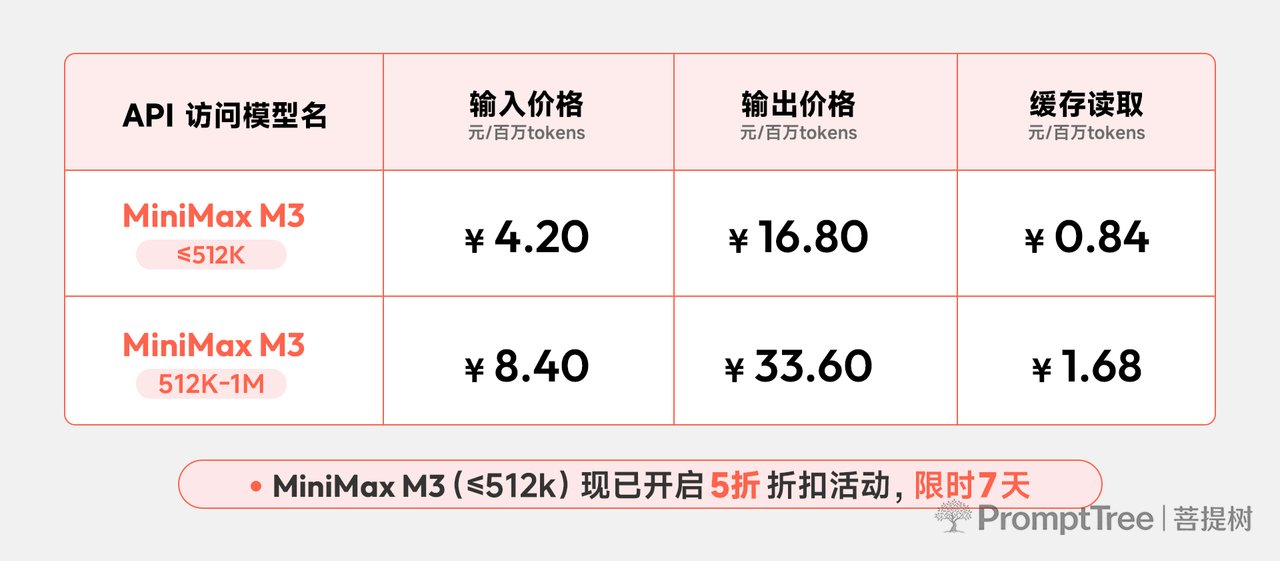
M3 API 已开放,按上下文长度分两档计价,支持 thinking 与 non-thinking 两种模式,共享同一套定价。另设优先通道(service_tier=priority)应对高并发场景,当前由销售对接开通,预计数日内全量开放。
MiniMax 表示,将在未来 10 天内更新技术报告并开源模型权重。