MiniMax Music 3.0:新一代开放权重、生产级全能音乐模型
声明:文档由AI根据原文生成。
2026年8月13日,MiniMax正式发布新一代音乐生成模型MiniMax Music 3.0。用户仅需提供创意想法与可选歌词,模型即可在一次生成中完成作曲、编曲、演唱与制作,输出最长5分钟的完整歌曲。
Music 3.0针对音乐生成中的核心难点进行优化:理解创作者的真实表达意图,在长时段作品中持续贯彻这一意图,以清晰且富有真实质感的方式呈现乐器,并让生成人声更接近真实演唱而非机器合成。为此,MiniMax从音乐描述、语言模型到声音渲染重新设计了整条生成链路,带来三项核心升级:更准确的创作意图理解、更完整且富于变化的编曲,以及更清晰自然的声音表现。
三层架构:Tokenizer、Hybrid-LM与Synthesis
Music 3.0由三个相互衔接的核心组件构成,分别解决音乐信息的表示、长程结构与局部细节的建模,以及声音的高保真还原问题。
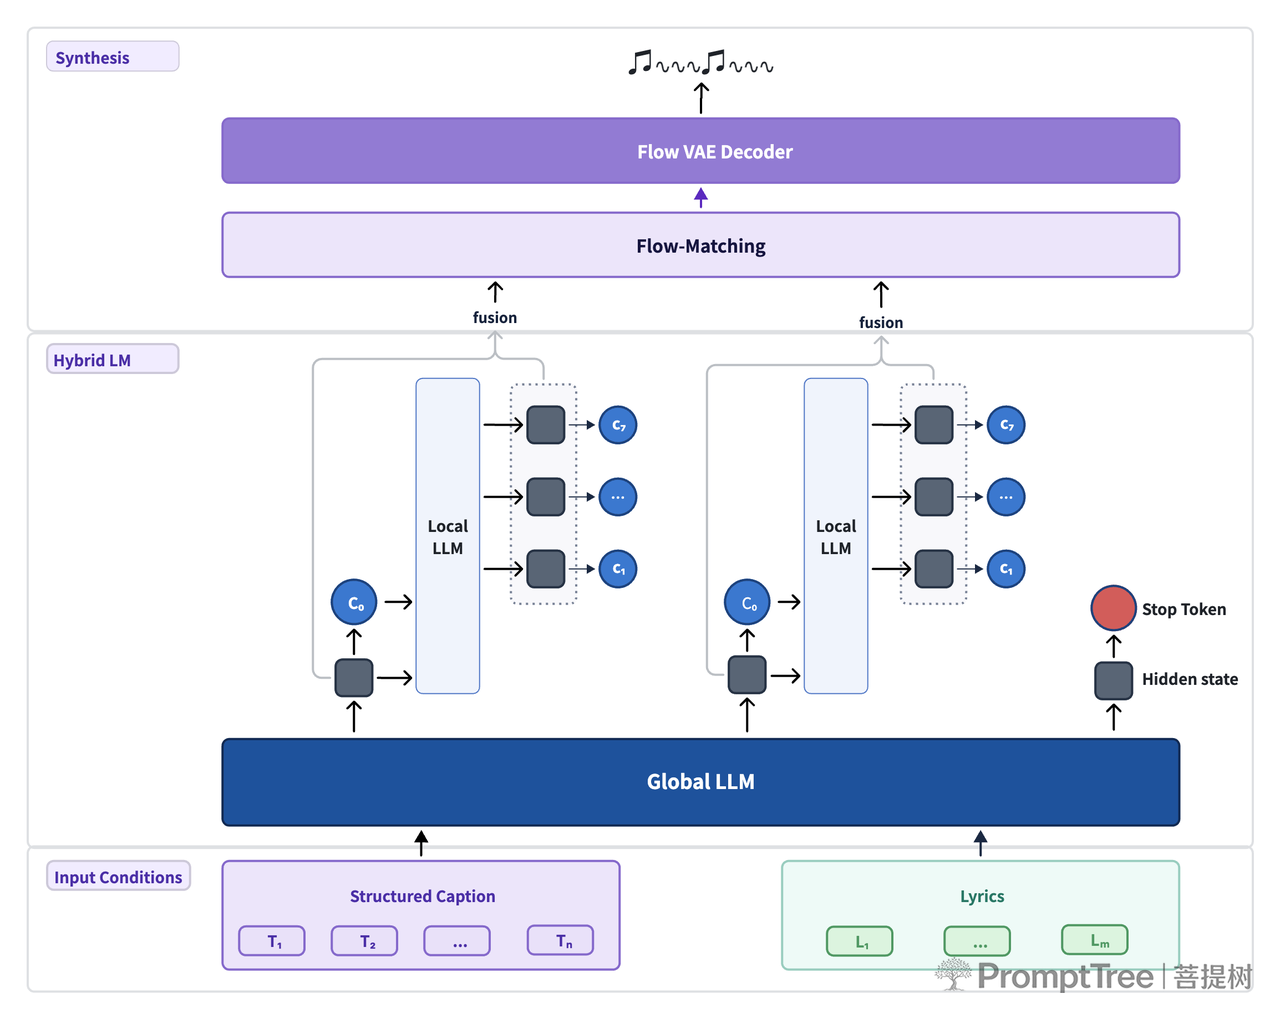
MiniMax Music 3.0 technical architecture
多层RVQ:分离核心结构与声学细节
八层残差向量量化(RVQ)将音乐信息分级表达。第一层码本大小为16,384,聚焦核心语义与结构;第2至8层码本大小各为1,024,逐层补充残余声学细节。训练采用分阶段策略:先单独训练第一层以建立稳定的信息骨架,再联合训练全部八层学习精细声音。这一设计既为长序列预测提供更稳定的离散表示,也避免单层token同时承担过多结构与音质信息。
Hybrid-LM:全局结构与局部声学协同建模
模型采用8B Global LLM与0.6B Local LLM的分层协作架构。Global LLM基于Qwen3.5-8B初始化,负责语义token的逐帧预测与全局上下文把握;Local LLM随机初始化,负责帧内声学token的深度轴预测。训练分为全局对齐与联合训练两个阶段:先建立Global LLM对音乐语义的预测能力,再对两模型进行全参数联合训练。该分工使模型既能维持完整歌曲的结构稳定性,也能在局部段落中保留丰富变化。
Hidden State Fusion:从离散预测走向连续声音渲染
与传统方案将离散声学token直接送入解码器不同,Music 3.0融合Global LLM与Local LLM的连续Hidden States,作为2.4B Flow-Matching模块的条件输入,再由123M Flow-VAE完成音频解码。完整链路为:LLM融合特征 → Flow-Matching → VAE Hidden States → Flow-VAE Decoder → 最终音频。这一设计让语言模型的结构理解与声学模型的声音还原通过连续表征直接连接,在保持长程一致性的同时提升发音准确性、乐器连贯性与细节保真度。
细粒度时序描述:准确理解创作意图
AI生成音乐常出现指定乐器消失、预设情绪减弱、人声风格无法贯穿等问题。Music 3.0升级了音乐描述方式,不再仅用全局标签概括作品,而是通过Structured Caption进行细粒度时序描述。
Structured Caption既描述曲风、BPM、拍号、调性、应用场景与制作质感,也刻画情绪起伏、主辅乐器进退、律动与低频发展,以及演唱方式、和声和人声效果随段落的变化。这些描述将抽象听感转化为可被模型执行的专业编曲框架,使模型能在歌曲发展过程中维持一致的音乐身份,同时保留必要的动态变化。
为降低专业创作门槛,MiniMax还构建了基于模板的Prompt Enhancement System。该系统从专业Structured Caption模板库中选择合适表达,参考音乐术语与编曲规则,将用户的简单描述扩展为音乐逻辑完整、细节丰富的结构化指令。
全局—局部协作:完整且富于变化的编曲
长歌曲生成的难点在于段落间的合理发展——情绪需铺陈与释放,乐器需适时进入、叠加与退场,各段落需服务于同一整体方向。
Music 3.0通过两个层面解决这一问题。歌词中的[intro]、[verse]、[pre-chorus]、[chorus]、[bridge]、[instrumental]、[solo]、[outro]等段落标签提供宏观结构;Structured Caption进一步描述各时间阶段的情绪发展、配器变化、人声演绎、律动基础、装饰音色与空间效果,使"哪里发生什么变化"成为明确的生成条件。
在模型侧,8B Global LLM逐帧预测承载核心语义与结构的token,0.6B Local LLM在每一帧内部沿深度轴预测声学token。这种分工让模型既能维持最长5分钟歌曲的时间稳定性,也能在局部保留丰富变化。
连续特征驱动:革新声音品质与自然人声
Music 3.0在音质方面实现显著提升,混音更加开阔、清晰和平衡,减少拥挤与浑浊感。
声音建模从多层RVQ开始,分层建模在语义信息容量、生成稳定性与细节还原之间取得平衡,同时降低长序列生成中的累计误差。最终渲染阶段,Synthesis模块不加载离散Tokenizer的解码结构,而是融合两套LLM的连续Hidden States,通过Flow-Matching和Flow-VAE直接生成音频。连续特征保留更丰富的高维声学信息,有助于提高人声发音准确性与乐器声音的物理连贯性。
2.4B Flow-Matching模块将融合后的语言模型特征映射至VAE隐空间;123M Flow-VAE继承MiniMax Speech架构,针对音乐的动态范围和频谱分布重新训练。模型因此能够响应更具体的乐器指令,表现滑音、连奏等真实演奏技法,不同乐器在编曲中的角色更加清楚,低频在保持力量感的同时不会淹没整体。
人声方面,Structured Caption对音色、唱法、气声与假声技巧、和声编排以及Delay、Autotune等人声效果进行细致描述;融合后的连续Hidden States将这些演唱信息带入音频生成过程。两者结合减少了高频"数字噪声",提升了对旋律、发音、呼吸和多层和声的控制能力。人声能够更连贯地响应歌曲在情绪和节奏上的变化,和声更自然地围绕主唱展开,呼吸也成为演唱表达的一部分。