NVIDIA Jetson AGX Thor 助力集和诚打造半导体前道晶圆检测边缘算力基座
声明:文档由AI根据原文生成。
物理AI落地半导体制造的核心瓶颈
半导体前道晶圆检测覆盖光刻、刻蚀、薄膜沉积、化学机械抛光、离子注入退火、关键尺寸量测及缺陷复查等关键工艺环节。检测设备需在严苛环境下对4K乃至8K级图像实现高通量、高精度的实时缺陷发现,是"物理AI"从概念演示走向产线落地最具挑战的场景之一。
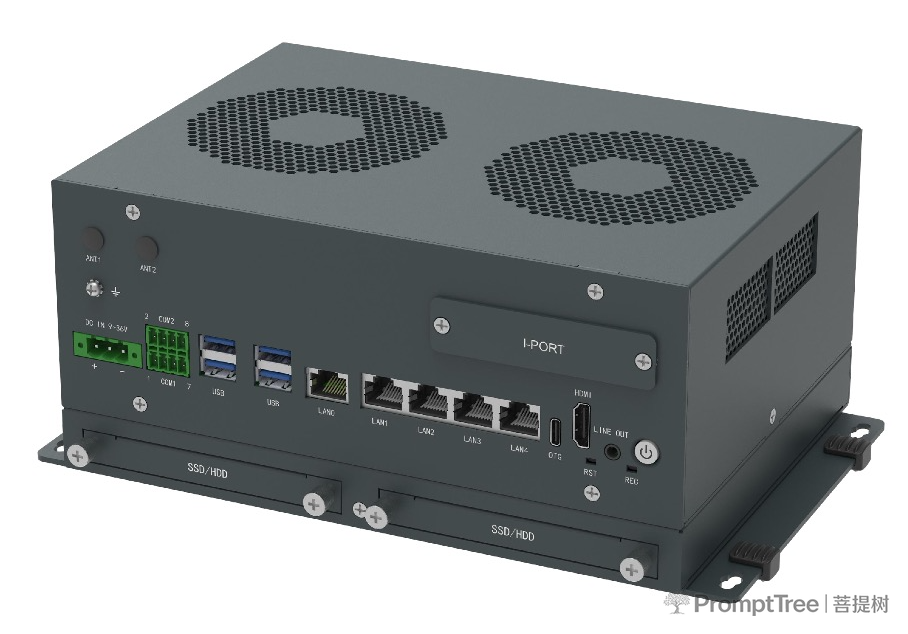
深圳市集和诚科技开发有限公司与NVIDIA的共同实践验证了一条可行路径:基于NVIDIA Jetson AGX Thor(Blackwell架构)边缘AI计算平台,由集和诚自研整机BRAV-7138(220×160×80mm)承载,在产线边缘实现"高速AOI检测+电子束图像分析+设备健康监控"的一机多工,并让30B+参数量的视觉语言模型(VLM)在产线本地稳定运行,打通"侦测—判定—控制"的毫秒级闭环。
前道晶圆检测的五重算力困局
集和诚在打造这套AI检测边缘计算平台时,面临五重核心挑战:
算力与内存瓶颈限制大模型部署。 原有Jetson AGX Orin平台最大仅支持64GB内存,运行多模型级联、软RAID与加密开销时内存吃紧,32B以上参数量的大模型无法在本地部署,难以实现实时缺陷根因分析;若依赖云端传输,则带来严重时延与晶圆图像IP泄露风险。
检测精度与速度的矛盾。 先进制程要求检出亚纳米级缺陷,而高分辨率图像(4K甚至8K)数据量巨大,算力窗口稍纵即逝。
多模态数据融合困难。 需同时处理光学图像、电子束图像、光谱数据与工艺参数(FDC数据),传统边缘设备难以实时融合分析。
罕见缺陷识别难。 约90%缺陷集中在常见模式,但剩余10%的罕见缺陷对良率影响最大;传统规则算法漏检率高,且模型迭代(OTA)无法满足产线不停机的热更新需求。
产线级多任务与严苛环境。 晶圆图像包含核心IP,需满足SEMI、IEC 62443等安全合规标准;洁净室要求设备7×24小时连续运行,散热与稳定性要求极高,单台设备难以同时兼顾多重任务。
"一机多工"算力基座的硬件与软件架构
整体方案采用NVIDIA Jetson AGX Thor边缘AI计算平台(Blackwell架构),由集和诚自研整机BRAV-7138承载。Jetson AGX Thor提供128GB统一内存,可加载晶圆多层叠加图像(Layer Stack)进行跨层缺陷关联分析(如TSV对准偏差);T4000/T5000模组兼容设计,支持宽温−20℃至60℃、宽压9V至36V,配备工业级网络与高速I/O接口、灵活存储扩展与RAID支持。
系统层基于JetPack 7.0(Ubuntu 24.04),提供fTPM、LUKS全盘加密、mdadm RAID驱动、PVA/VIC硬件加速接口与安全启动配置,构成满足IEC 62443要求的安全基线。
AI推理与加速软件栈包括:NVIDIA Holoscan Sensor Bridge实现传感器数据超低延迟直传GPU内存;DeepStream 8.0负责多相机流管理与流水线调度;VPI 4调用PVA硬件加速器完成图像预处理;NGC提供预训练缺陷检测模型的容器化部署;CUDA 13+cuDNN+TensorRT 10实现FP4量化与内核自动调优;Triton Inference Server同时托管YOLOv9、UNet、PatchCore与Qwen2.5-VL等多模型。
多模型分工层面,YOLOv8-X/YOLOv9负责高速初筛定位缺陷坐标;UNet完成像素级分割,区分颗粒、划痕、图形断线、桥接等图案缺陷;Qwen2.5-VL/Qwen3-VL以缺陷ROI图像为输入,输出细分类别与工艺根因的自然语言文本;PatchCore、PaDiM负责小样本未知缺陷检测。
主要模型性能指标如下:
| 模型名称 | 输入分辨率 | p95时延 | 吞吐 |
|---|---|---|---|
| YOLOv9 | 4096×4096扫描切片 | 34 ms | 单流35—42 FPS |
| UNet | 缺陷ROI 1024×1024 | 24 ms | 55—65 ROI/s |
| Qwen2.5-VL/32B | 缺陷ROI 512—1024 | 950 ms | 1.2—2 req/s(并发工况) |
| PatchCore | 缺陷ROI 1024×1024 | 29 ms | 48—58 ROI/s |
六步实施路径与关键技术优化
2026年,集和诚完成从选型验证到产线级落地的六步实施:
硬件设计与选型验证。 完成BRAV-7138整机方案规划与散热设计,支持1路万兆网、4路千兆网、4路USB 3.2(接触式温/湿度、气体流量等传感器)及2路CAN FD,适配宽温宽压,满足洁净室EFEM顶部横梁安装要求。
BSP与安全基线部署。 刷写JetPack 7.0,激活fTPM与Secure Boot,完成LUKS全盘加密、IPSec网络加密及软RAID1配置,对齐IEC 62443标准。
预处理流水线调优。 基于VPI/Holoscan对接多路工业相机,将图像降噪、ROI裁剪卸载至PVA硬件加速器;验证高分辨率图像持续写入RAID存储的IO压力与系统稳定性。
模型适配与优化。 针对Thor的Blackwell架构完成模型量化并生成TensorRT引擎;对VLM大模型采用AWQ 4bit权重量化、分页KV-Cache、Prefill/Decode显存隔离调度,在精度损失可控前提下将显存开销降低约30%;部署Triton推理服务,配置MIG GPU切片以隔离CNN检测任务与VLM大模型任务;重构DeepStream流水线,实现多路图像预处理、检测、VLM根因分析的级联调度。
系统集成。 完成SECS/GEM网关对接、MES良率数据回传与OTA更新链路;打通"采集—预处理—Triton推理—后处理—RAID落盘—MES上报"全链路,原始缺陷图像加密保存至RAID。
压力与稳定性测试。 进行7×24小时满载压力测试,模拟全负载相机流、SSD故障后RAID降级及模型热升级,确保产线零停机。
量化成果与产线效益
推理吞吐与并发能力方面,初筛缺陷检测推理吞吐提升1.8—3倍;支持6—8路高分辨率光路同时处理,较此前方案提升一倍以上。
检测质量方面,依托本地VLM根因分析,缺陷细分类别数量提升2—3倍;未知缺陷检出能力提升30%;在公开缺陷数据集WM-811K上分类准确率达99.31%;误报率与缺陷逃逸率下降30%—40%。
晶圆处理效率方面,单片晶圆检测推理耗时下降45%—65%;单台设备每小时晶圆处理量提升60%—110%。
成本收益方面,减少配套服务器硬件成本、网络建设与数据安全合规改造成本,缩短问题排查周期并减少物料浪费。
技术路线意义与产业展望
集和诚科技产品经理苏州表示:"在半导体前道晶圆检测领域,算力、内存和实时性是无法妥协的铁三角。NVIDIA Jetson AGX Thor的128GB统一内存和强大的Blackwell架构,让我们实现了在产线边缘端本地运行30B+参数的VLM大模型,彻底打通了'侦测—判定—控制'的毫秒级闭环。BRAV-7138不仅让检测吞吐量翻倍,更为晶圆厂提供了满足最高安全合规标准的'一机多工'边缘算力基座。"
集和诚科技2002年成立于深圳,二十余年深耕工业计算、边缘智能与设备控制领域,当前战略定位为物理AI核心硬件服务商。面向半导体制造精细化工艺场景的深层需求,该公司将持续深耕边缘AI算力硬件落地,依托NVIDIA新一代架构与中国半导体产业的前沿积累,推动全面智能化的检测方案成为驱动良率提升的核心引擎。