DeepSeek API 上线上下文硬盘缓存,重复输入按0.1元/百万tokens计费
声明:文档由AI根据原文生成。
缓存服务自动运行,重复输入大幅降价
2024年8月2日,DeepSeek 宣布其 API 服务的上下文硬盘缓存功能已全面上线。该功能针对大模型调用中大量存在的重复输入场景,将预计会重复使用的内容缓存在分布式硬盘阵列中。当用户输入存在重复前缀时,系统直接从缓存读取,无需重新计算。
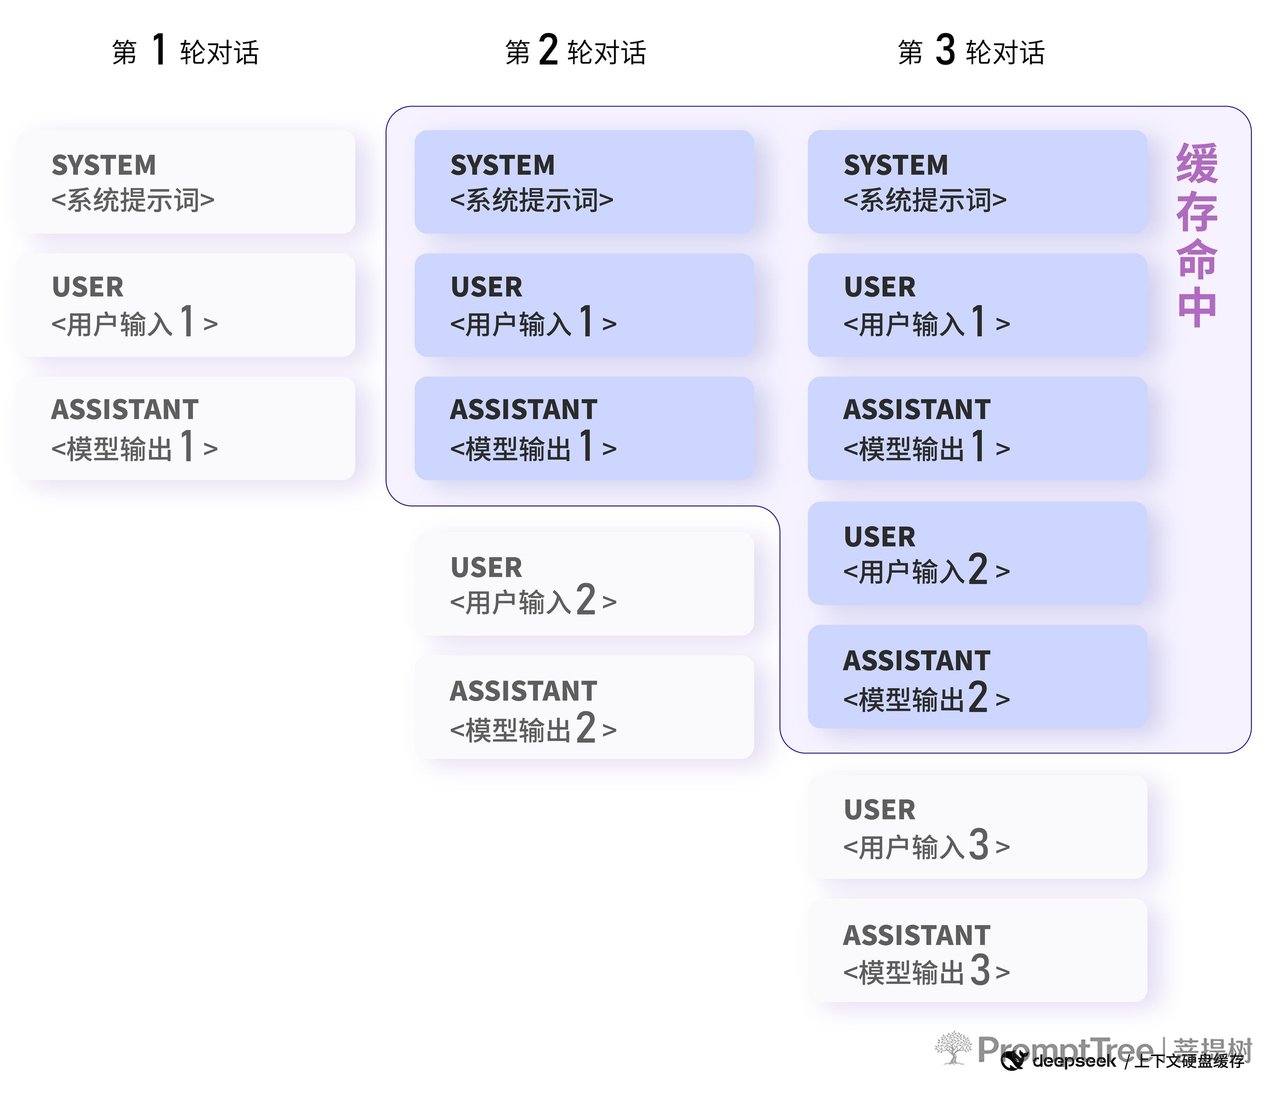
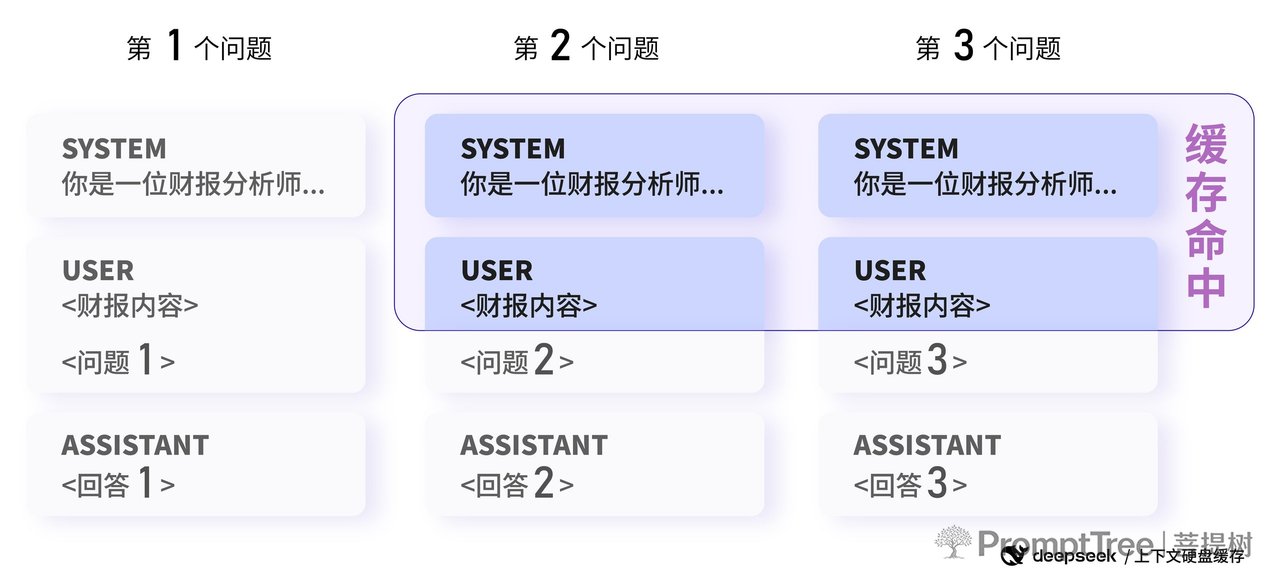
用户无需修改代码或更换接口,缓存服务自动运行并按实际命中情况计费。只有从第0个token开始完全相同的请求前缀才会触发缓存命中,中间开始的重复不计入缓存。
定价与查询方式
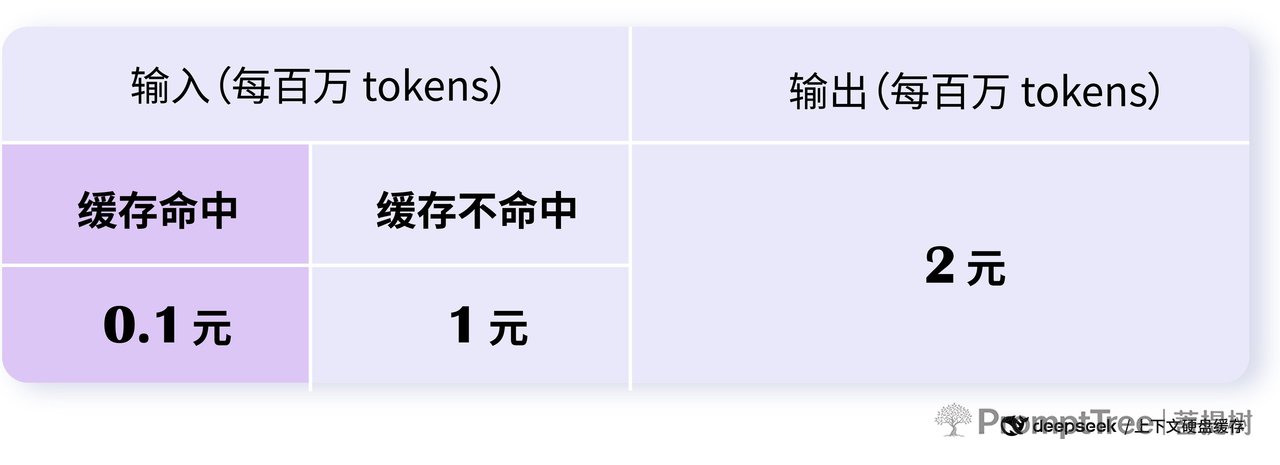
缓存命中的输入部分按0.1元/百万tokens收费,未命中部分维持1元/百万tokens原价。API返回的usage字段中新增prompt_cache_hit_tokens和prompt_cache_miss_tokens两项,供用户实时查看命中情况。
存储方面,缓存占用不额外收费,但系统以64 tokens为一个存储单元,不足该长度的内容不会被缓存。缓存采用"尽力而为"策略,不保证100%命中;长时间不用的缓存会在数小时至数天内自动清空。
延迟与费用实测数据
对于输入较长且重复内容多的请求,首token延迟显著降低。DeepSeek公布的极端测试案例显示,128K输入且大部分重复的请求,首token延迟从13秒降至500毫秒。
费用节省方面,若针对缓存特性优化,最高可节省90%;即使不做任何优化,按历史使用情况用户整体节省也超过50%。
典型应用场景
多轮对话是主要受益场景之一:下一轮对话会自动命中上一轮生成的上下文缓存。此外,具有长预设提示词的问答助手、长角色设定的角色扮演应用、针对固定文本频繁查询的数据分析工具、代码仓库级别的代码分析与排障工具,以及采用Few-shot提升模型效果的场景,均能显著受益。
技术基础与安全设计
DeepSeek 称,其能够率先采用硬盘缓存,得益于DeepSeek V2提出的MLA(Multi-head Latent Attention)结构。该结构在提升模型效果的同时,大幅压缩了上下文KV Cache的体积,使存储所需的传输带宽和容量均显著减少,从而得以部署在低成本的硬盘上。
安全层面,每个用户的缓存相互独立、逻辑隔离,底层机制保障数据安全与隐私。缓存不会长期保留,也不会用于其他用途。
服务容量
DeepSeek API 按每天1万亿tokens的容量设计,对所有用户不限流、不限并发。