DeepSeek-V3正式发布:671B参数MoE模型开源,生成速度提升3倍
声明:文档由AI根据原文生成。
模型核心参数与上线安排
2024年12月26日,DeepSeek发布并开源新一代大语言模型DeepSeek-V3。用户可登录官网 chat.deepseek.com 与最新版模型对话,API服务已同步更新且接口配置无需改动。当前版本暂不支持多模态输入输出。
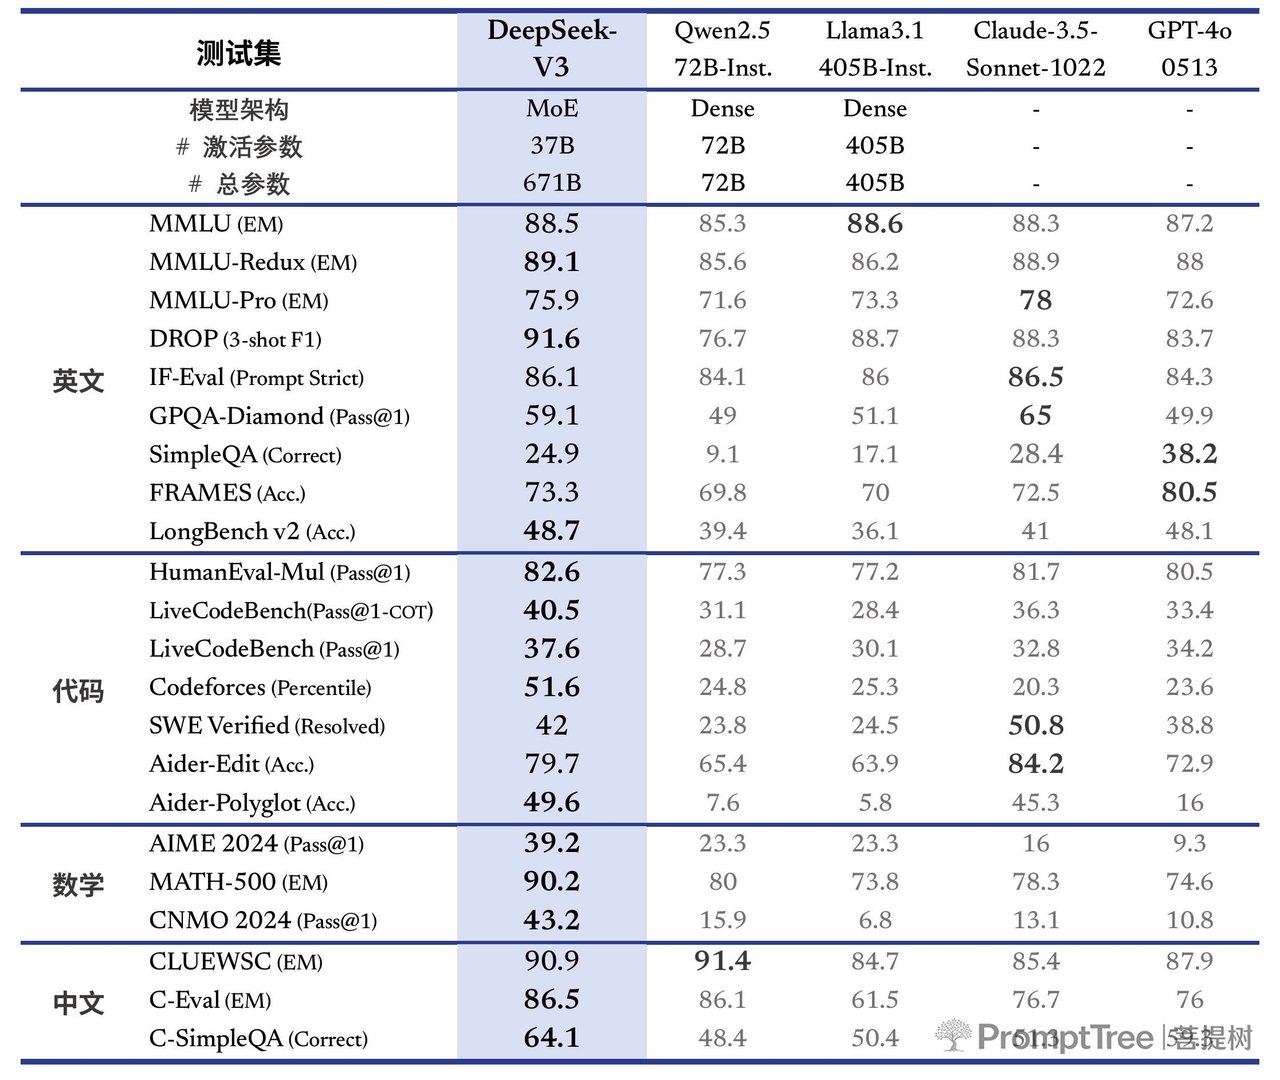
DeepSeek-V3采用自研MoE架构,总参数671B,激活参数37B,在14.8T token上完成预训练。
评测表现
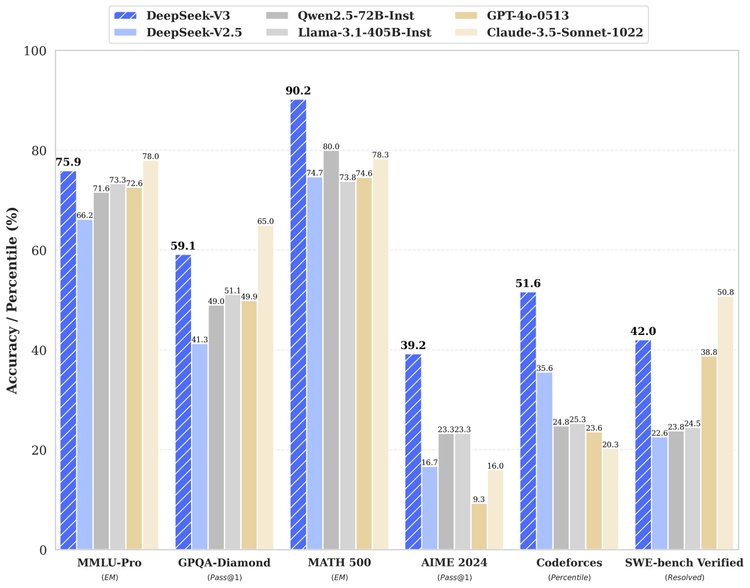
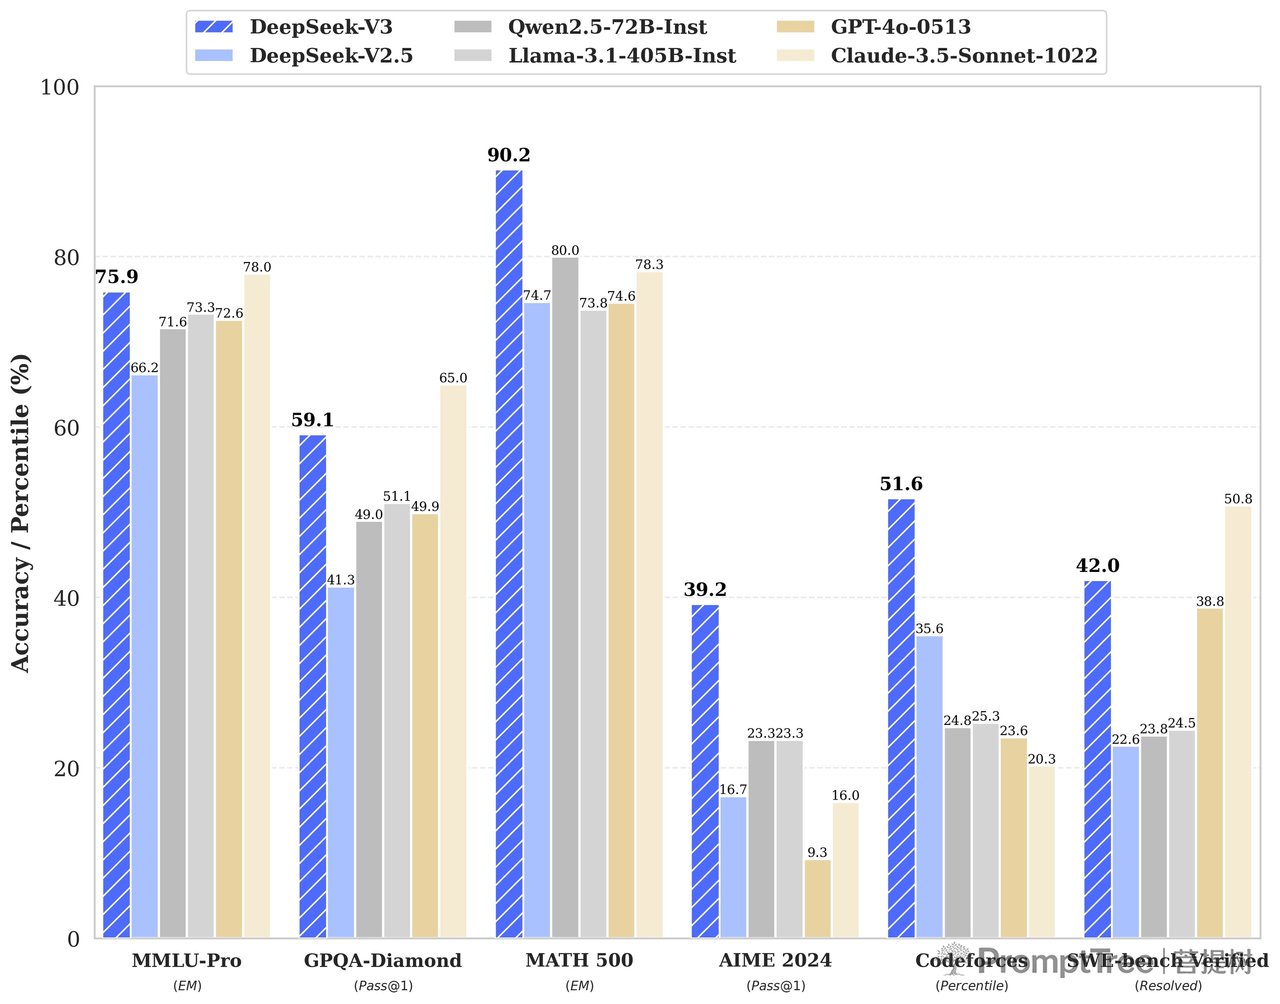
多项基准测试显示,DeepSeek-V3成绩超越Qwen2.5-72B、Llama-3.1-405B等开源模型,在性能上与GPT-4o、Claude-3.5-Sonnet等顶尖闭源模型接近。
知识类任务(MMLU、MMLU-Pro、GPQA、SimpleQA)上,DeepSeek-V3较前代DeepSeek-V2.5显著提升,接近Claude-3.5-Sonnet-1022。长文本测评(DROP、FRAMES、LongBench v2)平均表现超越其他模型。算法代码场景(Codeforces)领先全部非o1类模型,工程代码场景(SWE-Bench Verified)逼近Claude-3.5-Sonnet-1022。数学竞赛(AIME 2024、MATH、CNMO 2024)成绩超过所有开源闭源模型。中文能力方面,与Qwen2.5-72B在C-Eval等教育测评上相近,C-SimpleQA事实知识评测更为领先。
生成速度优化
通过算法与工程创新,DeepSeek-V3生成吐字速度从20 TPS提升至60 TPS,较前代实现3倍提升。
API定价与优惠期
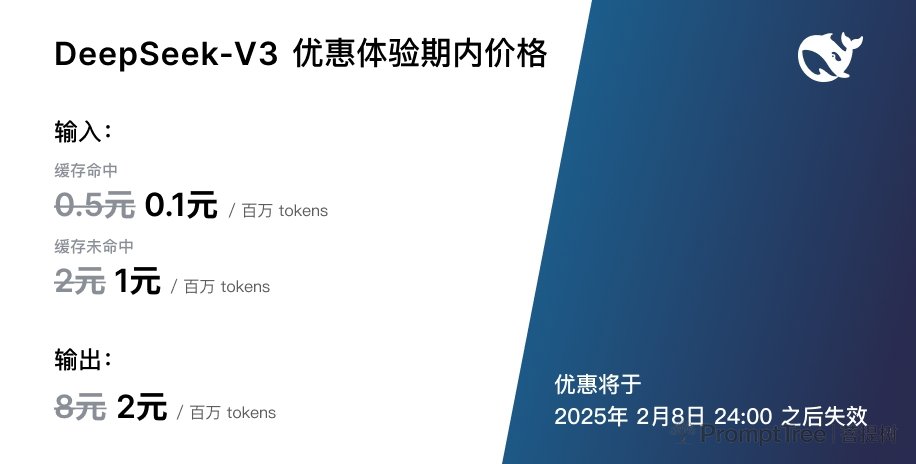
DeepSeek-V3 API服务定价调整为:每百万输入tokens 0.5元(缓存命中)/ 2元(缓存未命中),每百万输出tokens 8元。
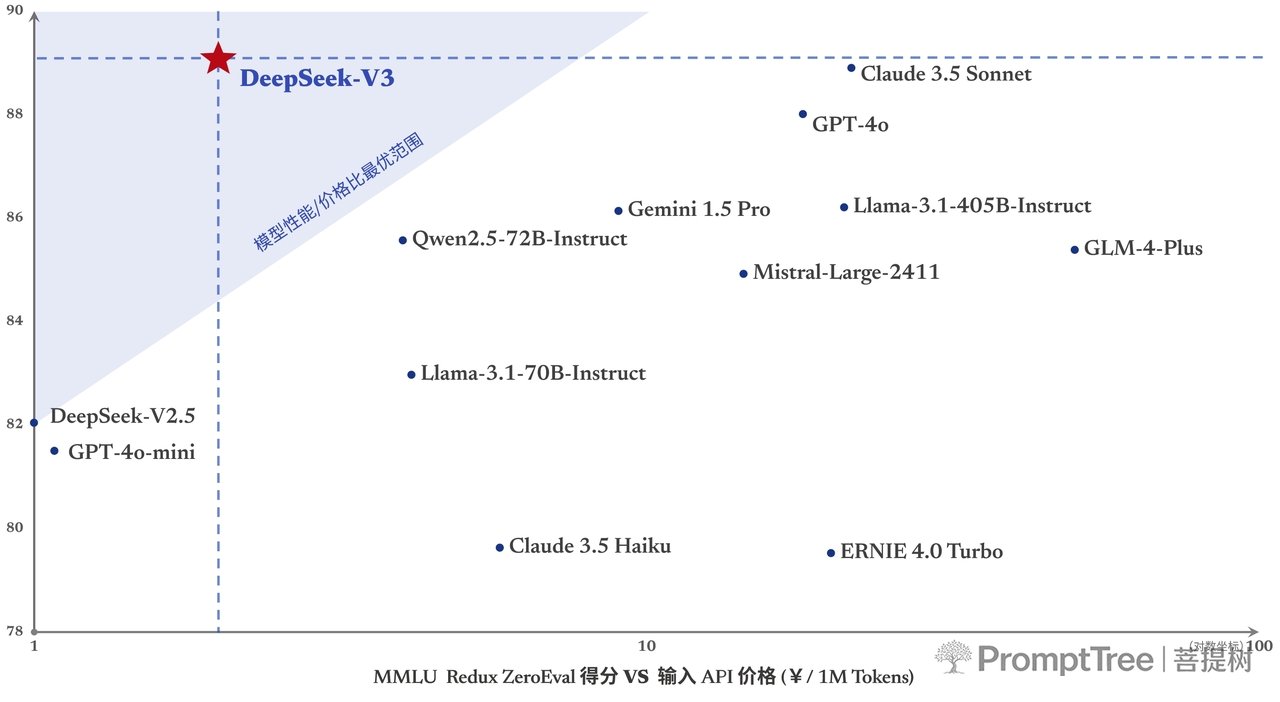
2024年12月26日至2025年2月8日期间设45天优惠体验期,期间价格维持:每百万输入tokens 0.1元(缓存命中)/ 1元(缓存未命中),每百万输出tokens 2元。新老注册用户均可享受。
开源部署支持
DeepSeek-V3采用FP8训练并开源原生FP8权重。SGLang、LMDeploy已支持原生FP8推理,TensorRT-LLM、MindIE实现BF16推理。官方同时提供FP8至BF16转换脚本。模型权重及部署信息见: https://huggingface.co/deepseek-ai/DeepSeek-V3-Base
DeepSeek表示,未来将在DeepSeek-V3基座模型上持续开发深度思考、多模态等功能,并与社区分享进展。