DeepSeek-R1 更新,思考更深,推理更强
声明:文档由AI根据原文生成。
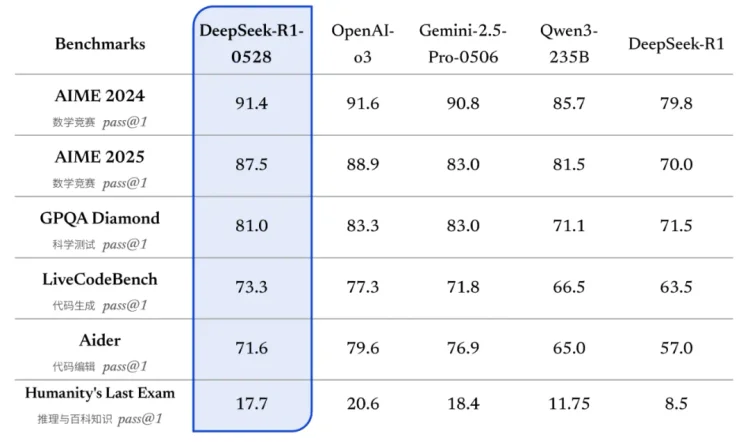
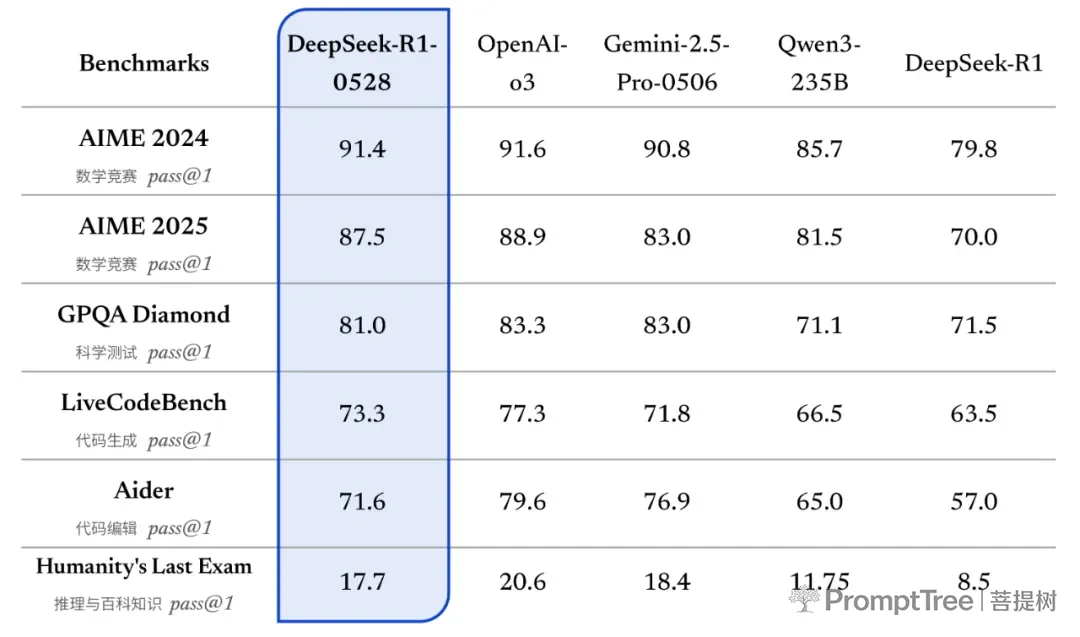
推理能力升级,AIME 准确率升至 87.5%
DeepSeek 于 2025 年 5 月 28 日发布 R1 模型小版本升级,当前版本号为 DeepSeek-R1-0528。用户通过官方网站、App 或小程序进入对话界面,开启"深度思考"功能即可调用新版模型;API 接口同步更新,调用方式不变。
该版本仍基于 2024 年 12 月发布的 DeepSeek V3 Base 模型,但在后训练阶段投入了更多算力。DeepSeek 方面表示,这显著增强了模型的思维深度与推理能力。
在 AIME 2025 数学测试中,新版模型准确率由旧版的 70% 提升至 87.5%。测试数据显示,旧版模型平均每题使用 12K tokens,新版则达到 23K tokens,解题过程中的思考更为详尽。
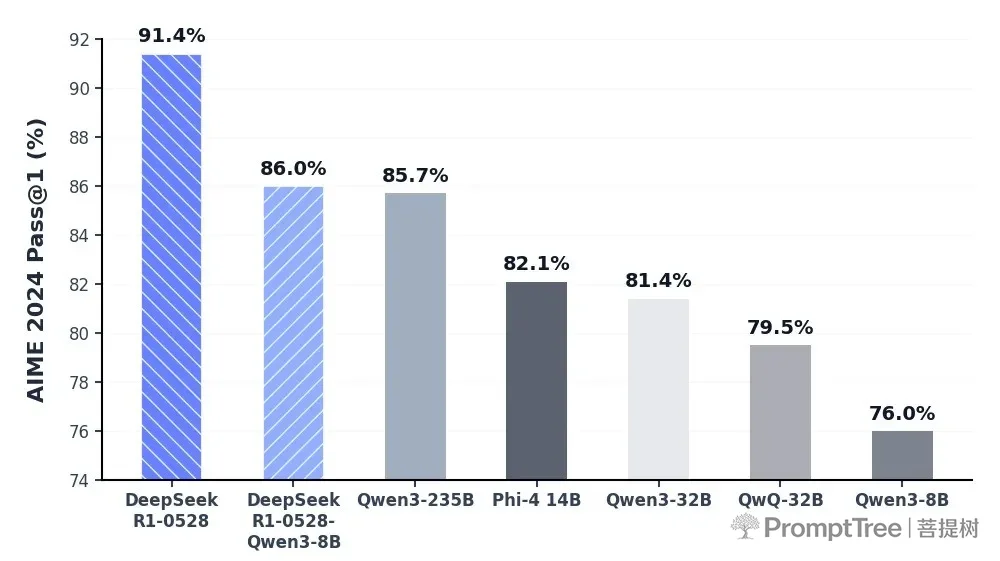
DeepSeek 同时蒸馏了 R1-0528 的思维链,后训练 Qwen3-8B Base 得到 DeepSeek-R1-0528-Qwen3-8B。这款 8B 小模型在 AIME 2024 测试中仅次于 R1-0528 本体,超越原版 Qwen3-8B 达 10 个百分点,成绩与 Qwen3-235B 相当。
幻觉率减半,新增工具调用支持
新版模型针对"幻觉"问题进行了优化。在改写润色、总结摘要、阅读理解等场景中,幻觉率较旧版降低 45% 至 50%。
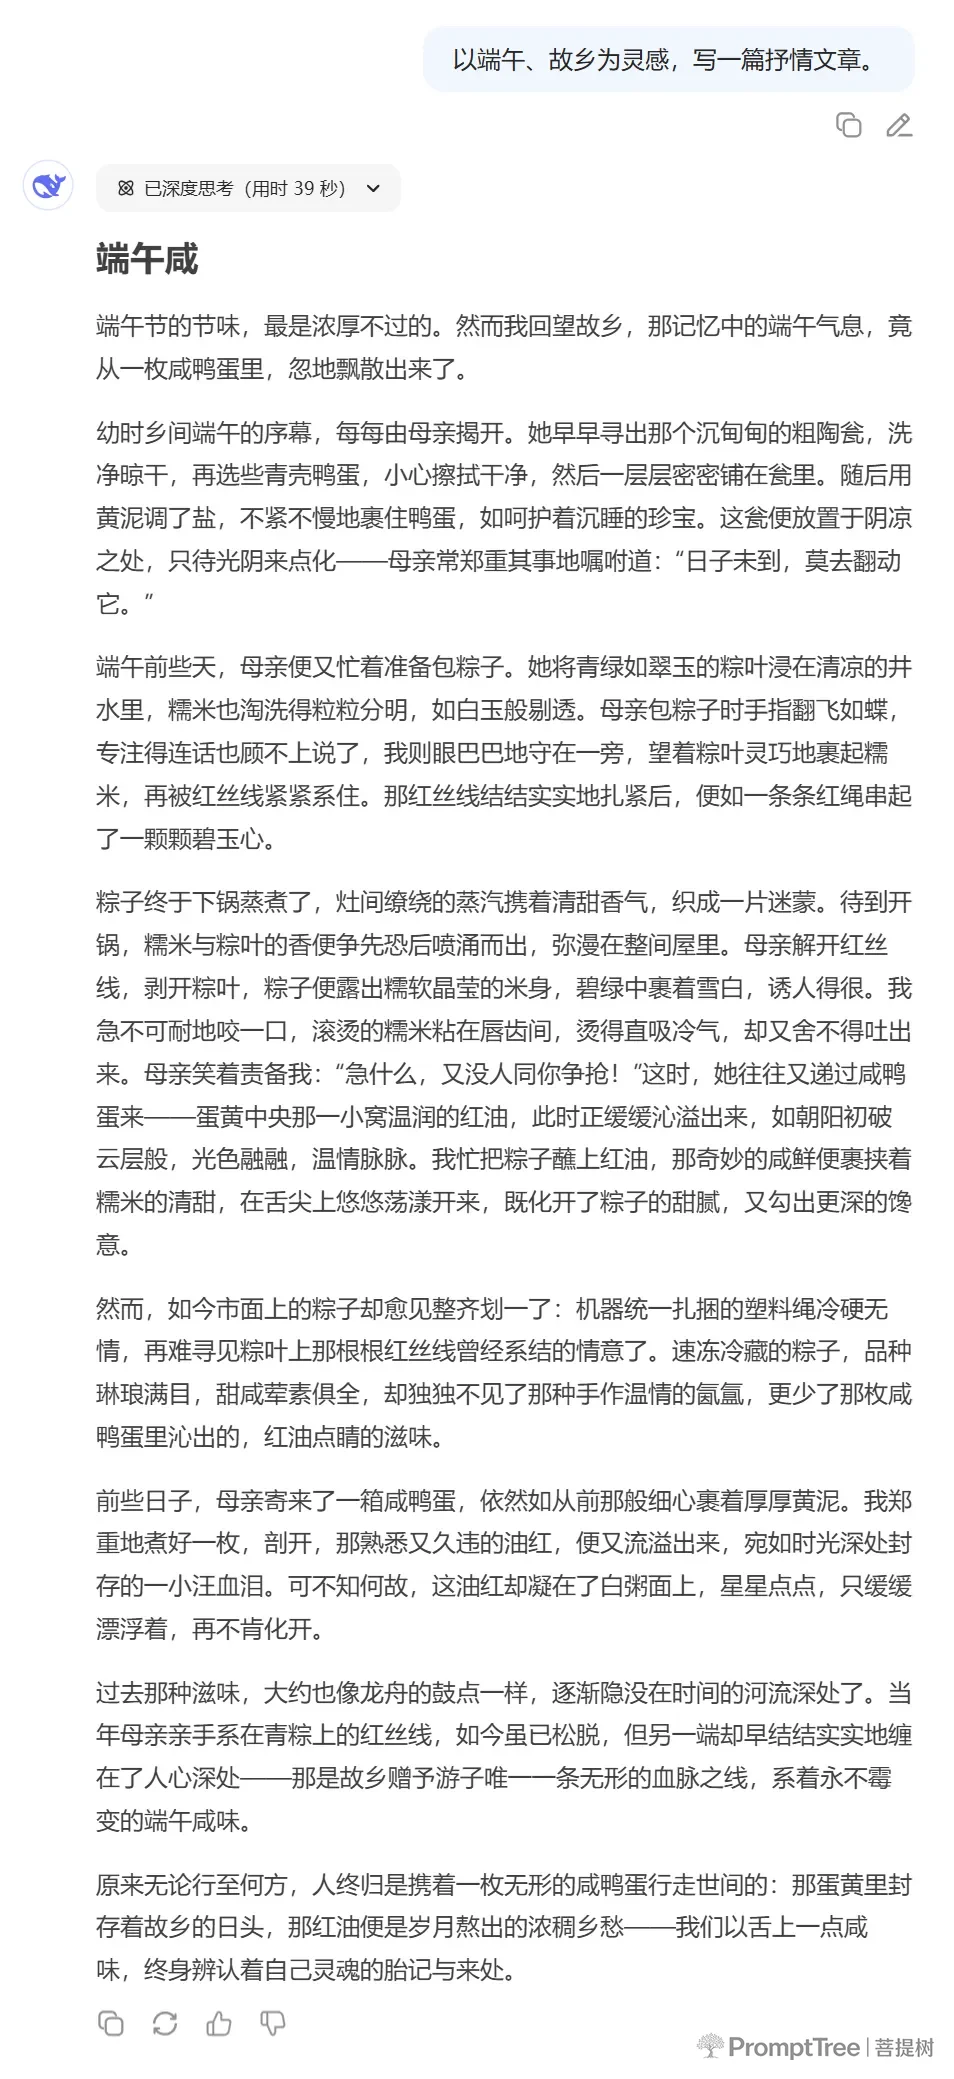
创意写作方面,R1-0528 对议论文、小说、散文等文体进一步优化,可输出篇幅更长、结构更完整的长篇作品,写作风格也更贴近人类偏好。
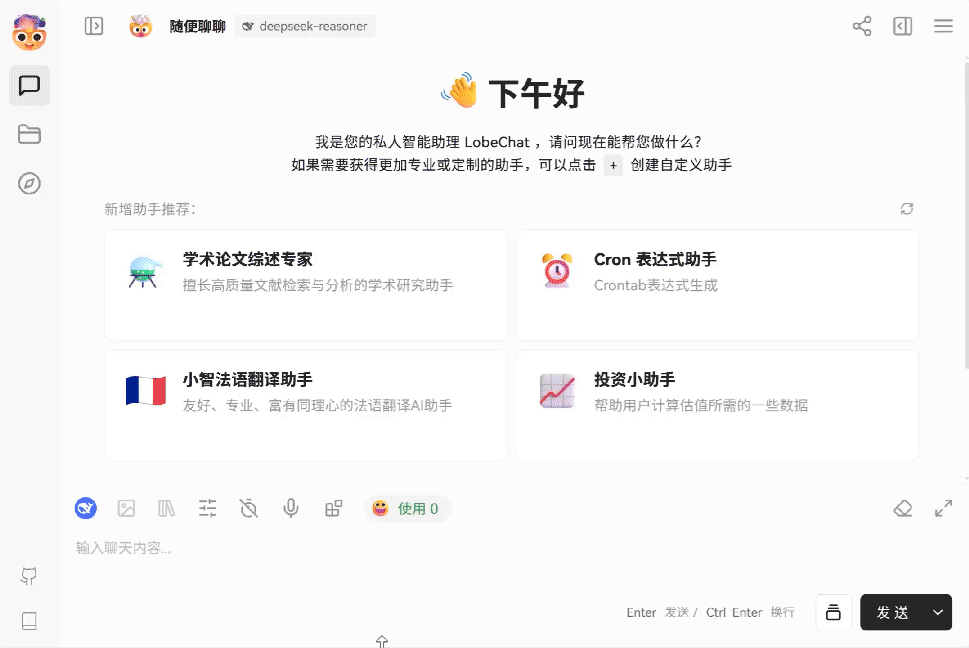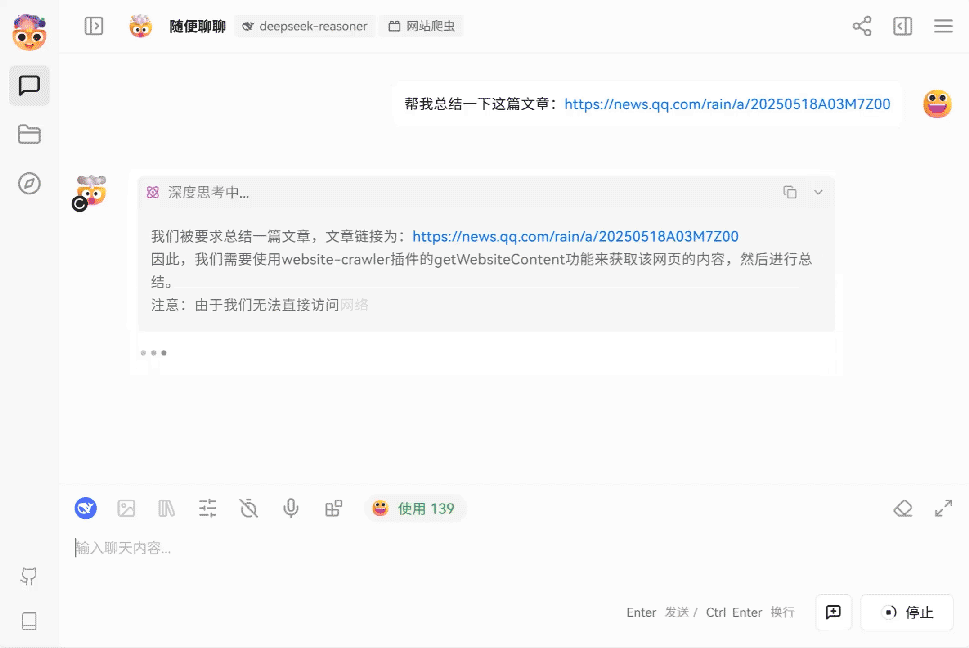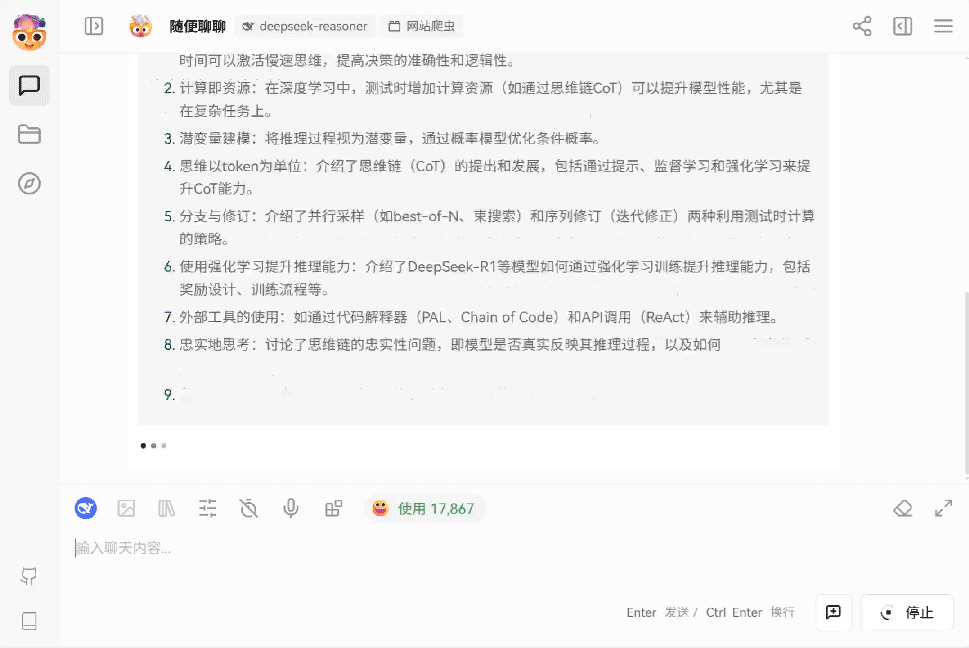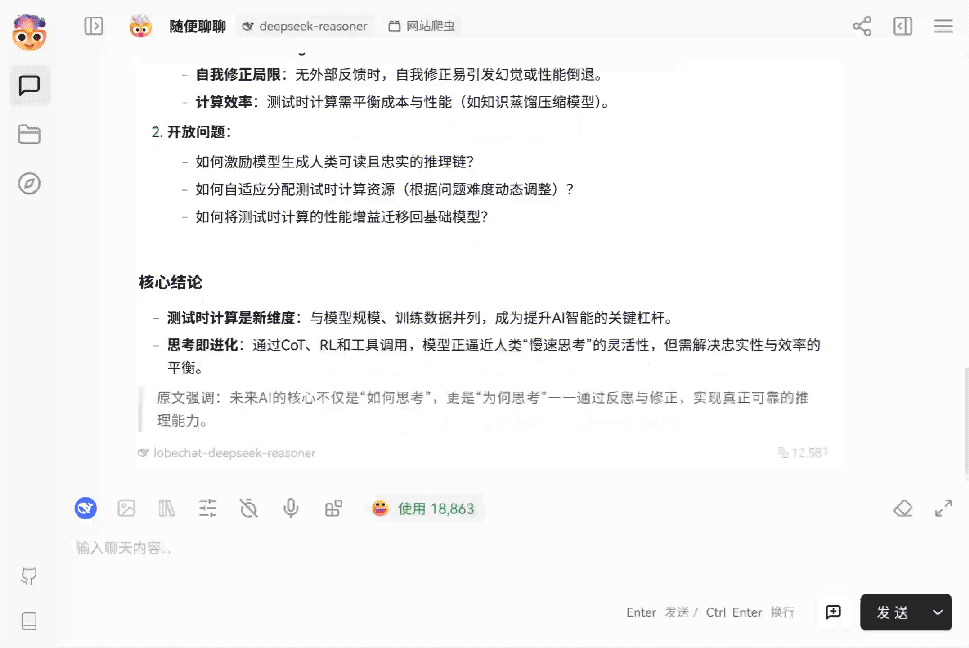
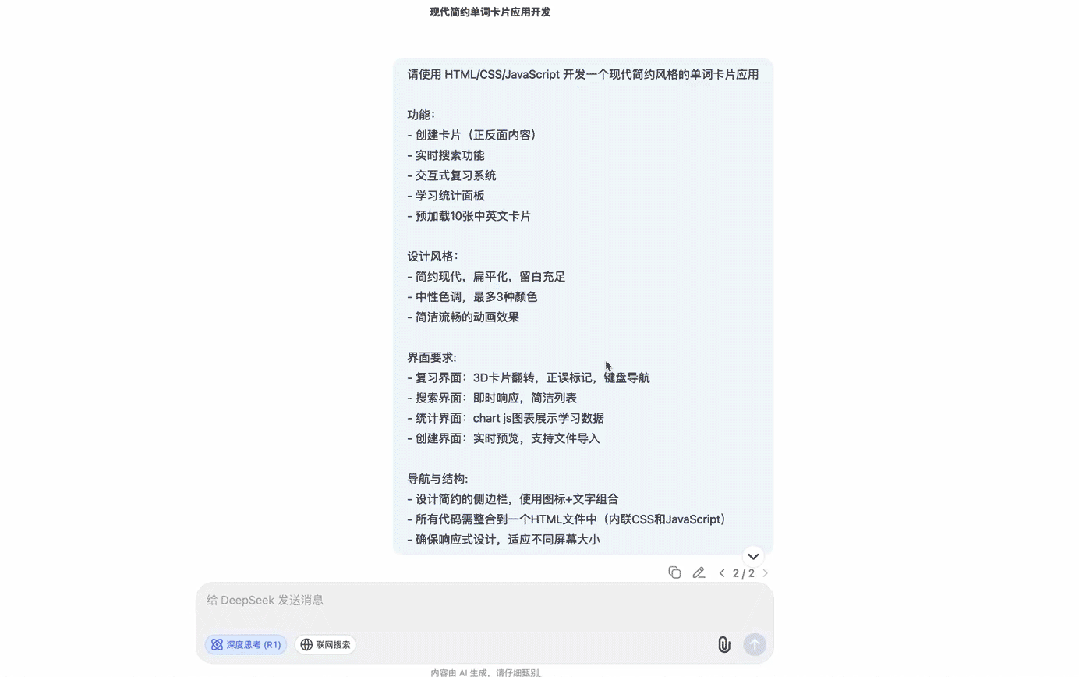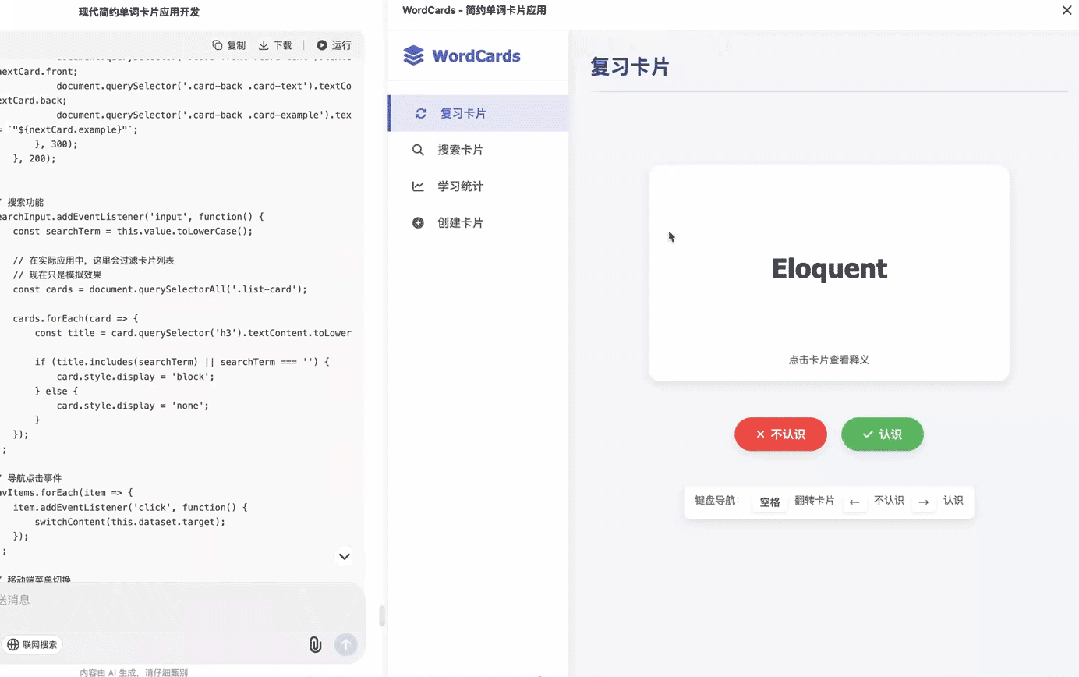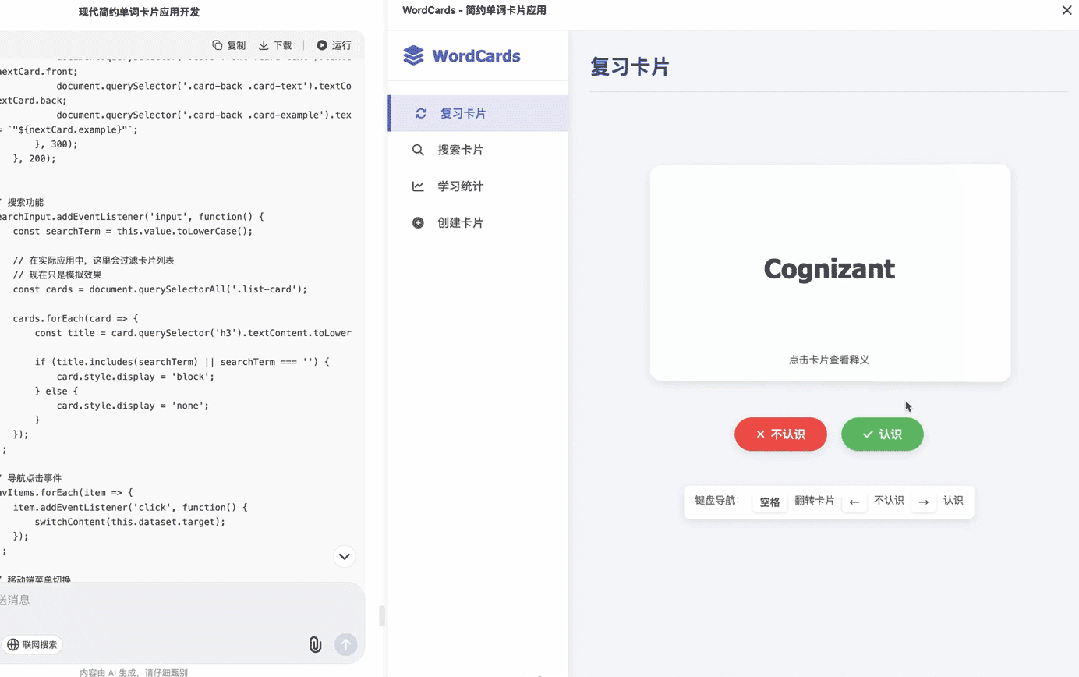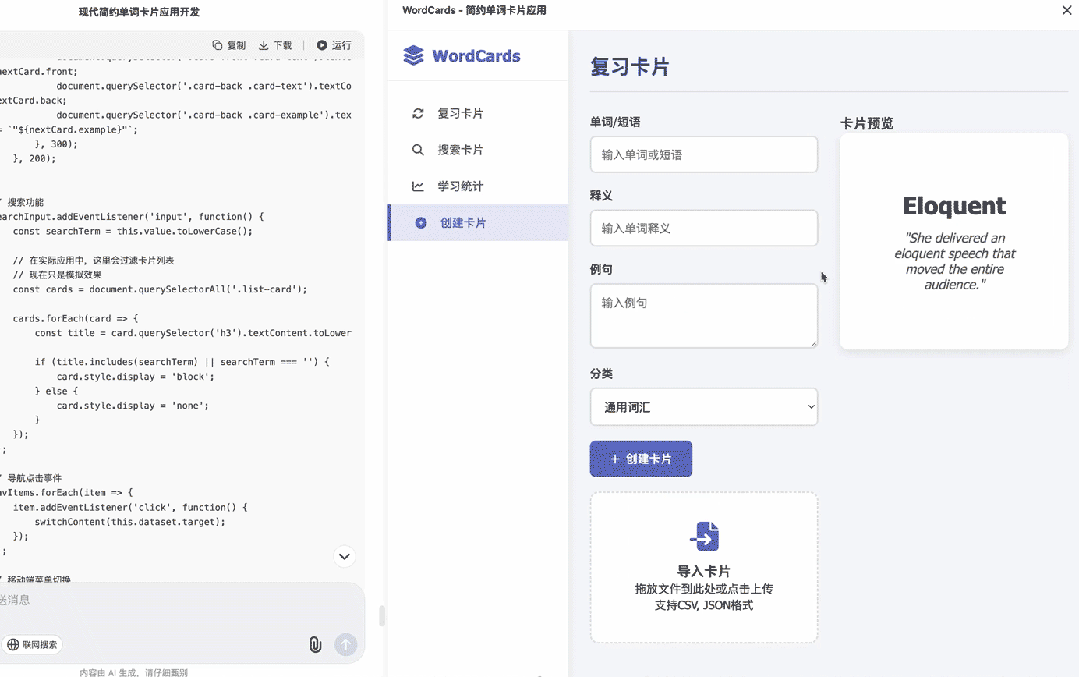
工具调用功能为本次新增。R1-0528 支持工具调用,但不支持在 thinking 过程中调用。其在 Tau-Bench 测评中取得 airline 53.5%、retail 63.9% 的成绩,与 OpenAI o1-high 相当,但落后于 o3-High 及 Claude 4 Sonnet。此外,前端代码生成、角色扮演等领域的能力也有更新。
API 调整 max_tokens 含义,上下文长度维持 64K
API 接口与调用方式保持不变,仍支持查看模型思考过程,新增 Function Calling 和 JsonOutput 支持。
此次更新调整了 max_tokens 参数的含义:该参数现用于限制模型单次输出的总长度(含思考过程),默认 32K,上限 64K。DeepSeek 提示 API 用户及时调整参数,避免输出被提前截断。
官方网站、小程序、App 端和 API 的模型上下文长度仍为 64K。如需更长上下文,用户可通过第三方平台调用上下文长度为 128K 的开源版本。
685B 参数模型开源,沿用 MIT 协议
R1-0528 与此前版本使用同样的 base 模型,仅改进了后训练方法。私有化部署时只需更新 checkpoint 和 tokenizer_config.json(涉及 tool calls 相关变动)。模型参数规模为 685B,其中 14B 为 MTP 层;开源版本上下文长度 128K。
模型权重已上架 Model Scope 和 Hugging Face,开源仓库(含模型权重)沿用 MIT License,允许用户利用模型输出、通过蒸馏等方式训练其他模型。