DeepSeek发布V3.2正式版:推理能力对标GPT-5,首推思考模式工具调用
声明:文档由AI根据原文生成。
双版本正式亮相
2025年12月1日,DeepSeek发布DeepSeek-V3.2与DeepSeek-V3.2-Speciale两个正式版模型。官方网页端、App及API已全面切换至DeepSeek-V3.2,V3.2-Speciale则以临时API形式向社区开放评测。同期发布的技术报告可通过ModelScope下载。
两个月前推出的实验版本DeepSeek-V3.2-Exp已获大量用户反馈。DeepSeek表示,目前未发现V3.2-Exp在任何场景中明显弱于V3.1-Terminus,验证了DSA稀疏注意力机制的有效性。
推理性能:标准版对标GPT-5,Speciale版夺四金
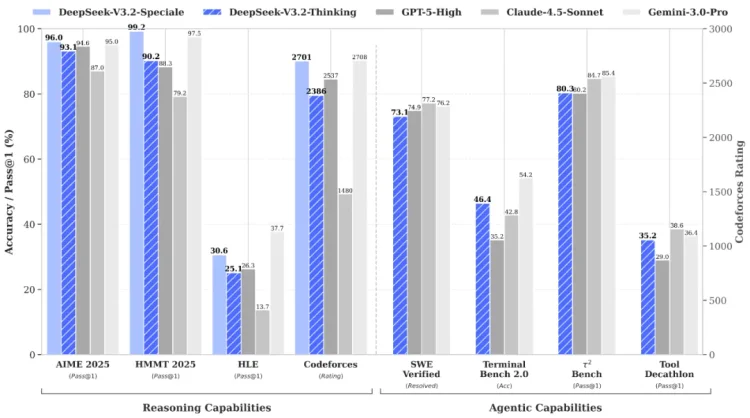
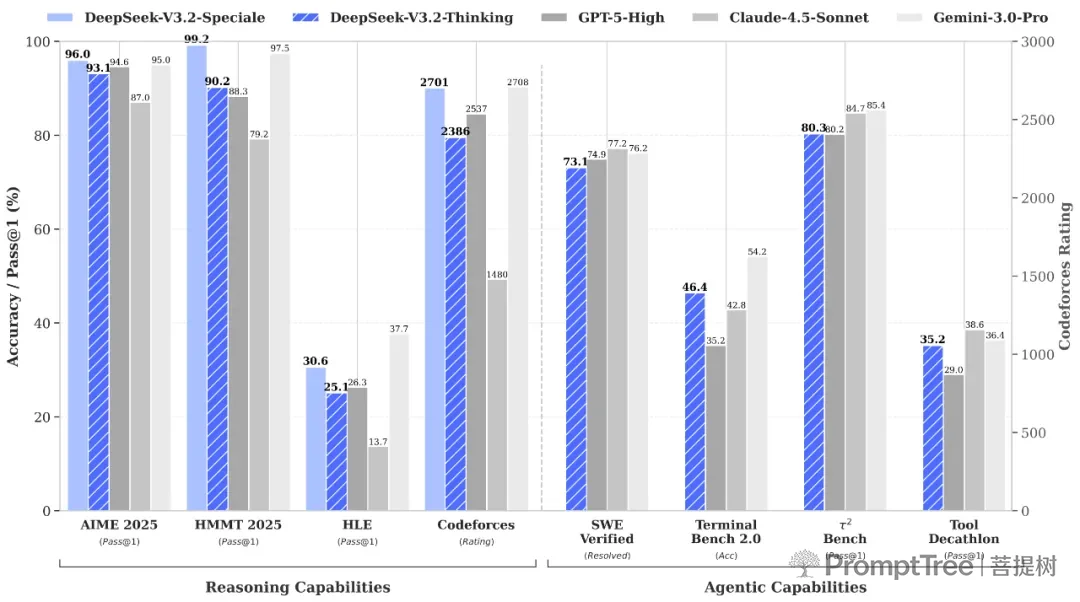
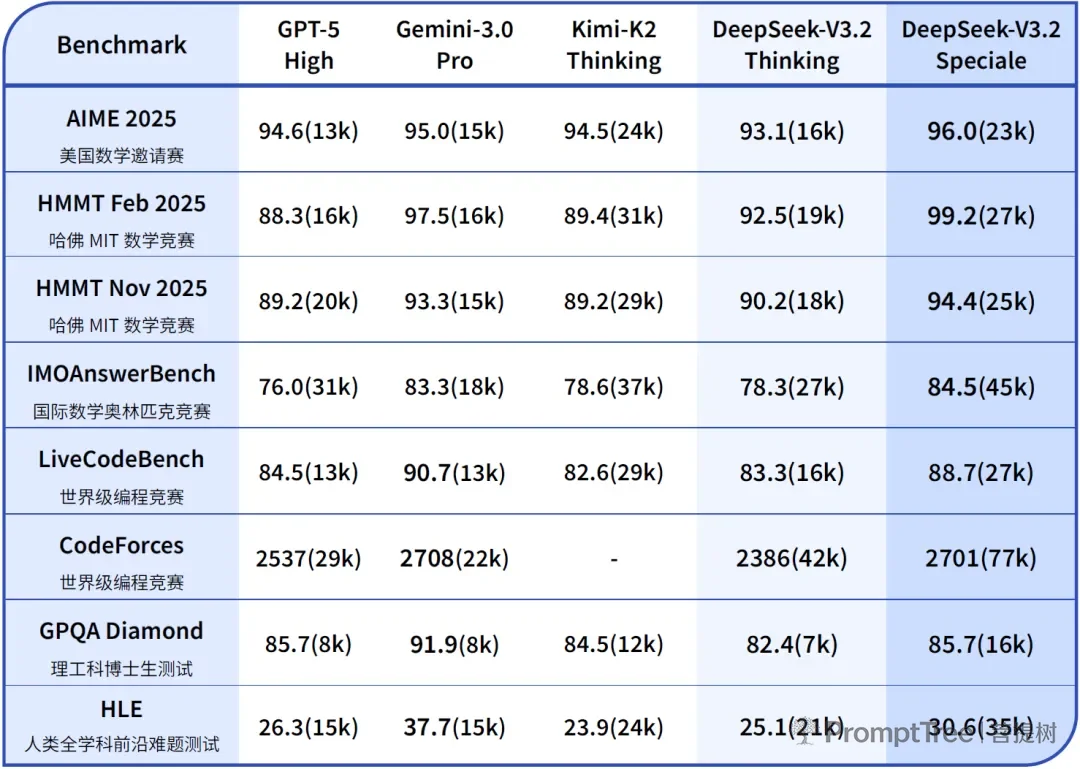
DeepSeek-V3.2定位日常通用,在公开推理基准测试中达到GPT-5水平,略低于Gemini-3.0-Pro;相比Kimi-K2-Thinking,输出长度大幅降低,计算开销与等待时间随之减少。
V3.2-Speciale为长思考增强版,融合DeepSeek-Math-V2的定理证明能力,侧重探索模型能力边界。该模型在主流推理基准上性能比肩Gemini-3.0-Pro,并一举夺得IMO 2025、CMO 2025、ICPC World Finals 2025及IOI 2025四项金牌。其中ICPC成绩达人类选手第二名水平,IOI达第十名。
DeepSeek提示,Speciale版本在高度复杂任务上优势突出,但Token消耗与成本显著更高,目前仅供研究使用,不支持工具调用,也未针对日常对话优化。
首次实现思考模式工具调用
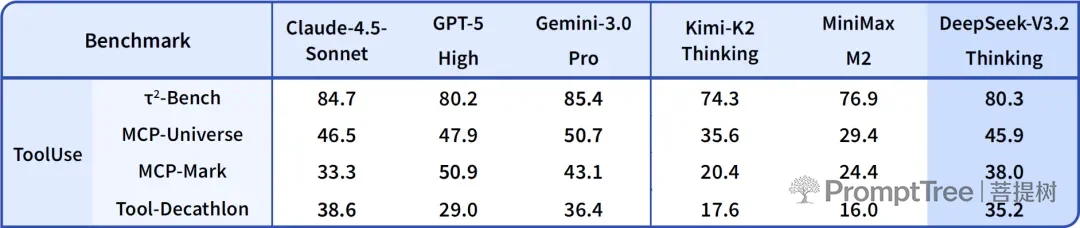
过往版本在思考模式下无法调用工具,DeepSeek-V3.2打破了这一限制,同时支持思考与非思考两种模式的工具调用。团队提出大规模Agent训练数据合成方法,构建1800余个环境、85000余条复杂指令,形成"难解答、易验证"的强化学习任务,以提升泛化能力。
评测显示,V3.2在智能体工具调用测试中达到当前开源模型最高水平,与闭源模型的差距大幅缩小。DeepSeek强调,该模型未针对测试集工具做特殊训练,真实场景中的泛化性值得期待。
开源与获取方式
两个模型均已开源:
- DeepSeek-V3.2:HuggingFace、ModelScope
- DeepSeek-V3.2-Speciale:HuggingFace、ModelScope
API方面,V3.2已全面替换实验版本,使用方式不变。V3.2-Speciale的临时API需设置base_url="https://api.deepseek.com/v3.2_speciale_expires_on_20251215"访问,价格不变,仅支持思考模式对话,最大输出128K,服务有效期至北京时间2025年12月15日23:59。
API使用要点
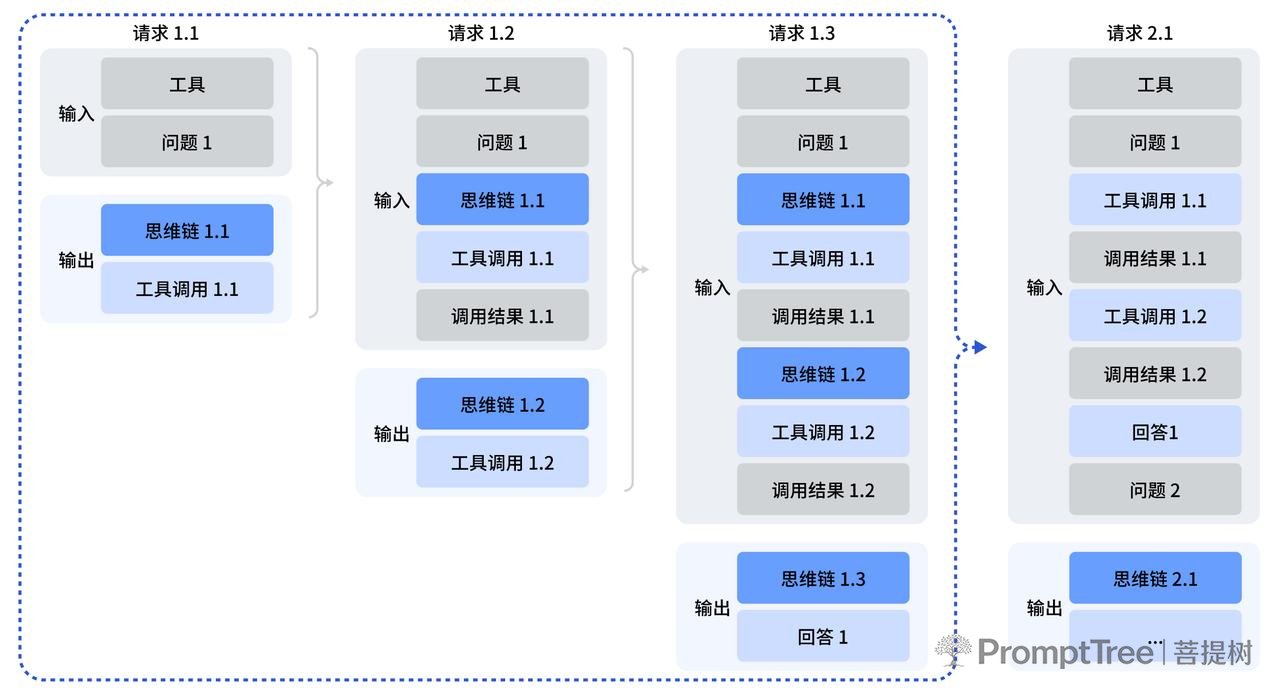
思考模式下,模型可经多轮思考与工具调用后输出结果,用户需回传思维链内容(reasoning_content)供模型持续推理;新提问开始时须删除前序思维链,保留其余内容发送。
V3.2思考模式新增Claude Code支持,用户可将模型名改为deepseek-reasoner,或在Claude Code CLI中按Tab键开启。由于未充分适配Cline、RooCode等非标准工具调用组件,使用此类工具时建议保持非思考模式。详细用法可参考思考模式指南。