DeepSeek 上线 V4-Flash-Vision-Exp 多模态模型,API 支持图文混合输入
声明:文档由AI根据原文生成。
模型上线与核心定位
2026 年 8 月 21 日,DeepSeek 在 API 平台上线实验性多模态视觉理解模型 V4-Flash-Vision-Exp。用户通过设置 model='deepseek-v4-flash-vision-exp' 即可调用该模型。
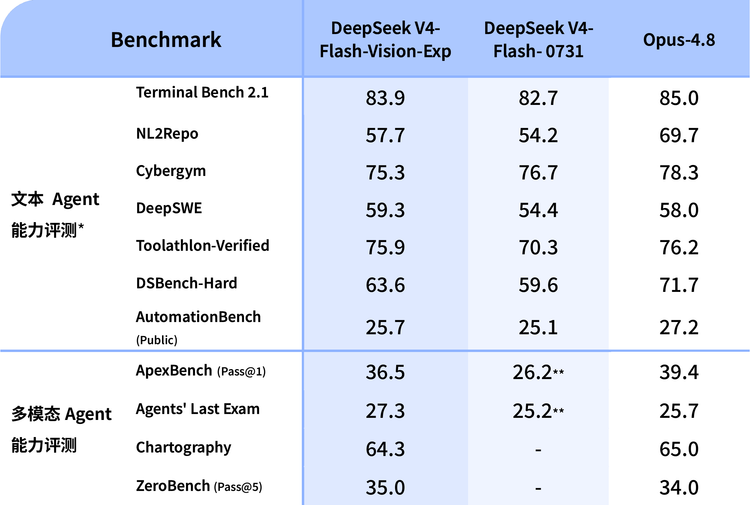
该模型在纯文本能力方面与 DeepSeek-V4-Flash 正式版持平,涵盖 Agent、推理、世界知识等任务。在需要视觉理解的 Agent Benchmark 测评中,V4-Flash-Vision-Exp 相比 V4-Flash 实现大幅提升,多模态 Agent 能力已接近 Opus-4.8 水平。
多模态 Agent 应用场景
V4-Flash-Vision-Exp 在各类 Agent 框架中展现出较好的多模态适配能力。官方提供了三个应用示例:
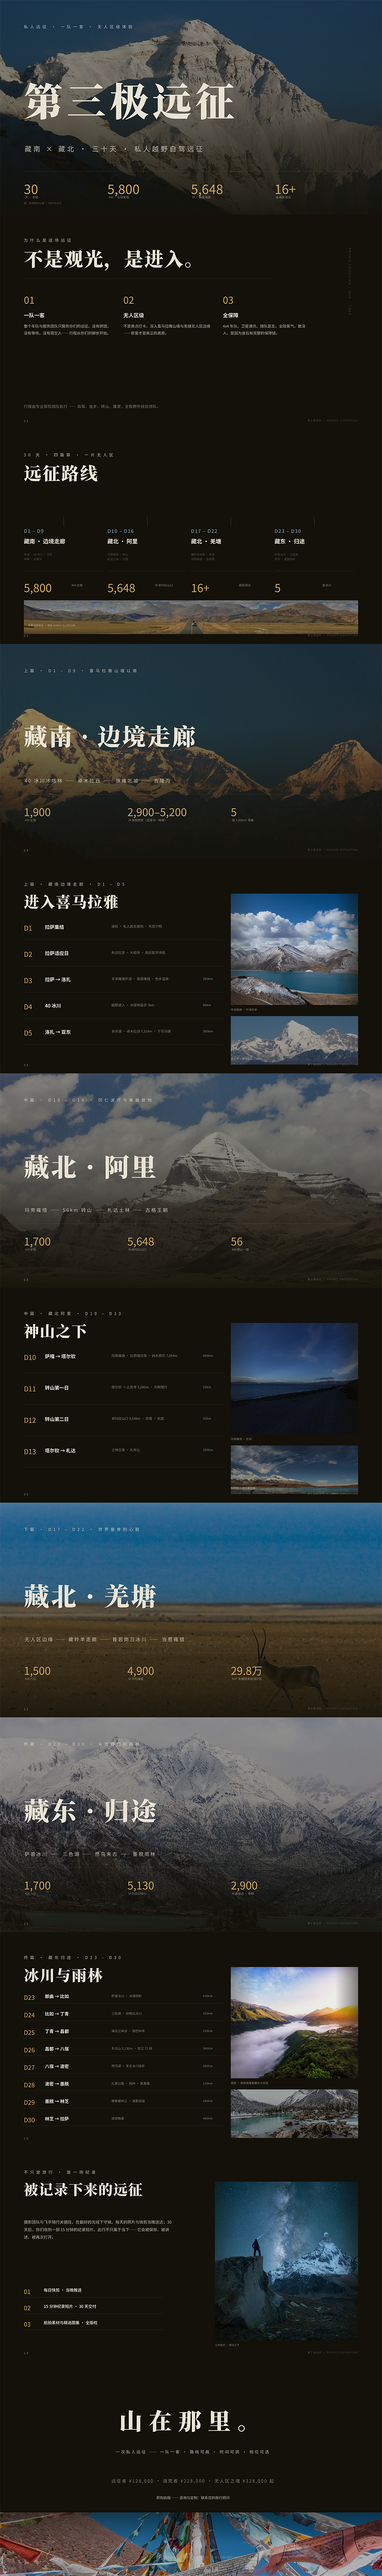
一是生成商业定制西藏自驾游 PPT。模型根据「野性、原始、探索感」的调性要求,输出面向高净值客户的高端定制游方案,包含三种真实定价,配图采用真实摄影风格。
二是对 DeepSeek Harness 官网进行二次创作,以黑蓝深海、玻璃 UI 和 ASCII 原子像素为视觉要素,经多轮交互重构为 future 主义风格开发者网站。
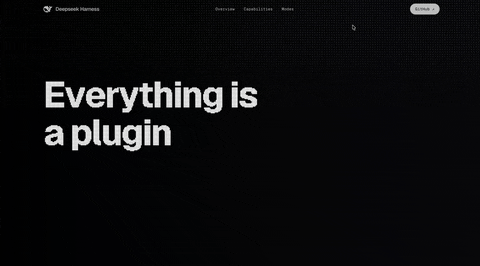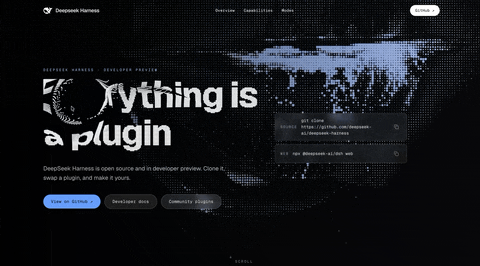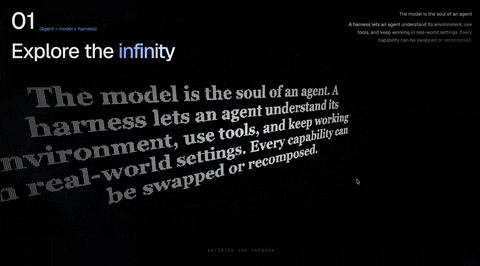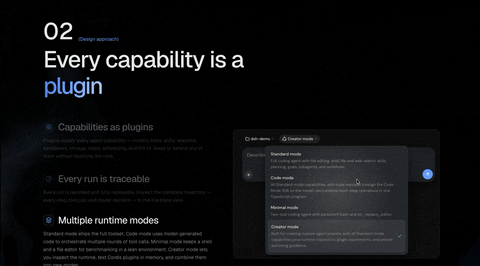
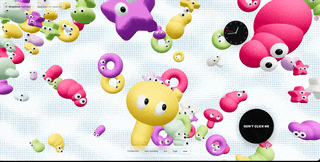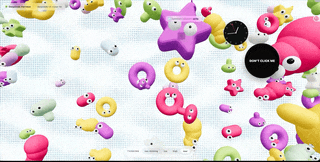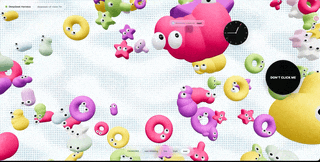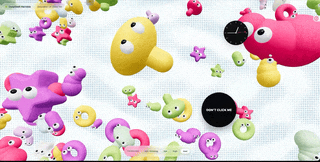
三是制作黏土怪物风格动态特效的前端 Mini Demo,基于「3D 黏土小怪物加入复古舞池派对」的灵感进行创作。
API 调用方式与计费
V4-Flash-Vision-Exp 支持 Chat Completions、Messages、Responses 三种 API 格式调用,可接入各类 Agent 工具。接口支持图文混合输入,图片可通过 base64 内联、外部 URL、Files API 三种方式传入。图片转换为 token 后计费,单张图片上限 384 tokens,价格与 V4-Flash 模型一致。
Files API 现已同步开放,不额外收费。用户可先将图片上传平台获取 file_id,再在请求中引用,同一张图片多次调用无需重复上传,可节省请求带宽。具体使用说明见官方 API 文档。