DeepSeek 发布 V4.1 Flash 模型:552B 参数 MoE 架构,推理成本降至新低
声明:文档由AI根据原文生成。
新模型上线:更小激活、更大智能
2026 年 9 月 10 日,DeepSeek 正式发布 V4.1 Flash 模型。这是其全新模型结构系列中尺寸最小的版本,具备原生多模态视觉理解能力。新结构的设计方向为提升能力上限、加快推理速度、扩大吞吐量,并向更大参数规模扩展。
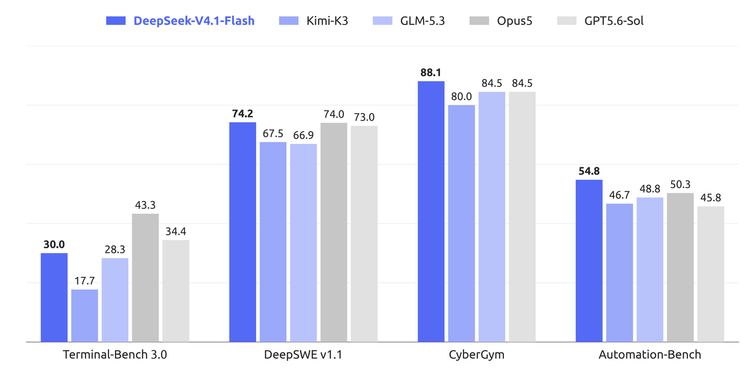
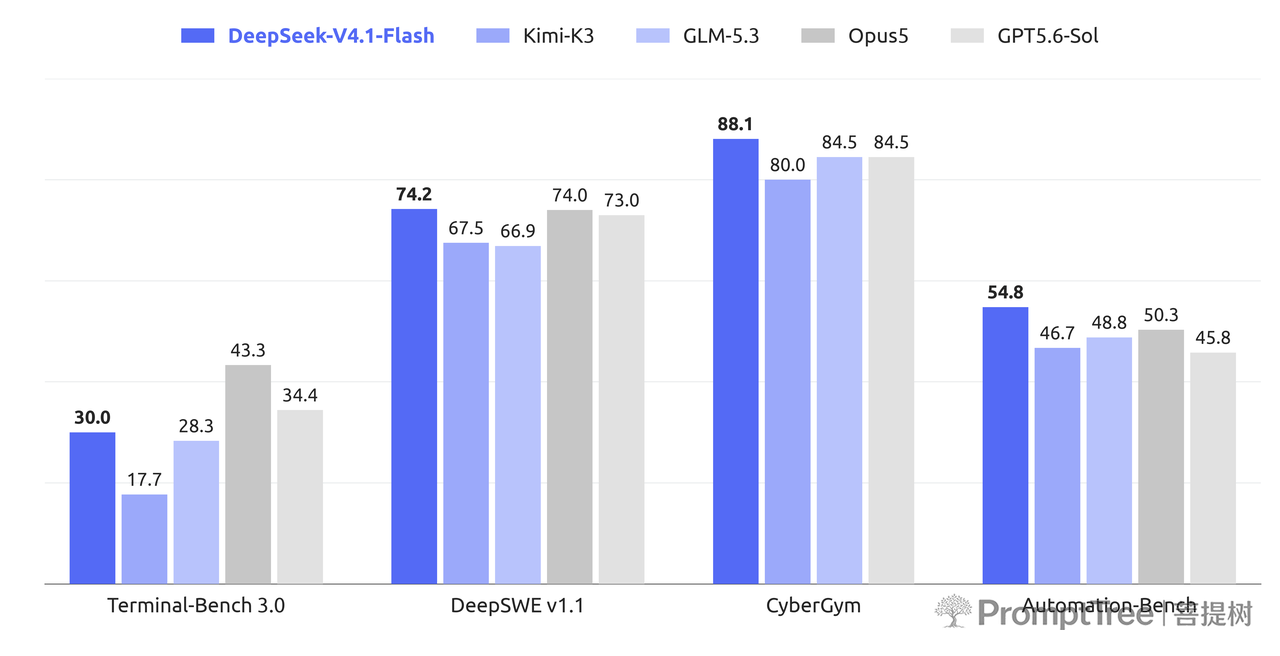
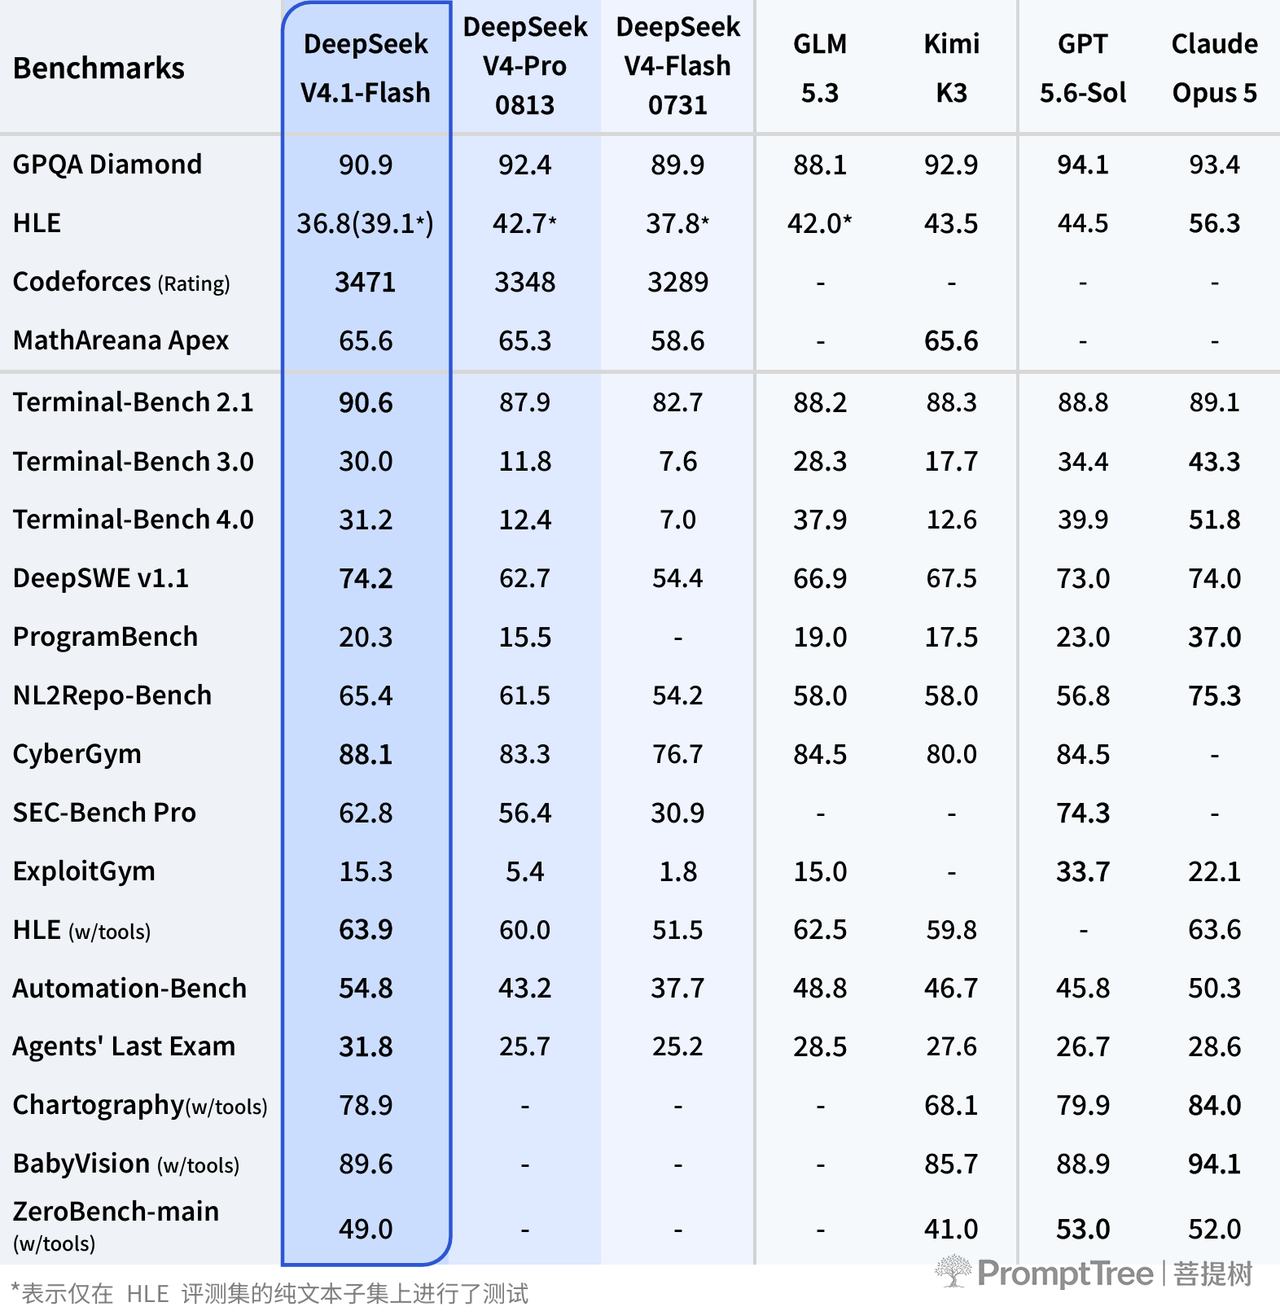
V4.1 Flash 为 552B 参数的 MoE(混合专家)模型,采用 Causal-Encoder-Decoder 结构,输入与输出不对称:输入激活仅 8B,输出激活 16B。DeepSeek 表示,这一设计使其成本显著低于同尺寸模型。该模型经过新的预训练方式与更大规模的强化学习后训练,在基准测试中超越了包括 DeepSeek V4 Pro 在内的多款旗舰模型。
KV Cache 大幅压缩,Agent 场景成本下降
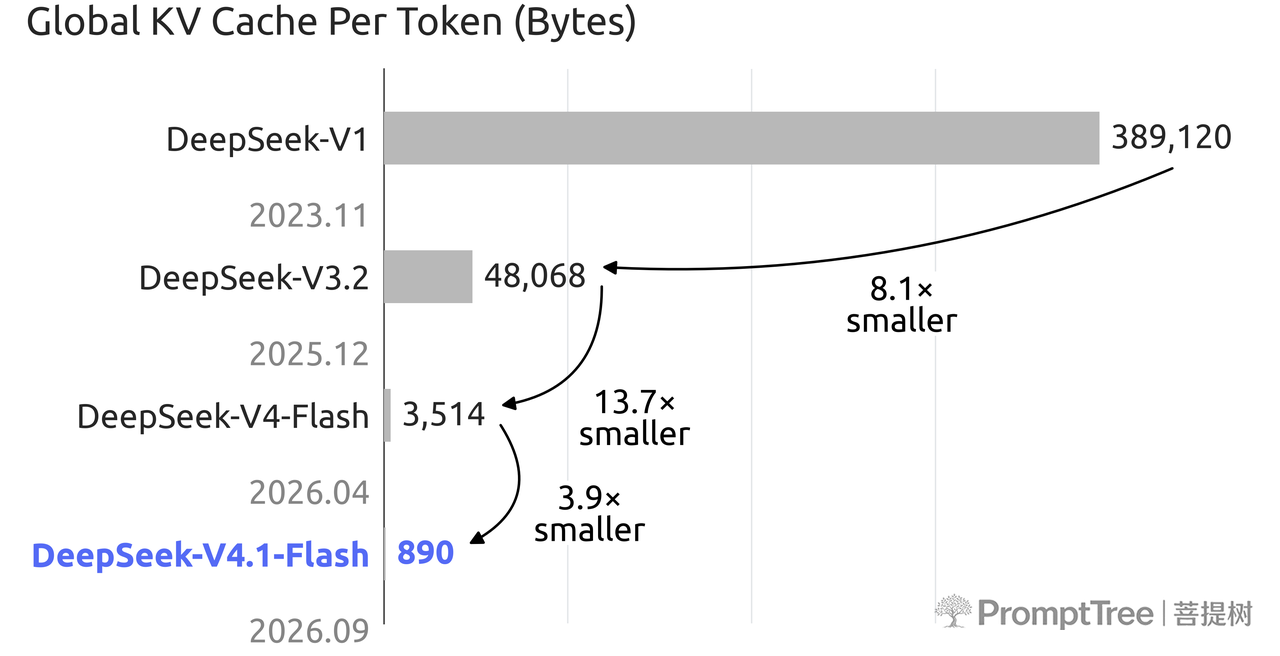
新一代模型将 KV Cache 缓存规模大幅缩减。与上一代相比,对 HBM 的需求降至 1/4,对 SSD 的需求降至 1/8。DeepSeek 指出,在 Agent 使用场景中,缓存命中费用占比较高,KV Cache 的压缩直接降低了此类任务的使用成本。相对于初代模型,KV Cache 整体已缩小 437 倍。
API 同步开放,旧版模型逐步下线
V4.1 Flash 已同步接入 DeepSeek API,用户将模型名称改为 deepseek-flash 即可调用。旧版本 V4 Flash 与 V4 Flash Vision Exp 已下线,模型名 deepseek-v4-flash、deepseek-v4-flash-vision-exp 暂时路由至 V4.1 Flash。
经多方测试,V4.1 Flash 在性能、费用、速度、总用时等指标上已全面超越 V4 Pro。DeepSeek 计划有序下线 V4 Pro 模型,2026 年 9 月 14 日 12:00 起至 V4.1 Pro 上线前,访问 deepseek-v4-pro 的请求将全部路由至 V4.1 Flash,并按 V4.1 Flash 单价计费。
腾讯(WorkBuddy、CodeBuddy)与 OpenCode 作为官方合作伙伴,已全量接入 V4.1 Flash。
定价下调,峰谷机制保留
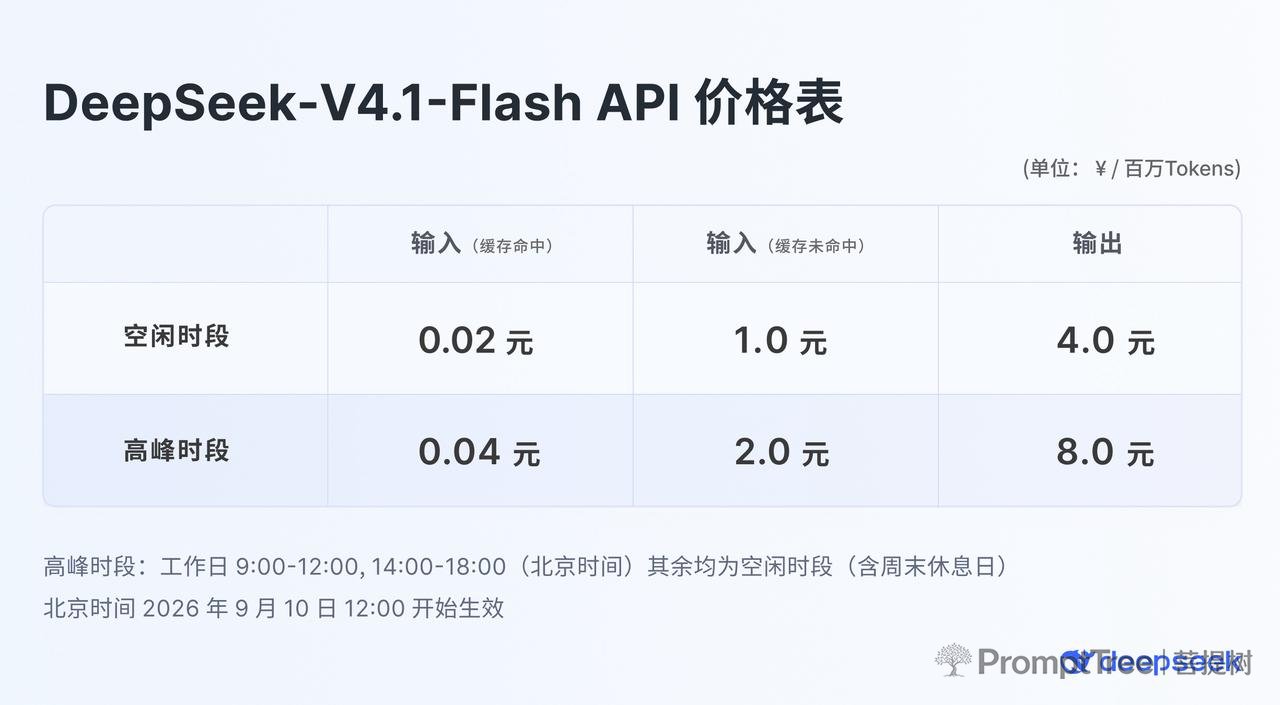
得益于架构创新,V4.1 Flash 的服务成本进一步降低,DeepSeek 相应下调了该模型的 API 定价,同时保留峰谷定价机制:闲时价格为高峰时段的一半。新价格于 2026 年 9 月 10 日 12:00 生效。
模型开源与大规模部署
DeepSeek 表示将支持开源社区进行推理适配,并扩大部署范围。具备 2000 卡 GPU 及存储集群资源的大规模部署需求方,可直接与其联系。
模型开源地址:<div ://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash>
技术报告地址:<div ://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash/blob/main/DeepSeek_V41_Tech_Report.pdf>