我把活交给 agent 团队跑了几十轮,才懂可持续交付为什么更贵了
今年上半年有件事挺魔幻。差不多同一周,Cursor 上了 /multitask,OpenAI Codex 把 subagents 拆成 explorer、worker、default 三个角色,GitHub Copilot 也推了 /fleet。几家的 coding agent 突然都能“派一支小队”出去:一个出方案,一个写实现,一个写测试,一个做 review,在云端各跑各的沙箱,最后把 PR 丢回给你。
我身边不少朋友都尝过这个甜头,把活分出去,自己退到后面做决策。开头是真的爽。
前两天刷到一个开发者写的复盘,一下子把我看清醒了。他夜里派出去十个 agent,早上收回来十个 PR,然后,卡住了。
他卡住不是因为写不完,是收不住。PR 越堆越多,逐行 review 根本读不完,只好降级成粗审:看 diff 行数,看测试过没过,看描述像不像话。一批“看着合理”的代码就这么合进了 main。
真正的麻烦在合进 main 之后。代码库开始生病:重复实现,agent 根本不知道三个月前已经写过同款函数;抽象错位,每个 PR 单独看都最优,合起来却没形状;还有隐性行为改变,边界条件被悄悄改掉,测试也没覆盖到。
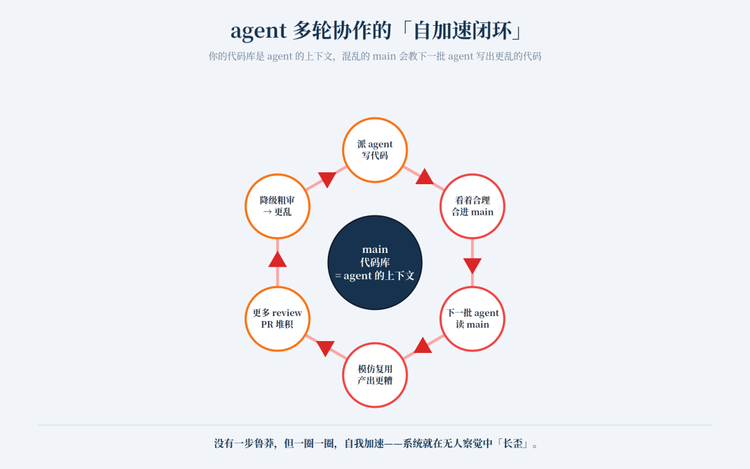
最可怕的是那个闭环。下一批 agent 是读着这份已经变糟的 main 干活的,它们不会像人一样看到烂代码就皱眉绕开,而是把代码库里的一切都当成合理先例,忠实地模仿、复用、跟随。于是产出更糟,需要更多 review,PR 越堆越多。一圈一圈,自己加速。
图1:agent 多轮协作的“自加速闭环”,你的代码库是 agent 的上下文,混乱的 main 会教下一批 agent 写出更乱的代码
这件事让我把之前那篇《AI 把写代码变便宜了,把架构变贵了》又往深想了一层。
单轮分工挺美。等 agent 多轮协作跑起来,写代码被压到接近免费,代价全在另一头:架构主权被一轮轮稀释。每一轮都是局部最优的局部交付,可全局架构的视角,没人替你拿着。
可持续交付的对手,从来不是“写不完”,是“写歪了还停不下来”。JetBrains 给这现象起了个名字,叫 Shadow Tech Debt(影子技术债):agent 改了代码“做什么”,却说不清系统“为什么这么设计”。一个 PR 看不出问题,一天十个,结构就失稳了。
为什么多轮之后一定会跑偏?我琢磨出三件事。
第一,agent 没有演进记忆。 它接的是这一轮的活,不知道三年前为什么这么分、扩展点留给谁。有研究者讲过一种典型的悄悄漂移:某个功能需要别的模块的数据,最快的路径是直接在本地 import,改动通过、测试通过;下一轮 agent 把这个新依赖当成先例,helper 出现了,测试保护它,文档描述它。没有一步看起来鲁莽,可边界已经被挪动了。最危险的是,“例外”会变成仓库里最强的信号,后面所有人都跟着抄。
第二,局部最优不等于全局最优,扩展性是被“顺手改一下”吃光的。 每个 agent 在自己那块干得漂亮,可没人从全局看“这个改动是不是在吃扩展能力”。更糟的是多 agent 同仓协作,技术债会非线性增长:A 在 schema 埋了个架构错误,B 为了对齐加一层 workaround,C 再叠一层。每一个都在补偿上一个的错误,没人去解决根因。
第三,规范会在轮次里退化。 agent 会跳过 ADR、忽略命名约定、复制次优模式,因为那些“为什么这么写”的理由,默认在它的上下文窗口之外。而默契,agent 读不懂。
数据比感受更冷。Faros AI 统计,高 AI 采用团队合并的 PR 多了 98%,可 review 时间涨了 91%,单个 PR 体积涨了 154%。活儿是翻了,review 的负担涨得更狠。daily.dev 的横向测评说,75% 的 AI coding agent 在长期维护里会破坏之前能跑的代码。还有一个叫 SlopCodeBench 的基准,报告 77% 的迭代扩展运行出现了结构性侵蚀。
那落到人身上,该怎么做?
你从“写代码的人”,变成了“架构不漂移的守门人”。定义演进规则,守住扩展点,定期做跨变更的 review:哪些边界在频繁变?哪些例外变成了重复模式?哪些模块在反复吸引重复概念?
有个结论我很认同:review 的带宽是扩不了的,唯一的杠杆是提高“一次做对率”。你每天认真能审三个 PR,想合并六个,出路不是把 review 能力翻倍(那做不到),而是让其中三个不用你认真审,它们的正确性由别的机制保证,你只确认“机制生效了”。这就把 review 从逐行找错,降级成看测试和 PR 描述,确认确实是你要的东西。一个成本随代码量涨,一个几乎是常数。
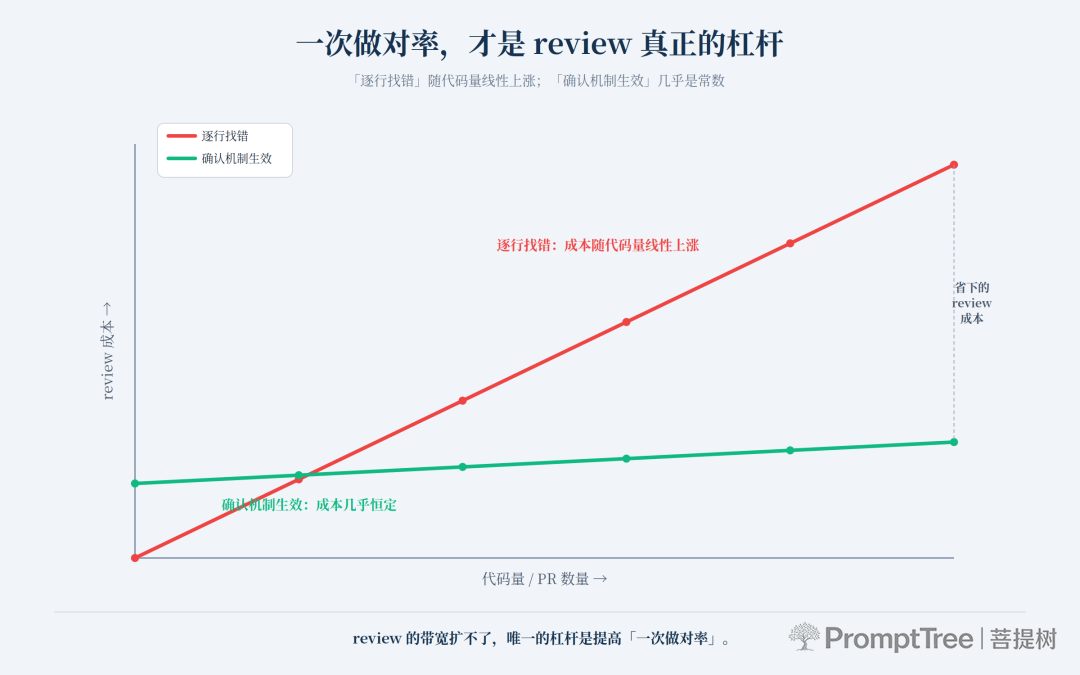
图2:review 成本的两种曲线,“逐行找错”随代码量线性上升,“确认机制生效”几乎是常数
说到底,有句话值得贴在显示器上:Human-owned architecture, AI-powered implementation。人类拥有架构,也就是接口、契约、边界、系统的不变量;AI 拥有边界之内的实现。你定义边界和扩展点的能力,就是可持续交付的能力。
这也正是我反复说的“交付即沉淀”。agent 每轮产出必须沉淀回平台、规范、ADR,否则下一批 agent 又得从零误解。(这也是我在 g2rain 这类平台上一直盯的一件事:让下一轮 agent 站在已经对齐的契约上干活,而不是从一份混乱的 main 重新学起。)能管住漂移的,是机器可读的约束:AGENTS.md 把架构意图写清楚,linter 加结构性测试强制模块边界和依赖方向,再加一道只升不降的“质量棘轮”。这些比换更强的模型更管用。今年有篇论文干脆说:可靠的 AI 辅助开发,本质上是个架构治理问题,不是模型能力问题。
回到开头那句话。AI 是放大器,我之前写过,它放大的是你的架构判断力,多轮之后尤其如此。
写代码免费了,免费的代价是:你必须保证它跑过五十轮之后,还扩得动。
可持续交付,才是 agent 时代架构真正的考题。