Agent 一旦能执行,企业真正缺的是治理平台
一家企业想让 AI 不只是陪聊,而是真去干客服的活:答疑、建工单、派单、把每次解决问题的经验沉淀成知识。他们用 Agent 平台搭了三个专职智能体,跑通了一条"咨询 → 建单 → 派单 → 沉淀"的真实业务链路。
听起来很顺。但先按一下暂停——
这条链路里,每一步都在改系统状态:建工单是写一条记录,派单是改责任人,沉淀知识是发布一篇文章,通知客户是发一条消息。
那我问一句: 这些动作,是谁批准的?
权限从哪来?派错了人怎么兜?知识文章写错了谁能拦?整个过程出错了能回滚、能审计吗?如果智能客服"自信地"建了一张不该建的工单,责任算谁的?
这几个问题,恰恰是企业级 Agent 落地最容易踩空的坑。 Agent 能执行,和它该不该自己拿着执行权,是两件事。
PART 01 一个真实落地的案例:三个智能体协同
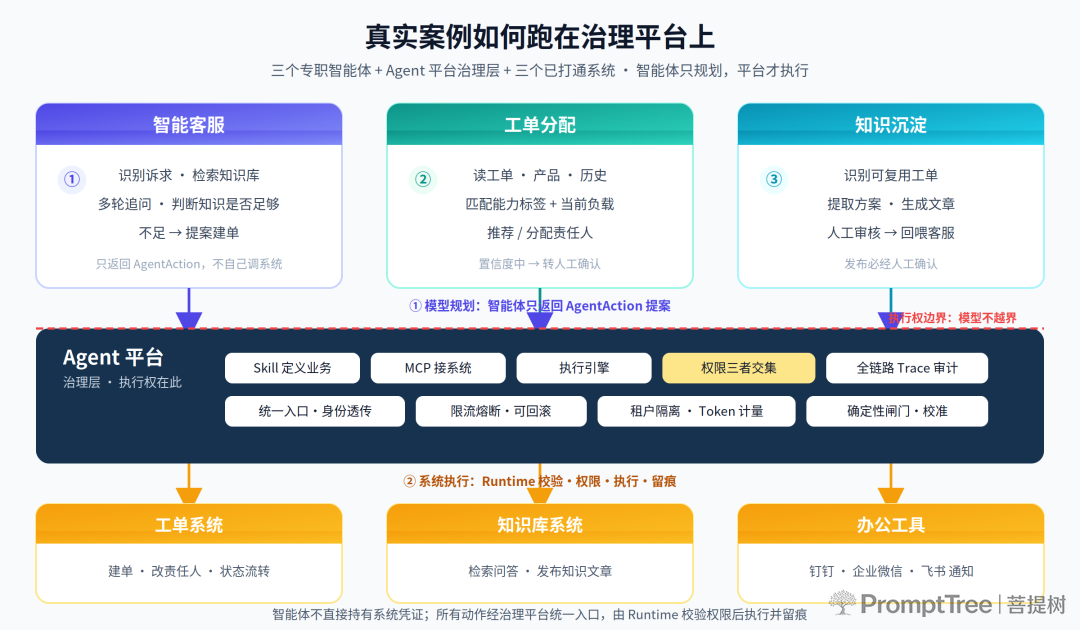
先说清楚我们要讨论的对象。这家企业没有造一个"什么都会"的超级 Agent,而是把业务拆成了三个各管一段的专职智能体,再让它们协同:
| 智能体 | 管什么 | 怎么干活 |
|---|---|---|
| 智能客服 | 答疑与建单 | 识别客户真实诉求、检索知识库、多轮追问、判断知识是否足够;不足时提案建单,把上下文一起带过去 |
| 工单分配 | 派单 | 读工单内容、产品信息、历史记录,对照运维人员的能力标签与当前负载,推荐或直接分配责任人 |
| 知识沉淀 | 把经验变资产 | 识别可复用的工单,提取问题与方案,生成知识文章,经人工审核后发布,回喂给客服 |
底下三个系统已经打通:工单系统、知识库系统、以及常用的办公工具(钉钉 / 企业微信 / 飞书)。新工单一生成,责任人在常用办公工具里即时收到通知。
职责拆定、环节自动流转、接口打通——这已经是"Agent 真能干活"的样子。但"能干活"和"敢让它干",中间还隔着一层东西。
PART 02 在企业里,"执行"意味着什么
很多人以为 Agent 的价值是"能聊天、能写文案"。但在企业里,Agent 真正产生价值的那一刻,是它 改变了某个状态 :
- 调了一个 Tool,查了知识库里有没有现成答案;
- 建了一条工单记录,把客户问题固化进流程;
- 改了工单的责任人字段,把问题指给某个人;
- 发了一条办公工具消息,通知了对应的人;
- 发布了一篇知识文章,写进了公司的知识库。
只要碰了"状态变更",就叫执行。 而一旦开始执行,它就不再是一个只会聊天的模型,而是一个能对公司系统产生实际影响的主体。
这也是为什么个人 AI 和企业级 AI 的分水岭,不在"模型多聪明",而在"执行有没有被管住"。前面那个案例看起来很美,但如果这三个智能体各自拿着 API Key 直接去改系统,风险是同样的。
PART 03 最危险的错觉:把执行权直接交给 Agent
我见过不少 Demo,做法很诱人:给 LLM 一把 API Key,让它自己决定调哪个工具、传什么参数、建什么单。
Demo 跑得飞起。但放到企业里,这套架构有三个致命缺口:
第一,没有身份。 是谁在调工单系统?代表哪个部门、哪个应用?系统层面根本不知道,审计无从谈起。
第二,没有边界。 模型今天建工单,明天可能顺手把工单删了、把责任人改成自己。权限不是"模型不想乱来",而是"系统不允许它乱来"。
第三,不可回放、不可回滚。 模型一口气串起"查知识库 → 建单 → 派单 → 发通知"四步,中间哪一步出的错?能不能重放定位?能不能撤销?没有统一的执行记录,全靠祈祷。
⚠️ 注意 :把执行权直接交给模型,等于把公司印章交给一个没有身份证、没有权限卡、不写工作日志、还无法召回的实习生。它干得越顺,风险敞口越大。
PART 04 正确的关系:模型规划,系统执行
在 Agent 平台里,我们守一条铁律—— 模型规划,系统执行。
模型的职责只有一个:根据当前上下文,返回一个 结构化的动作提案 。我们把这个提案定义成一套统一协议 AgentAction ,常见几类:
| 动作 | 含义 |
|---|---|
CALL_TOOL | 调用某个 Tool 完成一步操作(如建工单、发通知) |
REQUEST_CONFIRMATION | 这一步需要人确认,先停下 |
RETRIEVE | 检索更多上下文再决策(如查知识库) |
PATCH_CONTEXT | 更新结构化上下文 |
回到案例:智能客服判断"现有知识不足以解决",它 不会自己直接去工单系统建单 ,而是提案一个 CALL_TOOL (或 REQUEST_CONFIRMATION )——"建议建单,上下文已就绪"。真正的动作,要由平台的 Runtime 收回去,做三件事:
- 校验合法性 :这个动作在不在 Agent 的能力范围内?参数 Schema 对不对?(比如建单必填的客户信息齐不齐)
- 校验权限 :当前用户、当前 Agent、当前 Skill 是否都允许这一步?
- 执行并留痕 :通过才真正调用工单系统,每一步都写进执行日志与全链路 Trace。
这就把"编排"明确划给了平台—— 编排器(Orchestrator)属于 Runtime,不属于 Agent。 Agent 只提动作、不自己执行、不绕过权限、也不保存会话状态。模型每次规划都是无状态的,状态全在平台手里。
💡 提示 :这条分工还有一个隐藏好处——因为执行权在平台,模型可以随时换。今天用这个推理模型,明天换更强的决策模型,这三个智能体的业务能力一个字都不用改。
PART 05 执行权是怎么被"收编"的:四道闸门
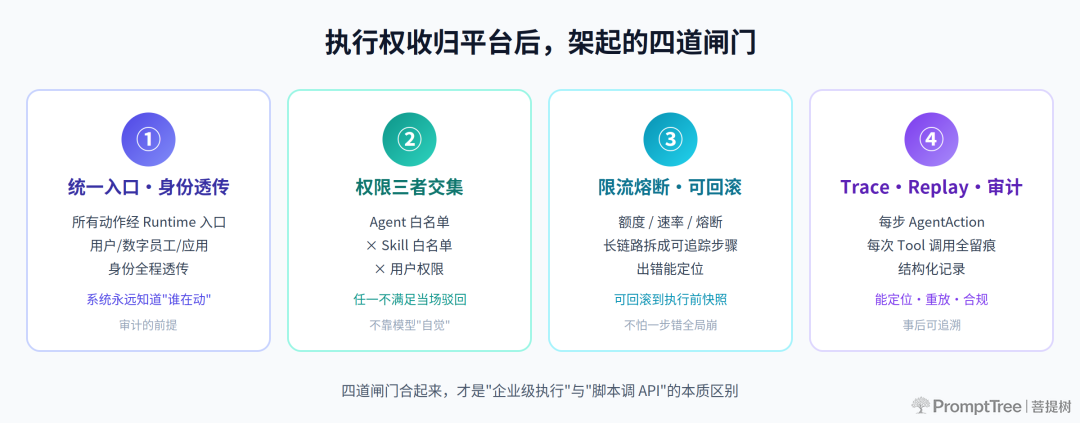
把执行权收回到平台之后,治理平台在每一次动作上都架了闸门。我们用案例拆成四道:
① 统一入口与身份透传 所有动作必须经 Runtime 统一入口。智能客服建单、工单分配改责任人、知识沉淀发布文章——调用方身份(用户 / 数字员工 / 应用)全程透传。系统永远知道"是谁在动",这是审计的前提。
② 权限三者交集 一个智能体能不能执行某一步,不是 Agent 自己说了算,也不是 Skill 写了就行,而是 Agent 白名单 × Skill 白名单 × 用户权限 三者取交集。比如工单分配智能体只能派给它权限范围内的运维人员,越权当场驳回。
③ 限流、熔断与可回滚 Tool 调用有额度、有速率限制、有熔断。更关键的是,长链路执行被拆成可追踪的步骤——"查知识库 → 建单 → 派单 → 发通知"任何一步出错,都能定位、能回滚到执行前的快照。
④ 全链路 Trace / Replay / 审计 从一句客户咨询,到每一步 AgentAction、每一次 Tool 调用、每一个返回,全部结构化留痕。事后能 Trace 定位,能 Replay 重放,能审计合规。案例里特别强调"运行过程全程可查",底气就来自这一道。
这四道闸门合起来,才是"企业级执行"和"脚本调用 API"的本质区别。
PART 06 上下文的边界:模型能推断,但不能写事实
这里有个常被忽视的治理细节—— 执行所依赖的上下文(Context),必须是结构化对象,不能是模型自己编的一段话。
规定:模型的推断只能写进 assumptions (假设), 不能写进 facts (事实) 。
这个细节在案例里格外关键。智能客服建单时,要把"客户信息、问题描述、对话过程、已尝试的处理方式"一起带过去,让客户不用退出会话、不用重讲一遍。注意——这些信息必须是 从对话和系统真实取回的 facts ,而不是模型"推测客户大概是这样"。一旦允许模型把"我推测客户已购买该产品"当成事实写回上下文,下一步派单就会建立在它自己脑补的基础上,幻觉就这样悄悄渗进了业务系统。事实只能来自 Tool 的真实返回或已校验的数据。
这看着是细节,其实是治理的底线:上下文里哪些是确定的、哪些是猜的,平台要分得清清楚楚。
PART 07 每一次执行,都要过"确定性"这关
如果你看过我们上一篇关于 Jev 的讨论,会记得一个结论: 概率不能由模型自报,必须由平台标定。 这条原则在执行环节同样成立,而且更具体。
平台持有业务阈值,并持续用历史数据做重校准。于是每一步执行都有"确定性闸门":
- 模型提案的置信度足够高 → 平台自动放行;
- 落在中间区间 → REQUEST_CONFIRMATION ,转主管复核;
- 低于阈值 → 直接交人工或升级到更强的模型。
案例里两处正好对应:工单分配智能体"推荐责任人"时,如果匹配置信度中等,就转人工确认,而不是自己拍板派单;知识沉淀生成知识文章后,必须 经人工审核 才发布——关键动作可确认,这正是 REQUEST_CONFIRMATION 的落地形态。
模型负责说"我认为该这么做、有多确定",平台负责决定"到底能不能做"。 执行权,最终解释权在治理平台手里。
PART 08 一条受控链路长什么样
把前面合起来,案例里"客户咨询 → 建单 → 派单 → 沉淀"在 Agent 平台里是这样走的:
- 客户在对话里描述问题,智能客服接收意图,检索知识库。
- 模型判断现有知识不足,提案 CALL_TOOL :建工单,并附带结构化 facts(客户信息、问题描述、对话过程、已尝试方式)。
- 平台校验身份与权限(该 Agent 有建单 Tool、Skill 允许、用户有权限)→ 执行建单 → 结果写回 facts,全程留痕。
- 工单分配智能体读工单内容、产品、历史,提案"推荐责任人 A",附带匹配置信度。置信度中等 → 平台发出 REQUEST_CONFIRMATION 转主管复核。
- 主管确认 → 平台重新校验权限 → 改责任人 → 通过办公工具给 A 发通知。
- 问题解决后,知识沉淀智能体提案"生成知识文章",经 REQUEST_CONFIRMATION 人工审核 → 发布 → 回喂客服知识库。
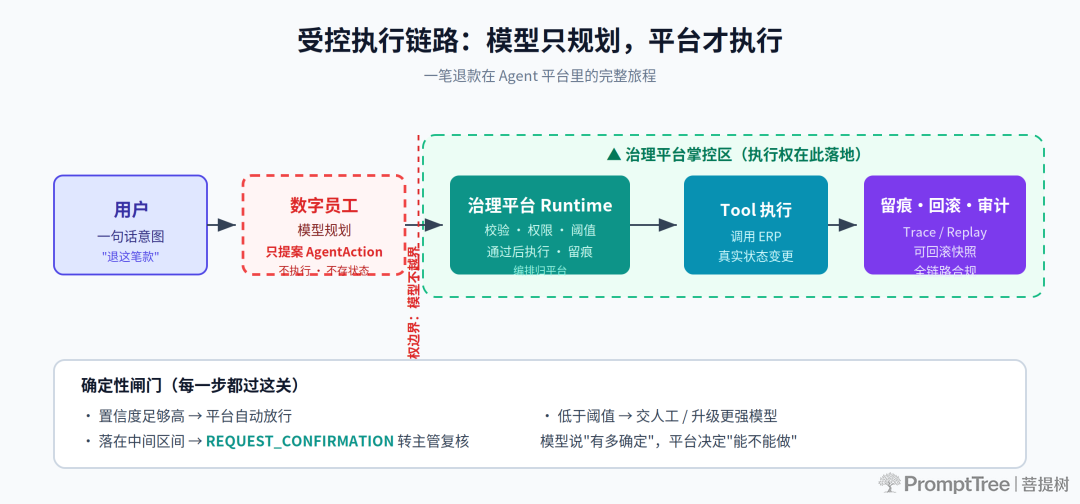
整个过程,模型从头到尾 没有碰过一次执行 。它只负责在每一步给出"做什么、有多确定",而批准、授权、执行、留痕、兜底,全是治理平台的事。
回到最开始。决定这条链路安不安全的,从来不是当天是哪个模型做的判断,而是 有没有一个治理平台在替企业把着关 。
这也是我们在 Agent 平台里把 Token Route 当作核心能力的原因:数字员工不直接绑定某个模型,而是通过统一路由访问模型服务,平台按租户、场景、成本、能力动态选模型,同时统一完成认证、计量、限流、熔断、审计。 模型是可替换的基础设施,而数字员工、Skill 和治理能力,才是企业真正持续积累的资产。
所以,Agent 与企业治理平台的关系,一句话就能说清:
Agent 是执行的主体,治理平台是执行的裁决者、执行者与兜底者。模型负责智能,平台负责可信、安全、治理与责任。
没有治理平台的 Agent,只是一个会干活的实习生;有了治理平台,它才是一个企业真正敢用的数字员工。
我是行者,一个在 AI 时代手搓企业级开源 SaaS 平台的技术理想派。
文中提到的 AgentAction 协议、权限三者交集、全链路 Trace 与概率校准,都在 Agent 平台里跑着。想看看一个开源 SaaS 平台怎么把执行权收进治理平台、怎么让模型变成可替换的基础设施,欢迎来翻代码。